
Разделение времени между задачами
Мультипрограммирование успешно реализовало параллельное выполнение задач, но такой параллелизм не обязательно справедлив. Если процесс долгое время не вызывает операций ввода-вывода, система мультипрограммирования не станет по своей инициативе передавать управление другим процессам, и эти другие процессы так и не получат шанса выполниться.
Представьте: вы играете с друзьями в сетевую игру, и вдруг Windows начинает в фоне автоматическое обновление; товарищи по команде звонят вам и спрашивают, почему вы постоянно отваливаетесь, — вам это точно не понравится. Поэтому системы мультипрограммирования всё же больше подходят для сценариев пакетной обработки: они гарантируют полную загрузку CPU, но не годятся для интерактивных сценариев.
Чтобы использовать систему в интерактивных сценариях, ей нужно с определённой частотой переключаться туда-обратно между всеми процессами, гарантируя каждому процессу своевременный отклик, — это и есть разделение времени между задачами (time-sharing multitasking).
С точки зрения того, что запускает переключение контекста, разделение времени между задачами можно разделить на две категории. Первая — это кооперативная многозадачность (cooperative multitasking), которая работает на основе договорённости: пользовательские процессы периодически сами по своей воле уступают контроль над CPU, тем самым давая шанс выполниться другим процессам. Для этого операционной системе нужен специальный системный вызов — тот самый SYS_yield, который мы реализовали в PA3. Казавшийся в PA3 бесполезным SYS_yield на самом деле — краеугольный камень переключения контекста в операционной системе с кооперативной многозадачностью.
Она называется «кооперативной» именно потому, что этот механизм требует совместного сотрудничества всех процессов — только если все вместе соблюдают эту договорённость, вся система работает корректно. Некоторые простые встраиваемые операционные системы или системы реального времени применяют кооперативную многозадачность, поскольку на них работает всего несколько фиксированных программ, и заставить их всех вместе соблюдать договорённость об уступке CPU не составляет труда.
Но представьте: в многопользовательской операционной системе источник запускаемых программ непредсказуем. Если какой-нибудь вредоносный процесс намеренно не соблюдает эту договорённость и не вызывает SYS_yield, или же случайно попадает в бесконечный цикл, вся система окажется монопольно захвачена этим процессом. Некоторые древние версии Windows как раз использовали проектирование с кооперативной многозадачностью, и операционная система нередко «падала» из-за каких-нибудь багованных программ.
Причина, по которой кооперативная многозадачность сталкивается с такой проблемой, — в том, что система возлагает условие запуска переключения контекста на поведение самого процесса. Мы знаем, что при планировании процесса весь компьютер оказывается под его управлением: и вычисления, и обращения к памяти, и ввод-вывод — всё определяется поведением этого процесса. Чтобы устранить эту уязвимость, нам нужно найти механизм, который процесс не может контролировать.
Голос извне
Вспомните, как мы сдавали экзамены: как отвечать на вопросы в билете, полностью решали мы сами, но стоило прозвенеть звонку — независимо от того, закончили мы отвечать или нет, — билет нужно было сдать немедленно. Именно такого эффекта мы и хотим добиться: когда время вышло, независимо от того, насколько неохотно выполняющийся процесс готов уступить, операционная система обязана произвести переключение контекста.
А ключ к решению этой проблемы — таймер (clock). Мы уже давно добавили таймер в IOE, однако этого пока недостаточно для наших потребностей: мы хотим, чтобы таймер мог сам, по своей инициативе, уведомлять процессор, а не пассивно ждать, пока процессор к нему обратится.
Такой механизм уведомления в компьютерах называется аппаратным прерыванием (hardware interrupt). По сути, аппаратное прерывание — это цифровой сигнал: когда устройству нужно уведомить CPU о каком-то событии, оно посылает сигнал прерывания. Этот сигнал в конечном итоге доходит до CPU и привлекает его внимание.
Первый вопрос — как сигнал прерывания доходит до CPU. У контроллеров устройств, поддерживающих механизм прерываний, есть вывод прерывания, который соединён с выводом INTR процессора; когда устройству нужно выдать запрос прерывания, ему достаточно установить свой вывод прерывания в высокий уровень, и сигнал прерывания будет непрерывно передаваться на вывод INTR процессора. Но на компьютере обычно установлено несколько устройств, а выводы CPU фиксированы ещё при производстве, поэтому выделять на стороне CPU отдельный вывод под каждое устройство-источник прерывания нереалистично.
Чтобы лучше управлять запросами прерываний от различных устройств, все IBM PC-совместимые компьютеры оснащаются Intel 8259 PIC (Programmable Interrupt Controller, программируемый контроллер прерываний), а в системах RISC-V чаще используется контроллер прерываний PLIC (Platform Level Interrupt Controller). Главная функция контроллера прерываний — служить мультиплексором сигналов прерываний от устройств, то есть выбирать один сигнал из множества сигналов прерываний устройств и пересылать его CPU.
Второй вопрос — как CPU реагирует на поступивший запрос прерывания. После выполнения каждой инструкции CPU проверяет вывод INTR, чтобы узнать, не поступил ли запрос прерывания от какого-либо устройства. Исключение — ситуация, когда CPU находится в состоянии с отключёнными прерываниями: в этом случае даже при высоком уровне на выводе INTR CPU не отреагирует на прерывание. Состояние отключённых прерываний у CPU независимо от контроллера прерываний — контроллер прерываний отвечает только за пересылку запросов прерываний от устройств, а окончательное решение о том, реагирует ли CPU на прерывание, зависит от состояния самого CPU.
Состоянием отключённых прерываний у CPU можно управлять программно, и разные ISA определяют это по-разному, а именно:
- В x86, если бит IF в EFLAGS равен 0, CPU находится в состоянии отключённых прерываний
- В mips32, если бит IE в status равен 0, либо бит EXL равен 1, либо бит ERL равен 1, CPU находится в состоянии отключённых прерываний
- В riscv32, если бит MIE в mstatus равен 0, CPU находится в состоянии отключённых прерываний
- На самом деле у стандартного механизма реакции на прерывания riscv32 есть ещё много деталей, которые мы упростили в PA. Если хотите узнать полный механизм реакции на прерывания, обратитесь к соответствующим руководствам.
Если в момент поступления прерывания CPU не находится в состоянии отключённых прерываний, он должен немедленно отреагировать на поступивший запрос прерывания. Мы только что упоминали, что контроллер прерываний генерирует номер прерывания, CPU сохраняет контекст прерывания, а затем рассматривает это прерывание как причину процесса обработки исключения: находит и переходит по адресу входа, выполняя некоторую обработку, связанную с устройством. Этот процесс очень похож на обработку исключений, о которой мы говорили ранее.
Для CPU момент поступления запроса прерывания от устройства непредсказуем, и вполне возможна ситуация, когда во время обработки одного запроса прерывания поступает ещё один запрос. Если требуется поддержать вложенность прерываний — то есть реагировать на прерывание с более высоким приоритетом прямо во время обработки прерывания с более низким приоритетом — то стек станет единственным вариантом для хранения информации о контексте прерывания. Если выбрать сохранение информации о контексте в фиксированном месте, то при возникновении вложенности прерываний информация о контексте, сохранённая первым прерыванием, будет затёрта процессом обработки прерывания с более высоким приоритетом, что приведёт к катастрофическим последствиям.
Катастрофические последствия (вопрос с некоторой сложностью)
Предположим, аппаратура сохраняет информацию о прерывании в фиксированном месте в памяти (например, по адресу 0x1000), и AM тоже всегда начинает строить контекст именно оттуда. Если произойдёт вложенность прерываний, какие катастрофические последствия наступят? В какой форме эти катастрофические последствия проявятся? Если у вас совсем нет идей, можете смоделировать процесс обработки прерываний на бумаге с ручкой.
Как поддержать вложенность прерываний
Подумайте, как программная и аппаратная части x86, mips32 и riscv32 должны взаимодействовать, чтобы поддержать вложенность прерываний?
Вытесняющая многозадачность
Второй тип разделения времени между задачами — это вытесняющая многозадачность (preemptive multitasking). Она основана на аппаратных прерываниях (обычно таймерных) и принудительно выполняет переключение контекста, позволяя всем процессам в системе справедливо выполняться по очереди. В операционной системе с вытесняющей многозадачностью прерывания — тот фундамент, на котором держится вся её жизнеспособность: стоит только подуть попутному ветру прерывания — и операционная система вновь берёт бразды правления в свои руки; даже вредоносная программа с намеренным бесконечным циклом, какими бы огромными способностями она ни обладала, в этот самый момент будет вежливо выпровожена с CPU, дав другим программам шанс выполниться.
В NEMU нам достаточно добавить только один вид прерывания — таймерное. Поскольку прерывание всего одно, управлять прерываниями через контроллер прерываний тоже не нужно — можно напрямую подключить таймерное прерывание к выводу INTR процессора. Что касается номера таймерного прерывания, у разных ISA разные соглашения на этот счёт. Таймерное прерывание запускается функцией timer_intr() в nemu/src/device/timer.c каждые 10 мс. После запуска вызывается функция dev_raise_intr() (определена в nemu/src/device/intr.c). Вам нужно:
- Добавить в структуру cpu поле типа
boolпод названиемINTR. - В
dev_raise_intr()установить вывод INTR в высокий уровень. - В конце цикла for в
cpu_exec()добавить код опроса вывода INTR, проверяя после выполнения каждой инструкции, не поступило ли аппаратное прерывание:
word_t intr = isa_query_intr();
if (intr != INTR_EMPTY) {
  cpu.pc = isa_raise_intr(intr, cpu.pc);
}
- Реализовать функцию
isa_query_intr()(определена вnemu/src/isa/$ISA/system/intr.c):
#define IRQ_TIMER 32          // for x86
#define IRQ_TIMER 0           // for mips32
#define IRQ_TIMER 0x80000007  // for riscv32
#define IRQ_TIMER 0x8000000000000007  // for riscv64

word_t isa_query_intr() {
  if ( ??? ) {
    cpu.INTR = false;
    return IRQ_TIMER;
  }
  return INTR_EMPTY;
}
- Изменить код в
isa_raise_intr(), чтобы процессор переходил в состояние отключённых прерываний:- x86 — после сохранения регистра EFLAGS установить его бит IF в
0 - mips32 — установить бит status.EXL в
1- Вам также нужно изменить реализацию инструкции eret, установив status.EXL в
0
- Вам также нужно изменить реализацию инструкции eret, установив status.EXL в
- riscv32 — сохранить mstatus.MIE в mstatus.MPIE, затем установить бит mstatus.MIE в
0- Вам также нужно изменить реализацию инструкции mret, восстановив mstatus.MPIE в mstatus.MIE, а затем установив бит mstatus.MPIE в
1
- Вам также нужно изменить реализацию инструкции mret, восстановив mstatus.MPIE в mstatus.MIE, а затем установив бит mstatus.MPIE в
- x86 — после сохранения регистра EFLAGS установить его бит IF в
На стороне программного обеспечения вам также нужно:
- Добавить в CTE поддержку таймерного прерывания, упаковав таймерное прерывание в событие
EVENT_IRQ_TIMER. - После получения Nanos-lite события
EVENT_IRQ_TIMERвызватьschedule(), чтобы принудительно заставить текущий процесс уступить CPU, при этом можно также убрать ранее вставленный намиyield()в коде обращения к устройствам. - Чтобы процессор мог реагировать на таймерные прерывания при выполнении пользовательского процесса, вам также нужно изменить код
kcontext()иucontext(), установив правильное состояние прерываний при построении контекста, чтобы в дальнейшем после восстановления контекста CPU находился в состоянии включённых прерываний.
Реализуйте вытесняющую многозадачность
Основываясь на изложенном выше содержании методички, добавьте соответствующий код для реализации вытесняющего разделения времени между задачами.
Чтобы протестировать, действительно ли работает таймерное прерывание, вы можете после получения Nanos-lite события EVENT_IRQ_TIMER вывести сообщение через Log().
Аппаратные прерывания и DiffTest
Для DiffTest мы не можем напрямую внедрить таймерное прерывание в QEMU, а значит, не можем гарантировать, что QEMU и NEMU находятся в одинаковом состоянии в момент поступления прерывания. Впрочем, инфраструктура, сопровождавшая вас всё это время, уже наверняка помогла вам устранить подавляющее большинство багов — оставшийся небольшой отрезок пути попробуйте пройти самостоятельно.
Прерывания и инициализация пользовательского процесса
Мы знаем, что пользовательский процесс начинает выполняться с _start из Navy, и именно в _start устанавливается правильный указатель стека. Если прерывание поступает раньше, чем пользовательский процесс установит правильный указатель стека, сможет ли наша система по-прежнему корректно обработать это прерывание?
Планирование процессов на основе временных срезов
В операционной системе с вытесняющей многозадачностью, поскольку таймерные прерывания поступают с фиксированной частотой, время делится на временные срезы (time slice) равной длины, что позволяет системе выполнять планирование процессов на основе временных срезов.
Приоритетное планирование
Мы можем изменить код schedule(), чтобы выделять Chinese Paladin больше временных срезов, так чтобы Chinese Paladin планировался несколько раз, прежде чем один раз запланируется поток ядра hello. Это потому, что поток ядра hello занимается только тем, что непрерывно выводит строки, и нам достаточно, чтобы он делал это лишь изредка — просто чтобы подтвердить, что он всё ещё работает.
Мы обнаружим, что после выделения Chinese Paladin большего числа временных срезов скорость его работы в некоторой степени возросла. Это вновь демонстрирует нам суть «разделения времени»: программы лишь по очереди используют процессор, они не выполняются «одновременно» в буквальном смысле этого слова.
Проблема планирования в реальных системах намного сложнее приведённого выше примера с Chinese Paladin. Например, в День холостяков (11.11) вся страна в один момент отправляет запросы на покупки на серверы Alibaba, и эти запросы в итоге превращаются в сотни миллионов процессов, обрабатываемых на тысячах серверов. Как в дата-центре планировать такое огромное количество процессов, чтобы максимально повысить качество обслуживания пользователей, — это серьёзный вызов, с которым Alibaba сталкивается постоянно.
Вытеснение и параллелизм
Если бы прерываний не существовало, работа компьютера была бы полностью детерминированной. Зная текущее состояние компьютера, вы могли бы полностью предсказать его состояние после выполнения следующей инструкции и даже после выполнения 100 инструкций. Но если позволить компьютеру поддерживать прерывания, поведение конечного автомата становится труднопредсказуемым.
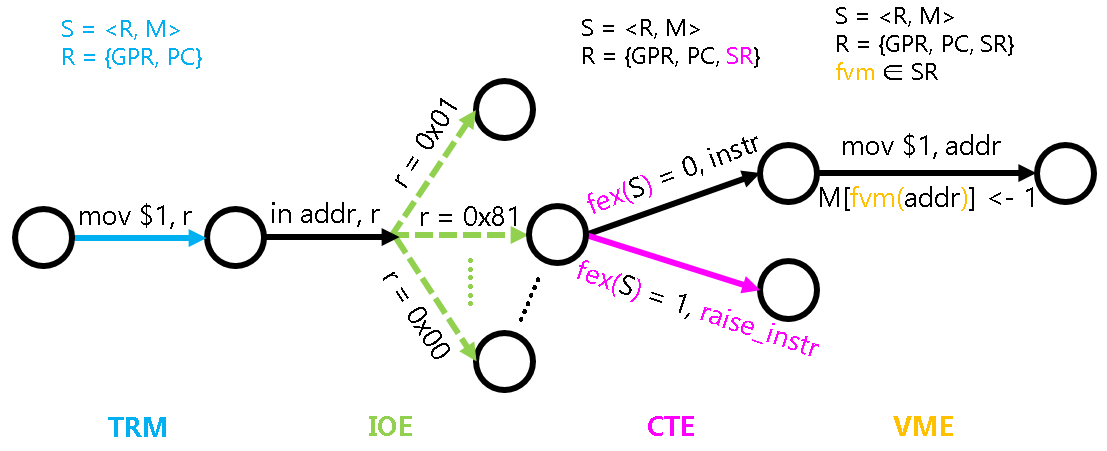
Чтобы смоделировать поведение прерываний, мы расширяем определение функции fex(): помимо определения, нужно ли текущему состоянию выбросить исключение, если процессор в данный момент находится в состоянии включённых прерываний, дополнительно нужно определить, не поступило ли прерывание. Это означает, что при выполнении каждой инструкции у компьютера есть шанс перейти к функции обработки прерывания из-за его поступления.
Неопределённость, которую прерывания вносят в компьютерную систему, можно назвать палкой о двух концах. Например, ядро GNU/Linux поддерживает так называемый entropy pool (пул энтропии) для сбора энтропии (неопределённости) в системе. Каждый раз, когда поступает прерывание, в этот пул добавляется немного энтропии. С помощью этой энтропии мы можем генерировать по-настоящему случайные числа — именно так работает /dev/random. Имея по-настоящему случайные числа, атаки вредоносных программ становятся относительно сложнее (например, ASLR), а безопасность системы получает дополнительную защиту.
Но с другой стороны, наличие прерываний вынуждает программы платить дополнительную цену при решении некоторых проблем. Поскольку прерывание может поступить в любой момент, если у двух процессов есть общая переменная v (например, при многопоточной загрузке в Thunder несколько потоков используют общий буфер файла), процесс A записывает в v значение 0, и сразу же после записи поступает прерывание, — а к моменту следующего запуска A значение v может оказаться уже не 0. В некотором смысле в этом тоже виноват параллелизм: возможно, процесс B параллельно изменяет значение v, а A об этом не подозревает. Такие баги, вызванные параллелизмом, несут на себе клеймо неопределённости: если момент поступления прерывания был бы другим, этот баг мог бы и не сработать. Поэтому такие баги ещё называют Heisenbug, по аналогии с принципом неопределённости в квантовой механике — когда вы пытаетесь его отладить, он может просто не проявиться.
Общие переменные могут возникать не только между пользовательскими процессами — ядро операционной системы и подавно является зоной повышенного риска для багов, связанных с параллелизмом. Например, несколько пользовательских процессов, параллельно записывающих в один и тот же файл, разделяют одно и то же смещение в файле, и при неправильной обработке это может привести к потере записываемых данных. В более общем смысле пользовательские процессы параллельно выполняют системные вызовы, и операционной системе нужно гарантировать, что все они будут корректно выполнены согласно семантике системного вызова.
Ах, не будем раскрывать так много спойлеров — на курсе операционных систем вы сами не спеша прочувствуете (и настрадаетесь от) всё это удовольствие. Возможно, тогда вы ещё вспомните добрым словом однопоточный PA.
Стек ядра и пользовательский стек
Ранее мы оставили следующий вопрос как самый сложный вопрос для размышления:
Почему на данный момент не поддерживается параллельное выполнение нескольких пользовательских процессов?
Теперь пришло время раскрыть ответ на этот вопрос: причина в обращении к пользовательскому стеку.
Анализ проблемы
Для удобства описания предположим, что в некоторый момент операционная система собирается переключиться с пользовательского процесса A на пользовательский процесс B. Конкретно: во время работы A указатель стека sp указывает на пользовательский стек A. Когда A выполняет системный вызов или поступает прерывание, происходит вход в операционную систему через CTE. В этот момент операционная система решает запланировать пользовательский процесс B, возвращает контекст B в CTE и ожидает, что CTE последовательно выполнит следующие операции:
- Переключится на виртуальное адресное пространство B через
__am_switch() - Восстановит контекст B в
trap.S
Если внимательнее рассмотреть детали этого процесса, обнаружится проблема. Конкретно: прежде чем __am_switch() переключится на виртуальное адресное пространство B, ему нужно сначала считать указатель дескриптора адресного пространства pdir (для x86 — cr3) из структуры контекста B. А структура контекста B была создана на пользовательском стеке B в прошлый раз, когда B входил в CTE, но пользовательский стек B не находится в виртуальном адресном пространстве A!
Получается, что для правильного считывания указателя дескриптора адресного пространства B нам нужно сначала переключиться на виртуальное адресное пространство B; но с другой стороны, чтобы переключиться на виртуальное адресное пространство B, нам сначала нужно правильно считать указатель дескриптора адресного пространства B! Это формирует циклическую зависимость по типу «курица и яйцо». При реальном выполнении код __am_switch() считает неправильный указатель дескриптора адресного пространства, и в результате не сможет корректно переключиться на виртуальное адресное пространство B.
Чтобы разорвать описанную выше циклическую зависимость, мы не можем сохранять указатель дескриптора адресного пространства в пользовательском стеке — его нужно сохранять в адресном пространстве, видимом всем пользовательским процессам. Очевидно, что таким адресным пространством, видимым всем пользовательским процессам, является виртуальное адресное пространство ядра, поскольку все виртуальные адресные пространства содержат отображение ядра, — это гарантирует, что независимо от того, на какой пользовательский процесс переключится операционная система, код всегда сможет обратиться к виртуальному адресному пространству ядра через отображение ядра.
Однако, будучи указателем дескриптора адресного пространства, его значение уже определяется в момент создания контекста пользовательского процесса и остаётся неизменным при каждом входе в CTE. Поэтому нам вовсе не обязательно сохранять его при поступлении прерывания или исключения — достаточно сохранить его в PCB при создании контекста пользовательского процесса, а когда потребуется переключить виртуальное адресное пространство, можно просто считать указатель дескриптора адресного пространства напрямую из PCB процесса B. Разумеется, PCB — это понятие операционной системы, AM о нём не знает, поэтому VME также нужно предоставить новый API switch_addrspace(): после того как операционная система выберет процесс B в schedule(), она сначала переключится на виртуальное адресное пространство B через switch_addrspace(), а затем уже вернётся в CTE и восстановит контекст B.
Способ разорвать циклическую зависимость
Как описано выше, мы храним указатель дескриптора адресного пространства в PCB и добавляем в VME новый API switch_addrspace(). С точки зрения корректности, работоспособно ли это решение?
Анализ корректности описанного выше решения мы оставляем вам в качестве вопроса для размышления. Предположим, что описанное выше решение верно, но в реальной операционной системе сохранение контекста на пользовательском стеке всё же вносит уязвимость безопасности. Вредоносная программа может выполнить следующую последовательность инструкций:
la sp, kernel_addr
ecall
Если операционная система сохранит контекст в область памяти, на которую указывает sp, данные ядра, расположенные по адресу kernel_addr, будут злонамеренно повреждены!
Поэтому операционная система не может доверять значению указателя стека в момент входа в ядро: перед выполнением любых операций со стеком (включая сохранение контекста) операционная система должна сначала направить указатель стека на стек, подготовленный ею самой, — этот процесс называется «переключением стека» (stack switching). После этого место сохранения контекста оказывается под контролем операционной системы, что решает описанную выше проблему с вредоносной программой. Этот подготовленный самой операционной системой стек и есть тот самый стек ядра, о котором мы говорили ранее.
Помимо устранения указанной выше уязвимости безопасности, использование стека ядра также автоматически снимает описанную выше проблему циклической зависимости: независимо от того, на какой пользовательский процесс переключится операционная система, код всегда может успешно обратиться к стеку ядра, разрывая тем самым эту циклическую зависимость.
Способ разорвать циклическую зависимость (2)
Механизм TSS (Task State Segment) в x86 может, благодаря аппаратной поддержке, заставить операцию переключения виртуального адресного пространства и операцию восстановления контекста происходить одновременно. А раз они происходят одновременно, то и проблемы циклической зависимости, вызванной порядком следования нескольких операций, уже не возникает.
Конкретно: механизм TSS требует, чтобы системное программное обеспечение (например, операционная система) сначала подготовило в памяти специальную структуру, описывающую контекст процесса, которая также включает значение регистра CR3, описывающего виртуальное адресное пространство процесса, затем устанавливает информацию об адресе этой структуры в системный регистр под названием TR, и наконец выполняет специальную инструкцию, после чего аппаратура автоматически восстанавливает контекст и переключает виртуальное адресное пространство на основе содержимого структуры.
Такое решение требует реализации в аппаратуре очень сложной по поведению инструкции восстановления контекста, и, очевидно, не у всех архитектур процессоров есть такая инструкция.
Переключение контекста в Linux
В ранних версиях Linux переключение контекста выполнялось именно через аппаратный механизм TSS. Позже выяснилось, что реализация этой сложной инструкции в аппаратуре по производительности всё же уступает переключению контекста, реализованному программно. К тому же по мере развития версий Linux требовалось добавлять поддержку всё большего числа архитектур, и ради лучшей поддерживаемости кода Linux в итоге остановился на программной реализации переключения контекста. Эта статья подытоживает эволюцию кода части переключения контекста в Linux — от самой первой версии 0.01 до современных версий 4.x — для тех, кому интересно с этим ознакомиться.
Концептуальные детали переключения стека
Чтобы реализовать переключение стека, нам нужно реализовать следующую функциональность:
- Если вход в CTE происходит из пользовательского режима, то перед сохранением контекста в CTE сначала переключаемся на стек ядра, и только потом сохраняем контекст
- Если в дальнейшем происходит возврат в пользовательский режим, то после восстановления контекста в CTE из стека ядра сначала переключаемся на пользовательский стек, и только потом возвращаемся
Обратите внимание: если мы входим в CTE из режима ядра, переключение не требуется; если в этом случае мы по ошибке снова направим указатель стека на дно стека ядра, существующее содержимое стека ядра будет затёрто последующими операциями проталкивания в стек!
Пользовательский режим и указатель стека
Вообще говоря, уровень привилегий процессора — это тоже разновидность состояния. Можем ли мы по значению указателя стека определить, находимся ли мы сейчас в пользовательском режиме или в режиме ядра?
Базовая функциональность
А чтобы реализовать описанную выше функциональность, нам нужно решить следующие вопросы:
- Как определить, находились ли мы перед входом в CTE в пользовательском режиме или в режиме ядра? —
pp(Previous Privilege) - Как код CTE узнаёт, где находится стек ядра? —
ksp(Kernel Stack Pointer) - Как узнать, в какой режим предстоит вернуться — пользовательский или режим ядра? —
np(Next Privilege) - Как код CTE узнаёт, где находится пользовательский стек? —
usp(User Stack Pointer)
Для каждого из этих вопросов мы определили отдельную концептуальную переменную; решить эти вопросы — значит правильно поддерживать эти переменные в CTE. Опишем нужную нам функциональность псевдокодом, где $sp обозначает регистр указателя стека:
void __am_asm_trap() {
  if (pp == USER) {
    usp = $sp;
    $sp = ksp;
  }
  np = pp;

  // save context

  __am_irq_handle(c);

  // restore context

  pp = np;
  if (np == USER) {
    ksp = $sp;
    $sp = usp;
  }

  return_from_trap();
}
Обратите внимание, что приведённый выше псевдокод описывает лишь концептуальное поведение и не означает, что код обязательно должен быть написан строго в соответствующем порядке — например, np = pp; можно разместить после сохранения контекста и даже в начале __am_irq_handle(). Судя по псевдокоду, функциональность, которую нам нужно добавить, не выглядит сложной.
Сложность системы
Если вы думаете, что реализовать приведённый выше код несложно, вы сильно недооцениваете сложность системы. Попробуйте, не читая дальнейшее содержание, проанализировать, какие проблемы может вызвать приведённый выше код в реальном процессе выполнения? Если проблемы возникнут, как их следует решать?
Переключение контекста
Но не забывайте, что операционная система может через CTE вернуть новую структуру контекста и выполнить переключение — нам нужно гарантировать, что код продолжает работать корректно даже при условии, что переключение контекста может произойти.
Сложность системы (2)
Раз уж вы дошли до этого места, попробуйте тоже сначала не читать дальнейшее содержание, а затем попробуйте проанализировать: как нужно гарантировать, что код продолжает работать корректно даже при условии, что переключение контекста может произойти?
Нам нужно внимательно рассмотреть поведение указанных выше переменных. После несложного анализа мы можем обнаружить, что pp и ksp не подвержены влиянию переключения контекста: им присваивается значение перед выходом из CTE, но используются они лишь при следующем входе в CTE; в промежутке их значения не меняются, а переключение контекста может произойти только после того, как они уже были использованы. А вот с np и usp всё иначе — им присваивается значение при входе в CTE, а используются они перед выходом из CTE, и в этом промежутке переключение контекста вполне может произойти.
Мы легко можем построить пример, демонстрирующий проблему, к которой приводит переключение контекста. Предположим, некий пользовательский процесс входит в CTE из-за системного вызова или поступившего прерывания, и приведённый выше код установит np в значение USER, обозначая, что при следующем выходе из CTE предстоит вернуться в пользовательский режим. Если в этот промежуток произойдёт переключение контекста на поток ядра, то поток ядра, восстановив контекст, проверит np, обнаружит USER и по ошибке установит usp в $sp — но мы знаем, что у потока ядра нет пользовательского стека, и при возврате из CTE выполнение потока ядра приведёт к катастрофическим последствиям.
Для тех переменных, которые подвержены влиянию переключения контекста, мы не можем просто определять их как глобальные переменные. По своей сути они являются атрибутами, описывающими контекст, и должны переключаться вместе с ним, поэтому правильный подход — определять их именно в структуре Context:
void __am_asm_trap() {
  if (pp == USER) { // pp is global
    c->usp = $sp;   // usp should be in Context
    $sp = ksp;      // ksp is global
  }
  c->np = pp;       // np should be in Context

  // save context

  __am_irq_handle(c);

  // restore context

  pp = c->np;
  if (c->np == USER) {
    ksp = $sp;
    $sp = c->usp;
  }

  return_from_trap();
}
Повторный вход в CTE
Помимо переключения контекста, нам также нужно рассмотреть проблему повторного входа (re-entry) в CTE: возможно ли, что код снова войдёт в CTE ещё до того, как выйдет из неё?
Мы знаем, что yield() реализована через CTE. Если пользовательский процесс, войдя в ядро через системный вызов, затем выполняет yield(), возникает явление повторного входа в CTE.
Ещё одно явление, вызывающее повторный вход в CTE, — описанная выше вложенность прерываний: когда поступает первое прерывание, код входит в CTE, но второе прерывание может поступить ещё до того, как код выйдет из неё.
Однако в PA вложенность прерываний не возникнет, поскольку мы заставляем процессор находиться в состоянии отключённых прерываний сразу после входа в CTE.
Как повторный вход в CTE повлияет на приведённый выше код? Анализируя поведение кода с точки зрения конечного автомата программы, мы легко обнаружим проблему.
Сложность системы (3)
Рассмотрим проблему повторного входа в CTE как упражнение с точки зрения конечного автомата. Попробуйте проанализировать, какие проблемы есть у приведённого выше кода в случае повторного входа в CTE.
Чтобы решить эту проблему, нам нужно внести в приведённый выше код следующие изменения:
void __am_asm_trap() {
  if (pp == USER) { // pp is global
    c->usp = $sp;   // usp should be in Context
    $sp = ksp;      // ksp is global
  }
  c->np = pp;       // np should be in Context

  pp = KERNEL;      // support re-entry of CTE

  // save context

  __am_irq_handle(c);

  // restore context

  pp = c->np;
  if (c->np == USER) {
    ksp = $sp;
    $sp = c->usp;
  }

  return_from_trap();
}
Операционные системы и прерывания
В реальных операционных системах обработка системных вызовов выполняется при включённых прерываниях. Это потому, что обработка системного вызова может занять очень много времени — например, SYS_read может читать большой объём данных с механического диска; если операционная система всё время находится в состоянии отключённых прерываний, она не сможет своевременно реагировать на различные запросы прерываний в системе: системные часы, поддерживаемые таймерным прерыванием, могут заметно отставать, сетевая карта из-за переполненного буфера может отбрасывать множество сетевых пакетов...
Это создаёт серьёзный вызов для проектирования операционных систем: поскольку поступление прерываний непредсказуемо, это означает, что повторный вход в CTE может произойти в любом месте процесса обработки системного вызова. Ещё сложнее то, что повторный вход возможен не только для кода CTE, но и для многого другого кода в операционной системе. Поэтому разработчикам операционных систем приходится писать соответствующий код крайне осторожно — малейшая невнимательность приводит к тому, что глобальные переменные оказываются затёрты из-за повторного входа.
Именно из-за такого вызова в PA мы просто обходим эту проблему, отключая прерывания. На самом деле повторный вход можно считать особой формой параллелизма, и на курсе операционных систем в следующем семестре у вас появится более глубокое понимание параллелизма.
Некоторые оптимизации
Мы можем внести в приведённый выше код несколько простых оптимизаций. Одно из мест для оптимизации — объединить функциональность pp с ksp, позволив ksp обозначать одновременно и адрес стека ядра, и уровень привилегий перед входом в CTE.
Заметим, что ksp всегда используется именно тогда, когда pp == USER, а значение ksp заведомо не равно 0, поэтому мы можем через ksp == 0 обозначать pp == KERNEL.
Договоримся о значении ksp следующим образом:
- Если сейчас пользовательский режим, значение
ksp— это дно стека ядра - Если сейчас режим ядра, значение
kspравно0
После этого приведённый выше код можно оптимизировать следующим образом:
void __am_asm_trap() {
  if (ksp != 0) {   // ksp is global
    c->usp = $sp;   // usp should be in Context
    $sp = ksp;
  }
  c->np = (ksp == 0 ? KERNEL : USER);  // np should be in Context

  ksp = 0;          // support re-entry of CTE

  // save context

  __am_irq_handle(c);

  // restore context

  if (c->np == USER) {
    ksp = $sp;
    $sp = c->usp;
  }

  return_from_trap();
}
Ещё одно место для оптимизации — объединить функциональность c->usp с c->sp, позволив c->sp обозначать значение $sp перед входом в CTE, независимо от того, находилась система в пользовательском режиме или в режиме ядра перед входом в CTE.
Аналогично, при восстановлении контекста достаточно просто присвоить c->sp в $sp.
Тогда дополнительно определять usp в структуре Context уже не нужно, поэтому приведённый выше код можно оптимизировать следующим образом:
void __am_asm_trap() {
  c->sp = $sp;
  if (ksp != 0) {   // ksp is global
    $sp = ksp;
  }
  c->np = (ksp == 0 ? KERNEL : USER);  // np should be in Context

  ksp = 0;          // support re-entry of CTE

  // save context

  __am_irq_handle(c);

  // restore context

  if (c->np == USER) {
    ksp = $sp;
  }
  $sp = c->sp;

  return_from_trap();
}
Конкретная реализация переключения стека
Всё обсуждавшееся выше — лишь концептуальное решение. Чтобы реализовать переключение стека ядра в коде, нам ещё нужно отобразить упомянутые выше концептуальные переменные на конкретную реализацию, зависящую от ISA.
mips32
Для реализации переключения стека ядра mips32 оказывается проще всего. Согласно соглашению mips32 ABI, среди регистров общего назначения зарезервированы два регистра, k0 и k1, специально для использования ядром, и компилятор не станет выделять в них переменные. Поэтому мы можем договориться следующим образом:
- Отобразить концептуальный
kspна регистрk0 - Отобразить концептуальный
c->npнаc->gpr[k1] - Отобразить концептуальный
c->spнаc->gpr[sp]
Вам достаточно добавить в CTE небольшое количество кода согласно указанным выше договорённостям, чтобы реализовать функциональность переключения стека ядра.
riscv32
В отличие от mips32, riscv32 ABI не оговаривает использование регистров, подобных k0 и k1. Вместо этого riscv32 предоставляет CSR-регистр под названием mscratch, специально предназначенный для использования системным программным обеспечением в качестве временного регистра; с точки зрения аппаратного поведения у него нет ничего особенного. Поэтому мы можем договориться следующим образом:
- Отобразить концептуальный
kspна регистрmscratch - Добавить в структуру Context новое поле
npи отобразить на него концептуальныйc->np - Отобразить концептуальный
c->spнаc->gpr[sp]
Однако, приступив к реализации кода, вы обнаружите, что сразу после входа в CTE, но ещё до переключения на стек ядра, у нас вообще нет свободных регистров общего назначения для использования! На самом деле дизайн riscv32 очень изящен, и мы можем выполнить переключение стека ядра всего тремя инструкциями:
__am_asm_trap:
  csrrw sp, mscratch, sp   // (1) atomically exchange sp and mscratch
  bnez sp, save_context    // (2) take the branch if we trapped from user
  csrr sp, mscratch        // (3) if we trapped from kernel, restore the original sp

save_context:
  // now sp is pointing to the kernel stack
  // save the context...
Чтобы проверить значение mscratch, мы через инструкцию (1) искусно используем атомарную функцию обмена инструкции доступа к CSR, чтобы поменять местами значения sp и mscratch. Это позволяет одновременно и считать прежнее значение mscratch в регистр общего назначения sp для сравнения (ветвящиеся инструкции riscv32 не могут обращаться к CSR-регистрам), и сохранить прежнее значение sp в регистре mscratch, чтобы избежать его порчи.
Далее, инструкцией (2) проверяем только что считанное значение mscratch (то есть концептуальный ksp): если значение равно 0, значит, перед входом в CTE был режим ядра, и в этот момент указатель стека ядра уже был обменён инструкцией (1) в регистр mscratch, поэтому инструкцией (3) считываем указатель стека ядра обратно; если значение не равно 0, значит, перед входом в CTE был пользовательский режим, и нужно переключить sp на стек ядра — но инструкция (1) уже выполнила это переключение, поэтому в этом случае достаточно просто перейти к save_context, чтобы сохранить контекст.
Решение с временными регистрами
И mips32, и riscv32 нуждаются во временных регистрах для CTE, но mips32 выбирает выделить k0 и k1 в GPR, а riscv32 использует CSR-регистр mscratch. Есть ли между этими двумя подходами более удачный? Почему?
x86
Реализация переключения стека ядра в x86 довольно специфична, поскольку механизм обработки исключений x86 напрямую сохраняет eflags, cs и eip на стек, и программный код не может вмешаться в это поведение.
Если мы хотим сохранить эти 3 регистра на стеке ядра, переключение стека ядра должно выполняться самой аппаратурой x86. Аналогично, инструкция iret в x86 восстанавливает состояние путём извлечения из стека. Это означает, что мы точно так же не можем восстановить указатель пользовательского стека программно: если мы переключимся на пользовательский стек перед инструкцией iret, то iret не сможет найти правильные eflags, cs и eip; но если мы сначала выполним iret, eip будет указывать на пользовательский код, и в этот момент мы уже не сможем восстановить указатель пользовательского стека.
Поэтому x86 вынужден предоставить решение описанной выше проблемы через аппаратный механизм. Во-первых, нужно, чтобы аппаратура распознавала текущий уровень привилегий — это делается через поле RPL регистра CS (то же самое, что CPL в определении руководства по i386): если CS.RPL равен 0, это означает, что процессор находится в режиме ядра; если CS.RPL равен 3, это означает, что процессор находится в пользовательском режиме.
Затем мы, согласно руководству по i386, расширим поведение механизма обработки исключений x86 и инструкции iret:
- Если исключение возникает в режиме ядра, поведение механизма обработки исключений совпадает с описанным в PA3 (см.
WITHOUT PRIVILEGE TRANSITIONна Figure 9-5 в руководстве по i386) - Если исключение возникает в пользовательском режиме, механизм обработки исключений сначала находит
kspчерез механизм TSS, затем сначала помещает вkspss(регистр стекового сегмента) иesp, а в конце —eflags,csиeip(см.WITH PRIVILEGE TRANSITIONна Figure 9-5 в руководстве по i386) - При выполнении инструкции
iretсначала по порядку извлекаютсяeip,csиeflags; если извлечённыйcsозначает возврат в пользовательский режим, дополнительно извлекаютсяespиss
У полноценного механизма TSS есть два назначения: одно — выполнять переключение контекста в аппаратуре, другое — выполнять переключение стека ядра при возникновении исключения в пользовательском режиме. В PA нам нужно заботиться только о втором.
Но чтобы рассказать о механизме TSS, нам придётся ввести механизм сегментации, который мы изначально надеялись упростить в PA. Впрочем, вы уже разобрались в механизме обработки исключений в PA3, и это поможет вам понять механизм TSS.
Сначала вспомним механизм обработки исключений x86:
Считываем из регистра IDTR начальный адрес массива IDT, индексируем IDT номером исключения, получаем дескриптор шлюза, а затем собираем из поля offset дескриптора шлюза адрес.
Теперь по аналогии рассмотрим процесс обработки в механизме TSS:
Считываем из регистра GDTR начальный адрес массива GDT, индексируем GDT полем idx регистра TR, получаем дескриптор TSS, а затем собираем из поля base дескриптора TSS адрес.
О, похоже, это не так уж сложно понять. Однако в механизме обработки исключений в итоге получается адрес входа в обработчик исключения, а в механизме TSS в итоге получается адрес структуры TSS. У структуры TSS очень много полей, но в процессе переключения стека ядра аппаратура использует только два поля — ss0 и esp0 (см. определение структуры TSS32 в abstract-machine/am/src/x86/x86.h). В 7-й главе учебника ICS описан процесс обработки исключений с механизмом TSS; за подробностями о механизме TSS также можно обратиться к руководству по i386.
Благодаря поддержке аппаратного механизма TSS, CTE на программном уровне достаточно поддерживать только концептуальную переменную ksp:
- Отобразить концептуальный
kspна полеesp0структуры TSS - Отобразить концептуальный
c->npнаc->cs.RPL - Добавить в структуру Context два новых поля,
ss3иesp3, и отобразить концептуальныйc->sp(по сути, этоc->usp) наc->esp3
Чтобы механизм TSS в дальнейшем работал корректно, нам также нужно добавить в cte_init() некоторый код инициализации:
#define NR_SEG 6
static SegDesc gdt[NR_SEG] = {};
static TSS32 tss = {};

bool cte_init(Context*(*handler)(Event, Context*)) {
  // ...

  // initialize GDT
  gdt[1] = SEG32(STA_X | STA_R,   0,      0xffffffff, DPL_KERN);
  gdt[2] = SEG32(STA_W,           0,      0xffffffff, DPL_KERN);
  gdt[3] = SEG32(STA_X | STA_R,   0,      0xffffffff, DPL_USER);
  gdt[4] = SEG32(STA_W,           0,      0xffffffff, DPL_USER);
  gdt[5] = SEG16(STS_T32A,     &tss, sizeof(tss) - 1, DPL_KERN);
  set_gdt(gdt, sizeof(gdt[0]) * NR_SEG);

  // initialize TSS
  tss.ss0 = KSEL(2);
  set_tr(KSEL(5));

  return true;
}
Мы установили в массиве GDT 5 дескрипторов: первые 4 обозначают, соответственно, сегмент кода режима ядра, сегмент данных режима ядра, сегмент кода пользовательского режима и сегмент данных пользовательского режима — они нужны, чтобы во время DiffTest QEMU мог корректно обрабатывать уровни привилегий; вникать в их детали нам не нужно.
Реализуйте переключение между стеком ядра и пользовательским стеком
Разберитесь в изложенном выше содержании методички, измените код CTE так, чтобы он поддерживал переключение между стеком ядра и пользовательским стеком. Вам нужно понять, как в вашей реализации отражается функциональность приведённого выше псевдокода. При этом, в зависимости от природы разных концептуальных переменных, вам может также понадобиться инициализировать их в cte_init() либо в kcontext()/ucontext(). Если вы хотите поддерживать эти концептуальные переменные в __am_irq_handle(), при необходимости можно использовать встроенный ассемблер.
После реализации заставьте Nanos-lite загрузить два пользовательских процесса — NTerm и hello, а затем запустите из NTerm Chinese Paladin. Если ваша реализация верна, вы увидите, что пользовательский процесс hello и NTerm/Chinese Paladin работают с разделением времени. В отличие от прежнего эффекта, на этот раз мы по-настоящему реализовали работу двух пользовательских процессов с разделением времени.
Несколько подсказок:
- Для удобства отладки вы можете сначала отключить в NEMU таймерное прерывание — это повысит детерминированность системы; включите таймерное прерывание снова после успешного тестирования
- mips32 —
k1уже становится доступным регистром ещё до сохранения контекста - riscv32 — чтобы поддерживать
c->np, вам может понадобиться сразу после переключения на стек ядра сохранить небольшую часть GPR, либо воспользоваться глобальной переменной себе в помощь - x86 — помимо реализации в аппаратуре необходимых регистров и аппаратных механизмов, вам также нужно выполнить следующую инициализацию:
- в
kcontext()установитьc->csравнымKSEL(1) - в
ucontext()установитьc->csравнымUSEL(3), аc->ss3равнымUSEL(4)
- в
Стоит отметить, что на данный момент мы допускаем участие в планировании не более чем одного процесса, которому нужно обновлять экран, — это потому, что параллельная работа нескольких таких процессов приводит к взаимному затиранию содержимого экрана, что портит вывод изображения. В настоящих операционных системах с графическим интерфейсом обычно есть отдельный процесс-менеджер окон, который единообразно управляет отображением на экране; процессы, которым нужно выводить изображение, взаимодействуют с этим процессом-менеджером, чтобы добиться обновления экрана. Но для этого операционной системе нужно поддерживать механизм межпроцессного взаимодействия, а это уже выходит за рамки курса ICS, к тому же Nanos-lite, будучи урезанной операционной системой, тоже не предоставляет сервисов межпроцессного взаимодействия. Поэтому мы упростили задачу и допускаем участие в планировании не более чем одного процесса, которому нужно обновлять экран.
Сложность реальных систем
Разобрав задачи и решения, необходимые для «параллельного выполнения нескольких пользовательских процессов», мы увидели, что при сочетании нескольких изученных концепций сложность проблемы может возрастать экспоненциально: прерывания могут поступить в любой момент, самозахваты могут произойти — всё это способно вызвать переключение контекста; с одной стороны, это может привести к переключению виртуального адресного пространства, с другой стороны, при возврате из контекста может понадобиться переключиться на пользовательский стек, а может — на стек ядра, и это, в свою очередь, зависит от поддержания некоторых переменных; хотя все эти переменные определяются и используются через язык C, под совместным воздействием прерываний, исключений и переключений контекста у глобальных переменных и полей структуры Context оказываются разные времена жизни, и в зависимости от разных сценариев нам нужно определять некоторые ключевые переменные в разных местах...
Современные компьютерные системы обычно оснащены многоядерными процессорами и работают под управлением многоядерных операционных систем, поэтому появляется ещё один класс переменных, связанных с числом процессоров; помимо сценариев параллелизма, вызванных обработкой прерываний и исключений, несколько процессоров могут даже по-настоящему выполнять код параллельно, и то, как корректно решать различные проблемы параллелизма в многоядерных системах, — это неизменный вызов, стоящий перед областью компьютерных систем.
Nanos-lite и баги параллелизма (рекомендуется обдумать при повторном прохождении / после изучения курса ОС)
При обсуждении параллелизма выше мы упоминали: в более общем случае пользовательские процессы параллельно выполняют системные вызовы, и операционной системе нужно гарантировать, что все они выполняются корректно согласно семантике системного вызова.
Мы знаем из PA3, что printf() запрашивает буфер через malloc(), а malloc(), в свою очередь, может выполнить _sbrk(), входя в ядро через SYS_brk; на предыдущем этапе мы реализовали поддерживающую механизм страничной организации mm_brk(), которая при необходимости запрашивает страницу через new_page(). И Chinese Paladin, и пользовательский процесс hello вызывают printf(), а значит, могут параллельно выполнять SYS_brk. Подумайте: приведёт ли текущий дизайн Nanos-lite к багу параллелизма? Почему?