
Путешествие сквозь пространство и время
Благодаря мощному аппаратному механизму защиты пользовательская программа больше не может переключать поток исполнения на произвольный код операционной системы. Но для реализации простейшей операционной системы аппаратному обеспечению всё же требуется способ переключения потока исполнения с ограниченными точками входа. Таким способом является инструкция самоловушки (trap): после её выполнения программа «проваливается» (traps) в заранее заданную операционной системой цель перехода. Эта цель перехода также называется адресом входа в исключение.
Этот процесс является частью спецификации ISA и называется механизмом реагирования на прерывания/исключения. Большинство ISA не различают исключения процессора, самоловушки и даже аппаратные прерывания (о которых мы расскажем в конце PA4), а обрабатывают их единообразно. Поскольку сейчас мы ещё не добавили аппаратные прерывания, будем пока для краткости называть этот механизм «механизмом реагирования на исключения».
x86
В x86 в качестве инструкции самоловушки выступает int, однако её механизм реагирования на исключения несколько сложнее по сравнению с другими ISA. В x86 адрес входа в исключение указывается через дескриптор шлюза (Gate Descriptor). Дескриптор шлюза — это 8-байтная структура, содержащая немало детальной информации; в NEMU мы упростили структуру дескриптора шлюза, оставив только бит присутствия P и смещение OFFSET:
   31                23                15                7                0
  +-----------------+-----------------+---+-------------------------------+
  |           OFFSET 31..16           | P |          Don't care           |4
  +-----------------------------------+---+-------------------------------+
  |             Don't care            |           OFFSET 15..0            |0
  +-----------------+-----------------+-----------------+-----------------+
Бит P используется для обозначения того, действителен ли этот дескриптор шлюза, а OFFSET указывает адрес входа в исключение. Благодаря дескриптору шлюза пользовательская программа может перейти только по адресу, указанному в поле OFFSET дескриптора шлюза, и больше не может произвольно переходить на любой код операционной системы.
Чтобы упростить управление отдельными дескрипторами шлюзов, x86 интерпретирует определённый участок памяти как массив, называемый IDT (Interrupt Descriptor Table, таблица дескрипторов прерываний), где один элемент массива — это один дескриптор шлюза. Чтобы найти дескриптор шлюза в массиве, нам ещё нужен индекс. Для исключений процессора этот индекс формируется самим процессором (например, исключение деления на ноль имеет номер 0), либо задаётся инструкцией int (например, int $0x80). Наконец, чтобы найти IDT в памяти, x86 использует регистр IDTR для хранения начального адреса и длины IDT. Код операционной системы заранее подготавливает IDT, а затем выполняет специальную инструкцию lidt, чтобы установить в IDTR начальный адрес и длину IDT — после этого механизм реагирования на исключения может работать нормально. Теперь всё готово: как только программа выполнит инструкцию самоловушки или произойдёт исключение, процессор перейдёт по адресу входа в исключение согласно настроенной IDT:
           |               |
           |   Entry Point |<----+
           |               |     |
           |               |     |
           |               |     |
           +---------------+     |
           |               |     |
           |               |     |
           |               |     |
           +---------------+     |
           |offset |       |     |
           |-------+-------|     |
           |       | offset|-----+
  index--->+---------------+
           |               |
           |Gate Descriptor|
           |               |
    IDT--->+---------------+
           |               |
           |               |
Однако в будущем нам всё же может понадобиться вернуться к текущему состоянию программы, чтобы продолжить её выполнение — например, при исключении точки останова, вызванном инструкцией int3. Это означает, что при реагировании на исключение необходимо сохранить текущее состояние программы. Итак, процесс реагирования аппаратного обеспечения после возникновения исключения выглядит следующим образом:
- Прочитать из IDTR начальный адрес IDT.
- Проиндексировать IDT по номеру исключения и найти дескриптор шлюза.
- Объединить поле offset из дескриптора шлюза в адрес входа в исключение.
- По очереди поместить в стек значения регистров eflags, cs (регистр сегмента кода) и eip (то есть PC).
- Перейти по адресу входа в исключение.
В гармоничном компьютерном обществе большинство дескрипторов шлюзов недоступны пользовательским процессам для произвольного использования — иначе вредоносная программа смогла бы обмануть операционную систему с помощью инструкции int. Например, вредоносная программа могла бы выполнить int $0x2, ложно сообщив об отключении питания, тем самым нарушив нормальную работу других процессов. Поэтому выполнение инструкции int также требует проверки уровня привилегий, но в рамках PA этот механизм защиты не реализуется, и конкретные правила проверки мы подробно не рассматриваем — при необходимости обращайтесь к RTFM.
mips32
В mips32 в качестве инструкции самоловушки выступает syscall, и работает она довольно просто. По соглашению mips32 адрес входа в исключение всегда равен 0x80000180. Чтобы сохранить текущее состояние программы, mips32 предоставляет несколько специальных системных регистров, которые находятся в сопроцессоре номер 0 (Co-Processor 0), поэтому их также называют регистрами CP0. В рамках PA мы используем только следующие 3 регистра CP0:
- регистр
epc— хранит PC, при выполнении которого возникло исключение; - регистр
status— хранит состояние процессора; - регистр
cause— хранит причину возникновения исключения.
После возникновения исключения в mips32 процесс реагирования аппаратного обеспечения выглядит следующим образом:
- Сохранить текущее значение PC в регистр
epc. - Установить номер исключения в регистре
cause. - Установить флаг исключения в регистре
status, переводя процессор в режим ядра. - Перейти по адресу
0x80000180.
riscv32
В riscv32 в качестве инструкции самоловушки выступает ecall, а для хранения адреса входа в исключение предоставляется регистр mtvec. Чтобы сохранить текущее состояние программы, riscv32 предоставляет несколько специальных системных регистров, называемых регистрами управления и состояния (CSR-регистры). В рамках PA мы используем только следующие три CSR-регистра:
- регистр
mepc— хранит PC, при выполнении которого возникло исключение; - регистр
mstatus— хранит состояние процессора; - регистр
mcause— хранит причину возникновения исключения.
После возникновения исключения в RISC-V32 процесс реагирования аппаратного обеспечения выглядит следующим образом:
- Сохранить текущее значение PC в регистр
mepc. - Установить номер исключения в регистре
mcause. - Извлечь адрес входа в исключение из регистра
mtvec. - Перейти по адресу входа в исключение.
Важно отметить, что описанные выше действия по сохранению состояния программы и переходу по адресу входа в исключение полностью выполняются аппаратно, программисту не нужно писать инструкции для реализации этого. На самом деле это лишь упрощённый процесс — на реальных компьютерах приходится обрабатывать намного больше деталей, например переключение уровней привилегий в x86 и RISC-V32, которые мы здесь не рассматриваем. В руководстве по ISA также описано распределение процессором номеров прерываний и исключений, а также приведены подробные разъяснения по различным исключениям — при необходимости к нему можно обратиться.
Особая причина? (рекомендуется обдумать при повторном прохождении)
Обязательно ли эти состояния программы (в x86 — eflags, cs, eip; в mips32 — epc, status, cause; в riscv32 — mepc, mstatus, mcause) должны сохраняться аппаратно? Можно ли сохранить их программно? Почему?
Поскольку адрес входа в исключение заранее согласован между аппаратным обеспечением и операционной системой, дальнейшую обработку берёт на себя операционная система. Она решает, в зависимости от ситуации, стоит ли завершать выполнение текущей программы (например, программа, вызвавшая ошибку сегментации, будет уничтожена). Если принято решение не завершать текущую программу, то по окончании обработки исключения состояние программы восстанавливается на основе ранее сохранённой информации, и происходит возврат из процесса обработки исключения к состоянию, предшествовавшему возникновению исключения. А именно:
- x86 возвращается из процесса обработки исключения с помощью инструкции
iret, которая интерпретирует три верхних элемента стека последовательно как eip, cs, eflags и восстанавливает их. - mips32 возвращается из процесса обработки исключения с помощью инструкции
eret, которая сбрасывает флаг исключения в регистре status и восстанавливает PC на основе регистра epc. - riscv32 возвращается из процесса обработки исключения с помощью инструкции
mret, которая восстанавливает PC на основе регистра mepc.
Механизм реагирования на исключения с точки зрения машины состояний
Программа представляет собой машину состояний S = <R, M>, и мы уже обсуждали конкретное поведение этой машины состояний в контексте TRM и IOE. Если мы хотим добавить компьютеру механизм реагирования на исключения, как нам следует расширить эту машину состоянии?
Прежде всего, разумеется, нужно расширить R: помимо PC и регистров общего назначения, необходимо добавить упомянутые выше специальные регистры. Назовём их системными регистрами (System Register), поскольку их функции связаны с системными возможностями и они не используются при обычных вычислениях. После расширения регистры можно представить как R = {GPR, PC, SR}. Механизм реагирования на исключения не связан с памятью, поэтому менять смысл M не требуется.
Расширение переходов состояний — это уже гораздо интереснее. Раньше мы считали, что каждая выполняемая программой инструкция завершается успешно, и, соответственно, машина состояний переходил из состояния в состояние согласно семантике инструкции. После добавления механизма реагирования на исключения мы допускаем, что выполнение инструкции может «завершиться неудачей». Чтобы описать поведение при неудачном выполнении инструкции, можно предположить, что у процессора есть вымышленная инструкция raise_intr, выполнение которой соответствует описанному выше процессу реагирования на исключение. Очевидно, что это поведение можно описать с точки зрения машины состояний, например, для riscv32 это можно представить так:
SR[mepc] <- PC
SR[mcause] <- число, описывающее причину неудачи
PC <- SR[mtvec]
Имея эту вымышленную инструкцию, мы теперь можем понять поведение реагирования на исключение с точки зрения машины состояний: если инструкция выполняется успешно, её поведение совпадает с ранее описанным для TRM и IOE; если выполнение инструкции завершается неудачей, её поведение эквивалентно выполнению вымышленной инструкции raise_intr.
Так является ли «неудачное выполнение инструкции» детерминированным событием? Очевидно, это зависит от определения понятия «неудача». Например, деление на ноль определяется как «второй операнд инструкции деления равен нулю», недопустимая инструкция может быть определена как «инструкция, не описанная в руководстве ISA», а инструкцию самоловушки можно считать особым случаем безусловной неудачи. Разные руководства по ISA дают свои собственные определения понятия «неудача»: например, руководство RISC-V не считает деление на ноль неудачей, поэтому даже при нулевом делителе процессор RISC-V выполнит эту инструкцию в соответствии с описанием в руководстве.
На самом деле все эти условия неудачи можно представить в виде функции fex: S -> {0, 1}: для любого заданного состояния машины состояний S значение fex(S) однозначно определяет, может ли инструкция, на которую указывает текущий PC, быть успешно выполнена. Таким образом, добавление компьютеру механизма реагирования на исключения не делает систему более непредсказуемой, что значительно снижает сложность понимания этого механизма, а заодно делает отладку не слишком трудной: при многократном запуске программы она по-прежнему будет выбрасывать одно и то же исключение в одном и том же месте, приводя к одному и тому же переходу состояний (инструкции ввода в IOE вносят некоторую недетерминированность, но пока она остаётся в рамках, которые мы контролируем).
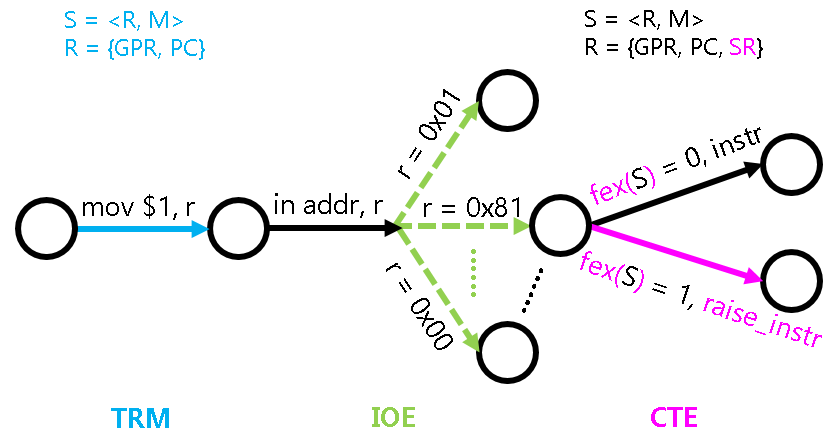
Наконец, добавление механизма реагирования на исключения сопровождается появлением ряда системных инструкций, таких как lidt, iret в x86 или csrrw, mret в riscv32. Если не считать того, что эти инструкции специально предназначены для операций над SR в машинe состояний, по своей сути они мало чем отличаются от вычислительных инструкций TRM, поэтому их поведение тоже несложно понять.
Абстрагирование управления контекстом в CTE
Мы только что упомянули состояние программы — в операционных системах есть эквивалентный термин, «контекст». Поэтому описанная выше функциональность переключения потока исполнения между операционной системой и пользовательской программой, предоставляемая аппаратным обеспечением, с точки зрения операционной системы может быть отнесена к части управления контекстом.
Как и в случае с IOE, конкретная реализация управления контекстом также зависит от архитектуры: как уже упоминалось, в x86/mips32/riscv32 для самоловушки используются, соответственно, инструкции int/syscall/ecall, а в native соответствующую функциональность можно даже эмулировать с помощью некоторых «волшебных» библиотечных функций; при этом конкретное содержимое контекста, очевидно, тоже различается для разных архитектур (например, уже сами регистры отличаются). Поэтому мы можем выделить функциональность управления контекстом в новый класс API в AM под названием CTE (ConText Extension).
Следующий вопрос: как абстрагировать функциональность управления контекстом разных архитектур в единый API? Другими словами, нужно подумать, какая информация на самом деле требуется процессу обработки в операционной системе?
- Прежде всего, разумеется, это причина, вызвавшая данное переключение потока исполнения: деление на ноль, недопустимая инструкция, срабатывание точки останова, или же программа добровольно провалилась в операционную систему? В зависимости от причины операционная система будет действовать по-разному.
- Далее — контекст программы. В процессе обработки операционная система может считывать некоторые регистры из контекста и использовать их информацию для дальнейшей обработки. Например, операционная система считывает недопустимую инструкцию, на которую указывает PC, и проверяет, можно ли эмулировать её выполнение. На самом деле, опираясь на этот контекст, операционная система может реализовывать и некоторые «волшебные» возможности — подробнее об этом вы узнаете в PA4.
Эмуляция инструкций программным способом
В некоторых встраиваемых сценариях к процессору предъявляются очень строгие требования по низкому энергопотреблению, и во многих случаях блок обработки чисел с плавающей точкой (FPU) вообще убирают ради экономии энергии. В этом случае, если программное обеспечение попытается выполнить инструкцию с плавающей точкой, процессор выбросит исключение недопустимой инструкции. Имея механизм реагирования на исключения, мы можем эмулировать выполнение этой недопустимой инструкции в процессе обработки исключения — принцип очень похож на процесс выполнения инструкций из PA2. Таким способом инструкции с плавающей точкой можно выполнять на самых разных процессорах без FPU.
Выполнение инструкций с плавающей точкой в AM — это неопределённое поведение (UB)
Другими словами, среда исполнения AM не поддерживает числа с плавающей точкой. Звучит слишком радикально. Причина такого решения в том, что IEEE 754 — это промышленный стандарт, и ради формальной логической строгости (soundness) и полноты (completeness) в стандарте могут встречаться самые разные странные особенности, например, разные режимы округления, введение inf и nan и так далее — для учебных целей на самом деле нет необходимости разбираться во всех этих деталях; но если вы хотите реализовать корректный FPU, обойти эти детали не получится.
В отличие от инструкций с фиксированной точкой из PA2, инструкции с плавающей точкой в PA используются довольно редко, и у нас есть другие способы обойти эту проблему, поэтому мы выбрали самый простой путь — объявить это неопределённым поведением (UB). Разумеется, если вам интересно, вы также можете попробовать реализовать упрощённую версию FPU. В конце концов, раз это UB, то если ваш FPU ведёт себя корректно, это тоже не будет нарушением правил.
Ещё одно неопределённое поведение
Ещё одно UB, с которым вы можете столкнуться, это переполнение стека, да, тот самый stackoverflow. Для обнаружения переполнения стека требуется гораздо более мощная среда исполнения, и AM, разумеется, на это не способна, так что пусть это будет UB.
Но всё же, какой объём стекового пространства AM на самом деле предоставляет программам? На самом деле, если во время PA2 вы старательно вникали в каждую деталь, вы уже знаете ответ на этот вопрос; если нет — стоит задуматься о себе и как следует изучить RTFSC (Read The F Source Code).
Итак, если абстрагировать эти два вида информации в единое представление, можно определить API для CTE. Для причины переключения достаточно определить единый способ её описания. CTE определяет структуру данных под названием «событие» следующим образом (см. abstract-machine/am/include/am.h):
typedef struct Event {
  enum { ... } event;
  uintptr_t cause, ref;
  const char *msg;
} Event;
Здесь event обозначает номер события, cause и ref — дополнительная информация, описывающая событие, а msg — строка с информацией о событии; в рамках PA мы будем использовать только event. Далее достаточно определить несколько единых номеров событий (вышеупомянутые константы перечисления) и заставить каждую архитектуру при реализации своего CTE API единообразно описывать причину переключения потока исполнения через указанную структуру — так и будет реализована абстракция причины переключения.
Что касается контекста, мы можем лишь унифицировать имя типа структуры, описывающей контекст, назвав его Context, а вот дальнейшая абстракция его конкретного содержимого невозможна. В первую очередь это связано с тем, что различия в информации о контексте между разными архитектурами слишком велики — например, в mips32 имеется 32 регистра общего назначения, и уже одного этого факта достаточно, чтобы Context для mips32 и x86 в принципе не могли быть абстрагированы в полностью единую структуру. Поэтому в AM конкретные члены Context определяются каждой архитектурой самостоятельно — например, структура Context для x86-nemu определена в abstract-machine/am/include/arch/x86-nemu.h. Из этого следует, что прямое обращение к членам Context в коде операционной системы является архитектурно-зависимым поведением, которое подрывает переносимость операционной системы. Однако в большинстве случаев операционной системе не требуется по отдельности обращаться к членам структуры Context. CTE также предоставляет ряд интерфейсов, позволяющих операционной системе обращаться к ним при необходимости, тем самым обеспечивая архитектурную независимость соответствующего кода операционной системы.
Наконец, есть ещё два унифицированных API:
bool cte_init(Context* (*handler)(Event ev, Context *ctx))используется для выполнения инициализации, связанной с CTE. Он также принимает указатель на функцию обратного вызова для обработки событий со стороны операционной системы: при возникновении события CTE вызовет эту функцию обратного вызова, передав ей событие и связанный с ним контекст в качестве аргументов, поручая дальнейшую обработку операционной системе.void yield()используется для выполнения операции самоловушки, вызывая событие с номеромEVENT_YIELD. Разные ISA используют разные инструкции самоловушки для запуска операции самоловушки — за подробностями реализации обращайтесь к RTFSC.
В CTE есть и другие API, которые пока не используются, поэтому мы не будем их сейчас рассматривать.
Далее попробуем запустить операцию самоловушки через тест yield test из am-tests, чтобы разобраться в деталях этого процесса. Этот тест также поддерживает таймерные и внешние прерывания, но для этого требуется аппаратная поддержка функциональности, связанной с прерываниями, — пока мы не будем этим заниматься.
Обновление am-kernels
Мы обновили код yield test 3 октября 2023 года в 15:35:00. Если вы получили код am-kernels до этого момента, пожалуйста, получите обновлённый код с помощью следующих команд:
cd am-kernels
git pull origin master
Установка адреса входа в исключение
Перед запуском операции самоловушки сначала необходимо установить адрес входа в исключение в соответствии с соглашением ISA, чтобы в будущем при переключении потока исполнения можно было перейти по корректному входу в исключение. Очевидно, это архитектурно-зависимое поведение, поэтому мы помещаем его в CTE, а не поручаем am-tests напрямую устанавливать адрес входа в исключение. Когда мы выбираем yield test, am-tests инициализирует CTE через функцию cte_init(), которая содержит несложный код с раскрытием макросов. В конечном счёте это приводит к вызову функции cte_init(), расположенной в abstract-machine/am/src/$ISA/nemu/cte.c. Функция cte_init() выполняет два действия, первое из которых — установка адреса входа в исключение:
- Для x86 необходимо подготовить осмысленную IDT:
- В коде определяется массив структур
idt, каждый элемент которого — это структура дескриптора шлюза. - В соответствующие элементы массива заносятся осмысленные дескрипторы шлюзов — например, дескриптор шлюза номер
0x81содержит адрес входа операции самоловушки. Обратите внимание, что в коде фреймворка всё равно заполняется полный дескриптор шлюза (включая упомянутые выше поля don't care) — в первую очередь для того, чтобы при DiffTest KVM тоже мог перейти по корректному адресу входа. KVM реализует полный механизм реагирования на исключения x86, и если заполнить только упрощённую версию дескриптора шлюза, код в нём не сможет корректно работать. Но нам не нужно разбираться в этих деталях — достаточно знать, что код уже заполнил корректные дескрипторы шлюзов. - С помощью инструкции
lidtустанавливаются начальный адрес и длинаidtв IDTR.
- В коде определяется массив структур
- Для mips32, поскольку адрес входа в исключение зафиксирован по адресу
0x80000180, нужно разместить по адресу0x80000180инструкцию безусловного перехода, целью которой будет уже настоящий, нужный нам адрес входа в исключение. - Для riscv32 достаточно просто установить адрес входа в исключение непосредственно в регистр
mtvec.
Второе, что делает функция cte_init(), — регистрирует функцию обратного вызова для обработки событий; эта функция обратного вызова предоставляется yield test, подробнее об этом будет рассказано ниже.
Запуск операции самоловушки
После возврата из функции cte_init() yield test вызовет основную тестовую функцию hello_intr(), которая сначала выведет некоторую информацию, а затем через io_read(AM_INPUT_CONFIG) запустит устройство ввода — впрочем, в NEMU этот запуск не выполняет никаких реальных действий. Далее hello_intr() включит прерывания через iset(1), но поскольку мы пока не реализовали функциональность, связанную с прерываниями, эту часть кода тоже можно игнорировать. Наконец, hello_intr() войдёт в основной тестовый цикл: код будет непрерывно вызывать yield() для выполнения операции самоловушки, а чтобы слишком высокая частота вызовов не приводила к слишком быстрому выводу, в основной тестовый цикл добавлен пустой цикл для холостого хода.
Чтобы поддержать операцию самоловушки, а заодно проверить, правильно ли установлен адрес входа в исключение, вам нужно реализовать в NEMU функцию isa_raise_intr() (определена в nemu/src/isa/$ISA/system/intr.c), эмулирующую описанный выше механизм реагирования на исключения.
Обратите внимание:
- PA не затрагивает переключение уровней привилегий, поэтому при чтении RTFM можно не обращать внимания на содержимое, связанное с переключением уровней привилегий.
- Функцию
isa_raise_intr()нужно вызывать именно в реализации инструкции самоловушки, а не реализовывать код механизма реагирования на исключения во вспомогательной функции (helper) для инструкции самоловушки, поскольку далее функцияisa_raise_intr()понадобится нам снова. - Если вы выбрали x86, при индексации IDT по адресу из IDTR необходимо использовать
vaddr_read().
Реализация механизма реагирования на исключения
Вам нужно реализовать упомянутые выше новые инструкции, а также функцию isa_raise_intr(). Затем изучите код cte_init() и найдите соответствующий адрес входа в исключение.
Если вы выбрали mips32 или riscv32, вы обнаружите, что в регистре status/mstatus очень много битов состояния. Однако на данный момент отсутствие реализации функциональности этих битов состояния никак не влияет на выполнение программы, поэтому пока достаточно рассматривать регистр status/mstatus просто как регистр для хранения 32-битных данных.
После реализации заново запустите yield test. Если вы обнаружите, что NEMU действительно переходит по найденному вами адресу входа в исключение, значит, ваша реализация верна (NEMU также может завершить работу из-за срабатывания нереализованной инструкции).
Обеспечить поддержку механизма реагирования на исключения в DiffTest
Чтобы механизм DiffTest работал корректно, вам нужно:
- Для x86:
- В NEMU не реализован механизм сегментации, и понятия регистра cs не существует. Но чтобы DiffTest проходил без сбоев, вам всё же нужно добавить регистр cs в структуру cpu и инициализировать его значением
8. - Поскольку механизм реагирования на исключения x86 требует помещения eflags в стек, вам также нужно инициализировать eflags значением
0x2.
- В NEMU не реализован механизм сегментации, и понятия регистра cs не существует. Но чтобы DiffTest проходил без сбоев, вам всё же нужно добавить регистр cs в структуру cpu и инициализировать его значением
- Для riscv32 нужно инициализировать
mstatusзначением0x1800. - Для riscv64 нужно инициализировать
mstatusзначением0xa00001800.
Сохранение контекста
После успешного перехода по адресу входа в исключение мы начинаем настоящий процесс обработки исключения уже программно. Однако при обработке исключения неизбежно приходится использовать регистры общего назначения, а если посмотреть на текущие регистры общего назначения, в них хранится содержимое, оставшееся до переключения потока исполнения. Это содержимое тоже является частью контекста, и если перезаписать его без сохранения, в будущем восстановить этот контекст будет невозможно. Но обычно аппаратное обеспечение не занимается их сохранением, поэтому их значения нужно сохранять программным кодом. В x86 для этого предусмотрена инструкция pusha, помещающая значения регистров общего назначения в стек; а в mips32 и riscv32 каждый регистр общего назначения по очереди помещается в стек с помощью инструкции sw.
Помимо регистров общего назначения, контекст также включает:
- PC и состояние процессора на момент возникновения исключения. Для x86 это eflags, cs и eip — механизм реагирования на исключения x86 уже сохранил их в стеке; для mips32 и riscv32 это регистры epc/mepc и status/mstatus — механизм реагирования на исключения сохраняет их в соответствующих системных регистрах, и нам ещё нужно считать их оттуда, а затем сохранить в стеке.
- Номер исключения. Для x86 номер исключения сохраняется программно; а для mips32 и riscv32 номер исключения уже сохранён аппаратно в регистре cause/mcause, и нам ещё нужно сохранить его в стеке.
- Адресное пространство. Это подготовка для PA4: в x86 ему соответствует регистр
CR3, и код резервирует место в стеке с помощью инструкцииpushl $0; в mips32 и riscv32 информация об адресном пространстве использует то же место хранения, что и регистр номер 0, — поскольку значение регистра 0 всегда равно 0, его в любом случае не нужно сохранять и восстанавливать. Однако сейчас мы пока не используем информацию об адресном пространстве, так что можно пока не вдаваться в её смысл.
Сохранение номера исключения
x86 сохраняет номер исключения программно, у него нет регистра, подобного cause. Могут ли mips32 и riscv32 поступить так же? Почему?
Итак, всё это вместе составляет полную информацию о контексте: процесс обработки исключения может опираться на контекст для диагностики и обработки, а также эта информация понадобится в будущем при восстановлении контекста.
Сравнение обработки исключений и вызова функций
Мы знаем, что при вызове функции тоже нужно сохранять состояние вызывающей стороны: адрес возврата и регистры, которые согласно calling convention должна сохранять вызывающая сторона. При этом CTE при сохранении контекста сохраняет намного больше информации. Попробуйте сравнить эти два случая и подумайте, чем вызвано различие в объёме сохраняемой информации.
Далее код вызовет C-функцию __am_irq_handle() (определена в abstract-machine/am/src/$ISA/nemu/cte.c) для обработки исключения.
Странный код x86
В trap.S для x86 есть строка кода pushl %esp, поведение которой на первый взгляд выглядит весьма странно. Сможете ли вы, глядя на окружающий её код, понять её поведение? Подсказка: программа — машина состояний.
Реорганизация структуры Context
Ваши задачи следующие:
- Реализовать новые инструкции, необходимые в этом процессе. Подробности см. в RTFM.
- Разобраться в процессе формирования контекста и изучить исходный код (RTFSC), а затем реорганизовать члены структуры
Context, определённой вabstract-machine/am/include/arch/$ISA-nemu.h, так, чтобы порядок их объявления совпадал с контекстом, формируемым вabstract-machine/am/src/$ISA/nemu/trap.S.
Обратите внимание: хотя мы пока временно не используем упомянутую выше информацию об адресном пространстве, при реорганизации структуры Context вам всё равно нужно правильно обработать её положение — иначе в PA4 вы можете столкнуться с труднообъяснимыми ошибками.
После реализации вы можете вывести содержимое контекста c в __am_irq_handle() с помощью printf, а затем с помощью простого отладчика понаблюдать за состоянием регистров в момент срабатывания самоловушки, чтобы проверить корректность вашей реализации Context.
Пара подсказок
Про «реализацию новых инструкций» сказать особо нечего — вы уже реализовали немало инструкций в PA2. «Реорганизация структуры» — очень интересная задача, и если вы не знаете, с чего начать, попробуйте для начала как следует вникнуть в саму формулировку. Смысл задачи примерно таков: на основе содержимого trap.S определить структуру внутри $ISA-nemu.h. trap.S — это явно ассемблерный код, а в $ISA-nemu.h — структура, определённая на языке C. Ассемблерный код и язык C... Постойте, вам, кажется, вспомнилось что-то из учебника ICS...
Я всё поменял наугад, и, надо же, заработало, хе-хе
Если у вас всё ещё сохраняется такой настрой на авось, в PA3 вам придётся очень тяжело. На самом деле «понимание того, как правильно реорганизовать структуру» — крайне важная часть PA3. Поэтому добавим ещё один обязательный вопрос.
Обязательный вопрос (нужно ответить в отчёте о лабораторной работе) — понимание прошлого и настоящего структуры контекста
В __am_irq_handle() вы увидите указатель на структуру контекста c. Где именно находится структура контекста, на которую указывает c? Как вообще возникает эта структура контекста? Конкретнее: у этой структуры контекста много членов — где именно присваивается значение каждому из них? Какая связь существует между этими четырьмя составляющими: $ISA-nemu.h, trap.S, приведённым выше текстом методички и новыми инструкциями, которые вы только что реализовали в NEMU?
Если вы не настолько сообразительны, лучше не пытайтесь просто пристально смотреть на код — чтобы понять детали поведения программы, всё же стоит подходить к этому с точки зрения машины состояний.
Диспетчеризация событий
Код __am_irq_handle() упаковывает причину переключения потока исполнения в событие, а затем вызывает функцию обратного вызова для обработки событий, зарегистрированную в cte_init(), передавая событие для обработки yield test. В yield test этой функцией обратного вызова является функция simple_trap() из am-kernels/tests/am-tests/src/tests/intr.c. Функция simple_trap() выполняет дальнейшую диспетчеризацию в зависимости от типа события. Однако здесь мы столкнёмся с необработанным событием:
AM Panic: Unhandled event @ am-kernels/tests/am-tests/src/tests/intr.c:12
Это происходит потому, что функция __am_irq_handle() в CTE ещё не распознаёт корректно событие самоловушки. Согласно определению yield(), функция __am_irq_handle() должна упаковывать событие самоловушки в событие с номером EVENT_YIELD.
Распознавание события самоловушки
Вам нужно в __am_irq_handle() по номеру исключения распознать исключение самоловушки и упаковать его в событие самоловушки с номером EVENT_YIELD. Заново запустите yield test. Если ваша реализация верна, вы увидите, что после распознавания события самоловушки выводится символ y.
Восстановление контекста
Код вернётся обратно вплоть до __am_asm_trap() в trap.S, и следующим шагом будет восстановление контекста программы. __am_asm_trap() восстановит состояние программы на основе ранее сохранённого содержимого контекста, а затем выполнит «инструкцию возврата из исключения», чтобы вернуться к состоянию программы, предшествовавшему возникновению исключения.
Однако здесь нужно обратить внимание на то, какой именно PC сохраняется инструкцией самоловушки: для инструкции int в x86 сохраняется PC, указывающий на следующую инструкцию, — это немного похоже на вызов функции; а для syscall в mips32 и ecall в riscv32 сохраняется PC самой инструкции самоловушки, поэтому программному обеспечению нужно в подходящем месте прибавить 4 к сохранённому PC, чтобы в будущем вернуться к инструкции, следующей за инструкцией самоловушки.
Взгляд на операцию «прибавить 4» с точки зрения CISC и RISC
На самом деле самоловушка — это лишь один из типов исключений. Существует ещё тип исключений-сбоев (fault), у которых возвращаемый PC совпадает с PC, вызвавшим исключение, — например, исключение отсутствия страницы (page fault): после того как система устранит сбой, будет заново выполнена та же самая инструкция для повторной попытки, поэтому к PC при возврате из исключения не нужно прибавлять 4. Таким образом, в зависимости от типа исключения иногда нужно прибавлять 4, а иногда — нет.
В связи с этим стоит задуматься над таким вопросом: кто решает, прибавлять 4 или нет — аппаратное обеспечение или программное? Подходы CISC и RISC здесь прямо противоположны: в CISC это целиком отдаётся на откуп аппаратному обеспечению, а в RISC — программному. Подумайте, какие компромиссы есть у каждого из этих двух подходов? Какой из них вы считаете более разумным? Почему?
В конце концов код вернётся к тому месту в yield test, где была запущена самоловушка, и продолжит выполнение. С его точки зрения, это путешествие сквозь пространство и время как будто и не происходило вовсе.
Восстановление контекста
Вам нужно реализовать новые инструкции, задействованные в этом процессе. Заново запустите yield test. Если ваша реализация верна, yield test будет непрерывно выводить y.
Обязательный вопрос (нужно ответить в отчёте о лабораторной работе) — понимание путешествия сквозь пространство и время
С момента вызова yield() в yield test и до момента возврата из yield() — что именно происходит в этом путешествии? Как программное обеспечение (AM, yield test) и аппаратное обеспечение (NEMU) взаимодействуют друг с другом, чтобы совершить это путешествие? Вам нужно объяснить каждую деталь этого процесса, включая поведение каждой задействованной строки ассемблерного/C-кода, особенно некоторых ключевых инструкций/переменных. На самом деле предыдущий обязательный вопрос «понимание прошлого и настоящего структуры контекста» уже охватывает часть этого путешествия, и вы можете включить его ответ сюда.
Не пугайтесь фразы «каждая строка кода» — этот процесс занимает всего около 50 строк кода, и полностью и досконально его понять вполне реально. Мы включили этот обязательный вопрос именно для того, чтобы заставить вас чётко разобраться в каждой детали этого процесса. Это понимание настолько важно, что без него в дальнейшем вы будете практически бессильны перед багами.
Задержанные слоты mips32 и исключения
В PA2 мы упоминали, что стандартные процессоры mips32 используют технологию задержанного слота ветвления (branch delay slot). Подумайте: если стандартный процессор mips32 вызовет исключение при выполнении инструкции в задержанном слоте, какие проблемы могут возникнуть после возврата из исключения? Как это можно решить? Попробуйте сверить своё решение с RTFM.
Следы обработки исключений — etrace
Исключения, выбрасываемые процессором, тоже отражают поведение выполнения программы, поэтому мы можем вести журнал следов обработки исключений (exception trace). Возможно, вам кажется, что вывод информации через printf() в CTE может дать похожий эффект, но у этого подхода всё же есть следующие отличия от etrace, реализованного в NEMU:
- Включение etrace не меняет поведение программы (для программы это неинвазивно): в будущем вы можете столкнуться с багами, поведение которых изменится, стоит вам вставить
printf(). Для таких багов etrace всё равно поможет вам с диагностикой, поскольку вывод происходит внутри NEMU и не меняет поведение программы. - etrace также не зависит от поведения программы: если программа содержит какой-то фатальный баг, из-за которого не удаётся войти в функцию обработки исключения, то вызвать
printf()в CTE для вывода будет невозможно; в этом случае etrace продолжит работать нормально.
На самом деле QEMU и Spike тоже реализуют функциональность, аналогичную etrace: если в работающем на них системном программном обеспечении возникает ошибка, разработчики также могут с помощью этих функций быстро локализовать и диагностировать баг.
Реализация etrace
Вы уже реализовали в NEMU немало инструментов трассировки, так что реализовать etrace для вас, естественно, не составит труда.
Дружеское напоминание
На этом первый этап PA3 завершён.