
Мультипрограммирование
Заявление о снятии с себя ответственности
Начиная с PA4 методичка больше не будет давать безупречно подробные указания по коду — некоторые ключевые детали кода вам нужно будет обдумать и опробовать самостоятельно (мы намеренно их опустили). В методичке мы чётко изложим принципы соответствующих технологий, и вам сначала нужно понять эти принципы, а затем на основе понимания читать и писать соответствующий код.
Одной фразой: вместо того чтобы жаловаться на неясность методички, лучше побольше думать самостоятельно. Раз уж мы дошли до PA4, то ради того, чтобы оценки соответствовали нормальному распределению, за высокий балл в любом случае придётся приложить больше усилий. Если раньше вы искали способы схитрить, а не пытались глубоко понять, как работает система, — сейчас у вас, скорее всего, уже не получится.
При поддержке Nanos-lite мы уже успешно запустили в NEMU систему пакетной обработки и заставили работать Chinese Paladin! Это показывает, что построенная нами собственными руками NEMU — с виду простая машина — способна поддерживать выполнение настоящих программ ничуть не хуже настоящей машины! Однако эта система пакетной обработки пока что может выполнять только одну программу одновременно: следующая программа начинает выполняться лишь после того, как завершится предыдущая.
Это как раз и есть один из недостатков системы пакетной обработки: если текущая программа ожидает ввода-вывода, вся система из-за этого простаивает. В реальных компьютерах ввод-вывод очень медленный по сравнению с производительностью CPU: например, одна операция чтения/записи на диске занимает около 5 миллисекунд, но для процессора с частотой 2 ГГц это означает ожидание завершения дисковой операции в течение 10 000 000 тактов. Однако вместо того, чтобы позволять системе бессмысленно простаивать, гораздо лучше использовать это время для какой-то полезной работы. Простая идея: в начале работы системы загрузить сразу несколько программ, затем запустить первую; когда первой программе нужно ждать ввода-вывода, переключиться на вторую программу для выполнения; когда второй программе тоже нужно ждать, переключиться на следующую программу, и так далее.
Это и есть базовая идея системы мультипрограммирования (multiprogramming). Идея мультипрограммирования звучит просто, но это уже разновидность многозадачной системы, поскольку она уже содержит базовые элементы многозадачной системы. Другими словами, чтобы реализовать операционную систему с мультипрограммированием, нам достаточно реализовать следующие два пункта:
- В памяти могут одновременно существовать несколько процессов
- При выполнении определённых условий поток исполнения можно переключать между этими процессами
Смена терминологии
Раз уж это многозадачная система, то в ней работает не одна программа. Теперь мы можем напрямую использовать понятие «процесс».
Реализовать первый пункт несложно: достаточно, чтобы загрузчик (loader) загружал разные процессы в разные области памяти. Процесс загрузки процесса по сути сводится к нескольким операциям копирования памяти, так что здесь нет ничего сложного.
На самом деле я вас обманываю!
Для нашей текущей реализации компьютерной системы «загрузка разных процессов в разные области памяти» на самом деле довольно хлопотное дело. Можете понять почему? Если не получается — не страшно, мы подробно обсудим этот вопрос на следующем этапе.
Для простоты мы можем прямо в операционной системе определить несколько тестовых функций и использовать их в качестве программ, ведь программа по сути — это осмысленная последовательность инструкций, и пока нас не волнует, откуда эта последовательность взялась. Однако есть один момент, на который стоит обратить внимание, — стек: нам нужно выделить каждому процессу собственное стековое пространство.
Почему нужно использовать разные стековые пространства?
Что произойдёт, если разные процессы будут использовать общее стековое пространство?
На самом деле, гораздо большего размышления требует второй пункт: на первый взгляд, «как переключать поток исполнения между процессами» — дело совсем не интуитивное.
Переключение контекста
В PA3 мы уже упоминали переключение потока исполнения между операционной системой и пользовательским процессом и вводили понятие «контекста»: по сути, контекст — это состояние процесса. Другими словами, сейчас нам нужно подумать, как переключать контекст между несколькими пользовательскими процессами.
Чтобы помочь вам разобраться в этом вопросе, мы подготовили в am-kernels небольшую операционную систему yield-os примерно на 30 строк. Она создаёт два потока исполнения, которые при поддержке CTE поочерёдно выводят A и B. Вы можете запустить yield-os на native, чтобы посмотреть на её поведение.
Обновите am-kernels
Мы добавили код yield-os в am-kernels 3 октября 2023 года в 15:35:00. Если вы получили код am-kernels раньше этого времени, пожалуйста, получите обновлённый код следующей командой:
cd am-kernels
git pull origin master
Основной принцип
На самом деле, имея CTE, у нас появляется очень изящный способ реализовать переключение контекста. А именно: предположим, что во время выполнения процесса A происходит системный вызов, который через инструкцию самозахвата (trap) уводит выполнение в ядро. Согласно коду __am_asm_trap(), структура контекста A (Context) будет сохранена на стеке A. В PA3 после обработки системного вызова __am_asm_trap() восстанавливает контекст A на основе структуры контекста, сохранённой на стеке. А вот и волшебство: что произойдёт, если мы не будем спешить восстанавливать контекст A, а вместо этого сначала переключим указатель вершины стека на стек другого процесса B? Поскольку на стеке B хранится структура контекста, ранее сохранённая самим B, последующие операции восстановят контекст B именно на основе этой структуры. После возврата из __am_asm_trap() мы уже выполняем процесс B!
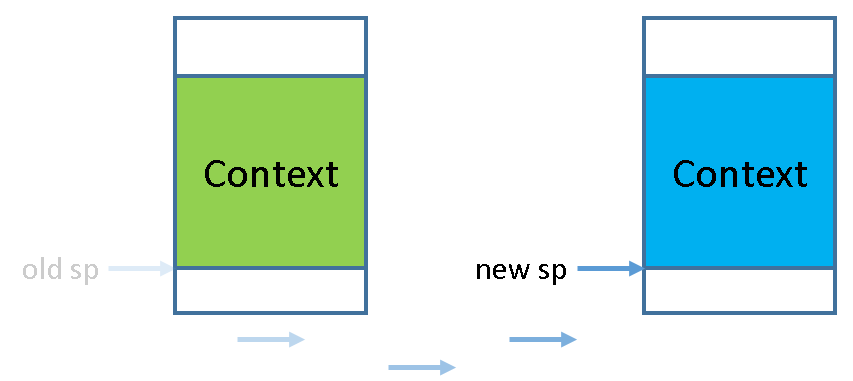
Так куда же делся процесс A? Не переживайте, он просто временно «приостановлен». Перед тем как быть приостановленным, он уже сохранил структуру контекста на своём стеке. Если в какой-то момент в будущем указатель вершины стека переключат обратно на стек A, код восстановит контекст A на основе структуры контекста на стеке, и A будет разбужен и продолжит выполнение. Таким образом, переключение контекста — это, по сути, переключение стека между разными процессами!
Блок управления процессом
Но как нам найти структуру контекста другого процесса? Заметьте, что структура контекста хранится на стеке, а стековое пространство довольно велико. Из-за влияния стековых кадров, формируемых вызовами функций, позиция сохранения структуры контекста каждый раз не фиксирована. Естественно, нам нужен указатель cp (context pointer), чтобы запоминать позицию структуры контекста. Когда нужно найти структуру контекста другого процесса, достаточно найти относящийся к этому процессу указатель cp.
На самом деле, довольно много информации связано именно с процессом: помимо только что упомянутого указателя контекста cp, это относится и к упомянутому выше стековому пространству. Чтобы удобно управлять всей этой связанной с процессом информацией, операционная система использует структуру данных под названием блок управления процессом (PCB, process control block), поддерживая по одному PCB для каждого процесса. В коде yield-os уже определена нужная нам структура PCB:
typedef union {
  uint8_t stack[STACK_SIZE];
  struct {
    Context *cp;
  };
} PCB;
Код использует объединение (union), чтобы разместить прочую информацию в самом низу стека процесса. Код выделяет каждому процессу стек размером 32 КБ, чего вполне достаточно — переполнения стека, приводящего к неопределённому поведению (UB), не возникнет. При переключении контекста достаточно вернуть указатель cp из PCB функции __am_irq_handle() в CTE, а оставшаяся часть кода восстановит контекст на основе структуры контекста. Прибегнув лишь к небольшой доле математической индукции, мы можем убедиться, что этот процесс всегда корректен для выполняющегося процесса.
Так как же нам переключиться на только что загруженный процесс, чтобы заставить его выполняться?
Поток ядра
Создание контекста потока ядра
Ответ прост: нам достаточно вручную создать структуру контекста на стеке процесса, чтобы при будущем переключении можно было корректно восстановить контекст на её основе.
Как упоминалось выше, мы сначала используем несколько напрямую определённых в операционной системе тестовых функций в качестве программ. yield-os предоставляет тестовую функцию f(), и наша следующая задача — создать для неё контекст, а затем переключиться на неё для выполнения. У такого потока исполнения есть специальное название — «поток ядра» (kernel thread).
Почему не называется «процесс ядра»?
Этот вопрос по сути эквивалентен вопросу «в чём разница между процессом и потоком» — неплохой вопрос. К тому же это ещё и типичный «шаблонный» вопрос для вступительных экзаменов в аспирантуру, так что через STFW вы наверняка найдёте множество самых разных ответов, например: «поток более лёгковесный», «у потока нет отдельных ресурсов» и так далее.
Если пытаться подробнее объяснить, «что значит лёгковесный» и «что подразумевается под отдельными ресурсами», в рамках PA это может оказаться непросто. Однако в PA углубляться в этот вопрос не обязательно — пока достаточно рассматривать оба этих понятия как потоки исполнения. Что важнее, вы реализуете и то, и другое — разве не лучше почувствовать разницу между ними прямо в коде, на собственном опыте? Кроме того, неплохо будет пойти с этим вопросом на курс операционных систем в следующем семестре.
Создание контекста для потока ядра реализуется через функцию kcontext(), предоставляемую CTE (определена в abstract-machine/am/src/$ISA/nemu/cte.c), где «k» означает «kernel» (ядро). Прототип kcontext():
Context* kcontext(Area kstack, void (*entry)(void *), void *arg);
Здесь kstack — это диапазон стека, entry — точка входа потока ядра, а arg — параметр потока ядра. Кроме того, kcontext() требует, чтобы поток ядра не возвращался из entry, иначе поведение будет неопределённым. Вам нужно создать структуру контекста в самом низу kstack с точкой входа entry (пока можете игнорировать параметр arg), а затем вернуть указатель на эту структуру.
yield-os вызывает kcontext() для создания контекста и записывает возвращённый указатель в поле cp структуры PCB:
|               |
+---------------+ <---- kstack.end
|               |
|    context    |
|               |
+---------------+ <--+
|               |    |
|               |    |
|               |    |
|               |    |
+---------------+    |
|       cp      | ---+
+---------------+ <---- kstack.start
|               |
Планирование потоков/процессов
Создание и переключение контекста — задача CTE, а вот выбор того, на какой именно контекст переключиться, определяет операционная система — эта задача называется планированием процессов (process scheduling). Планирование процессов выполняется функцией schedule(), которая возвращает контекст процесса, подлежащего планированию. Поэтому нам нужен способ отслеживать, какой процесс сейчас выполняется, чтобы в schedule() мы могли вернуть контекст другого процесса и добиться эффекта многозадачности. Эта задача решается с помощью указателя current, который указывает на PCB текущего выполняемого процесса. Таким образом, в schedule() мы можем с помощью current решить, какой процесс планировать следующим. Однако перед планированием нам также нужно сохранить указатель контекста текущего процесса в его PCB:
// save the context pointer
current->cp = prev;

// switch between pcb[0] and pcb[1]
current = (current == &pcb[0] ? &pcb[1] : &pcb[0]);

// then return the new context
return current->cp;
Пока мы заставляем schedule() всегда переключаться на другой процесс. Обратите внимание, что контекст выбранного процесса создаётся через kcontext(), а решение переключиться на него принимается уже в schedule(), и лишь затем в __am_asm_trap() CTE происходит фактическое восстановление этого контекста.
Разделение механизма и политики
На самом деле это отражает важный принцип проектирования систем: разделение (декомпозицию) механизма и политики. Механизм решает вопрос «можно ли это сделать», а политика решает вопрос «как сделать это хорошо». Очевидно, что политика опирается на механизм, а механизму нужна политика, чтобы проявить свой эффект максимально полно.
Польза от такого разделения очевидна: высокая переиспользуемость кода и лёгкость понимания. В Project-N это разделение доведено почти до предела: механизм и политика разнесены по двум разным подпроектам. Например, механизм «переключения контекста» реализован в CTE в AM — он позволяет системе делать «переключение потоков исполнения»; а вот на какой именно поток исполнения переключаться — это уже реализовано в операционной системе.
Другое преимущество AM — то, что она абстрагирует поведение нижележащего железа в системные механизмы, а приложениям на AM (включая ОС) достаточно вызывать эти системные механизмы и реализовывать соответствующие политики. Разумеется, сейчас политика в schedule() очень простая, но лабораторные работы по ОС в следующем семестре, и даже более сложные политики планирования процессов из реального мира, можно реализовать поверх того же самого механизма, предоставляемого AM.
Реализуйте переключение контекста
Основываясь на изложенном выше содержании методички, реализуйте следующую функциональность:
- Функцию
kcontext()в CTE - Измените реализацию
__am_asm_trap()в CTE так, чтобы после возврата из__am_irq_handle()сначала указатель вершины стека переключался на структуру контекста нового процесса, и только затем восстанавливался контекст — так завершается сущностная операция переключения контекста
После правильной реализации вы увидите, что yield-os непрерывно выводит ? — это потому, что мы ещё не реализовали функциональность параметров для kcontext(), но вывод этих ? уже показывает, что CTE в текущем состоянии корректно переключается из функции main() yield-os в один из потоков ядра.
Подсказка о kcontext()
Мы хотим, чтобы код после возврата из __am_asm_trap() в будущем начинал выполнять f(). Другими словами, нам нужно построить в kcontext() контекст, который обозначает некое состояние, начиная с которого можно корректно начать выполнение f(). Поэтому вам нужно подумать: чтобы можно было корректно начать выполнение f(), каким именно условиям должно удовлетворять это состояние?
Что касается «сначала переключить указатель вершины стека на структуру контекста нового процесса» — естественный вопрос: где находится структура контекста нового процесса? Как её найти? И как именно нужно переключить туда указатель вершины стека? Если вы обнаружите, что код «улетел» в неизвестном направлении, не забывайте: программа — это конечный автомат.
Для совместимости с DiffTest
Чтобы гарантировать корректную работу DiffTest, в зависимости от выбранной вами ISA вам также нужно выполнить дополнительные настройки:
- x86: установить
csв структуре контекста равным8. - riscv32: установить
mstatusв структуре контекста равным0x1800. - riscv64: установить
mstatusв структуре контекста равным0xa00001800.
Параметры потока ядра
Чтобы потоки ядра yield-os могли корректно выводить символы, нам нужно передать параметр в f() через kcontext(). Значит, нужно продолжить думать: как f() будет считывать свой параметр? О, разве это не про соглашения о вызовах? Вы уже прекрасно с ними знакомы. Нам достаточно заставить kcontext() разместить arg в правильном месте согласно соглашению о вызовах, и тогда при выполнении f() сможет получить корректный параметр.
Соглашения о вызовах для mips32 и riscv32
Мы не привели соглашения о вызовах для MIPS32 и RISC-V32. Вам нужно обратиться к соответствующим руководствам ABI. Конечно, вы также можете самостоятельно поэкспериментировать, чтобы вывести правила передачи параметров.
Реализуйте переключение контекста (2)
Основываясь на изложенном выше содержании методички, измените функцию kcontext() в CTE так, чтобы она поддерживала передачу параметра arg.
Поскольку f() каждый раз после вывода сообщения вызывает yield(), как только мы правильно реализуем передачу параметров потокам ядра, мы сможем наблюдать, как yield-os переключается туда-обратно между двумя потоками ядра.
В реальных операционных системах многие фоновые задачи, службы-демоны и драйверы в ядре существуют именно в форме потоков ядра. Если вы выполните ps aux, вы увидите в системе множество потоков ядра, у которых в столбце COMMAND название заключено в квадратные скобки (например, [kthreadd]). А принципы их создания и выполнения очень похожи на содержание описанного выше упражнения (хотя конкретная реализация, конечно же, будет отличаться).
Сохраните свойства kcontext()
Определяя поведение kcontext(), AM также требует, чтобы kcontext() размещала на стеке только одну структуру контекста и не могла размещать что-либо ещё. У такого требования есть два преимущества:
kcontext()записывает на стек только содержимое одной структуры контекста, не вызывая других побочных эффектов- ОС может предсказать возвращаемое значение после вызова
kcontext()и использовать это детерминированное свойство для некоторых проверок или упрощения отдельных реализаций
Мы знаем, что x86 передаёт параметры через стек. Если kcontext() нужно поддерживать передачу arg, ей придётся разместить на стеке дополнительное содержимое, что нарушит указанную выше детерминированность. Однако в PA это не приведёт к фатальным проблемам, поэтому мы не требуем, чтобы ваша реализация kcontext() строго соблюдала эту детерминированность. Тем не менее вы всё же можете подумать, как реализовать передачу параметров, соблюдая детерминированность.
Одно из решений — ввести вспомогательную функцию, чтобы отложить фактическую передачу параметров с момента вызова kcontext() до момента выполнения потока ядра. А именно: мы можем в kcontext() сначала установить точкой входа потока ядра вспомогательную функцию, а параметр разместить в каком-нибудь доступном регистре. После этого поток ядра начнёт выполняться со вспомогательной функции, и уже она переложит ранее установленный параметр из регистра на стек, а затем вызовет настоящую функцию входа потока (f()). Это решение имеет некоторое сходство с загрузкой пользовательских программ в Linux: пользовательская программа при запуске тоже не начинает напрямую с функции main(), а сначала выполняется, начиная с _start(), определённой в CRT, выполняя ряд операций инициализации, включая установку параметров, и лишь затем вызывает функцию main().
Если выбранная вами ISA — x86, можете попробовать реализовать указанную выше вспомогательную функцию в CTE. Учитывая, что требуется напрямую манипулировать регистрами и стеком, эту вспомогательную функцию уместнее написать на ассемблере. Впрочем, поскольку функциональность этой вспомогательной функции довольно простая, вам понадобится всего несколько инструкций, чтобы её реализовать.
Переключение контекста в ОС
yield-os — это очень маленькая ОС, у которой, помимо переключения контекста, нет других функций, но она помогает нам сосредоточиться на понимании ключевых деталей переключения контекста. Разобравшись в этих деталях, мы также сможем быстро перенести эти принципы на более крупные ОС.
RT-Thread (необязательно)
RT-Thread — это популярная коммерческая встраиваемая ОС реального времени с полноценными функциональными модулями ОС. Она может адаптироваться к самым разным платам для разработки и поддерживать выполнение различных приложений.
В RT-Thread есть два слоя абстракции: BSP (Board Support Package, пакет поддержки платы) и libcpu. BSP определяет общий набор API для плат самых разных моделей и реализует ядро RT-Thread на основе этого набора API; а для конкретной платы достаточно реализовать соответствующий API, чтобы запустить ядро RT-Thread на этой плате. libcpu, в свою очередь, определяет общий набор API для различных архитектур CPU, и ядро RT-Thread тоже вызывает некоторые API из него. Эта идея очень похожа на AM. Конечно, BSP предназначен не только для реальных плат, но также может соответствовать эмуляторам вроде QEMU, ведь ядру RT-Thread не нужно заботиться о том, является ли нижележащая платформа реальной платой.
Мы перенесли RT-Thread на AM; шаги для компиляции и запуска этого RT-Thread следующие:
Склонируйте перенесённый репозиторий RT-Thread, выполнив следующую команду в другом каталоге, поскольку код RT-Thread не нужно упаковывать и отправлять на проверку:
cd ~/Templates
git clone git@github.com:NJU-ProjectN/rt-thread-am.git
Для компиляции кода вам также нужно установить инструмент сборки проекта
scons:apt-get install sconsВыполните
make initв каталогеrt-thread-am/bsp/abstract-machine/, чтобы выполнить некоторые подготовительные действия перед компиляцией. Эту команду нужно выполнить только один раз, повторно выполнять её перед последующими компиляциями и запусками не требуется.Скомпилируйте или запустите RT-Thread в том же каталоге командой вроде
make ARCH=native. Вывод по умолчанию выглядит так:heap: [0x01000000 - 0x09000000] \ | / - RT - Thread Operating System / | \ 5.0.1 build Oct 2 2023 20:51:10 2006 - 2022 Copyright by RT-Thread team Assertion fail at rt-thread-am/bsp/abstract-machine/src/context.c:29После запуска срабатывает assertion — это потому, что часть функциональности в коде нужно реализовать вам самим.
Мы убрали из оригинального проекта все BSP и libcpu, а затем добавили специальный BSP, реализовав API BSP через API AM — подробности см. в коде в каталоге rt-thread-am/bsp/abstract-machine/. Использованные API AM таковы:
- Куча (heap) TRM используется для реализации кучи в RT-Thread
putch()из TRM используется для реализации вывода через последовательный порт в RT-Thread- IOE пока не используется
iset()из CTE используется для реализации включения/выключения прерываний в RT-Thread- Через CTE реализуется функциональность создания и переключения контекста в RT-Thread. Эта часть кода не реализована — мы оставили её в качестве необязательного задания.
Для создания контекста вам нужно реализовать функцию rt_hw_stack_init() в rt-thread-am/bsp/abstract-machine/src/context.c:
rt_uint8_t *rt_hw_stack_init(void *tentry, void *parameter, rt_uint8_t *stack_addr, void *texit);
Её функция — создать контекст с точкой входа tentry и параметром parameter, используя stack_addr как дно стека, и вернуть указатель на эту структуру контекста. Кроме того, если поток ядра, соответствующий контексту, вернётся из tentry, будет вызван texit, и RT-Thread гарантирует, что код не вернётся из texit.
Обратите внимание:
- Переданный
stack_addrможет не иметь никаких ограничений по выравниванию, поэтому лучше сначала выровнять его поsizeof(uintptr_t), а затем уже использовать. kcontext()в CTE требует, чтобы возврат из точки входа был невозможен, поэтому для поддержки функциональностиtexitнужен новый способ. Один из способов — построить функцию-обёртку, которая будет вызыватьtentry, а после возврата изtentryвызыватьtexit, а затем использовать эту функцию-обёртку в качестве настоящей точки входа дляkcontext(). Однако для этого также требуется передать функции-обёртке три параметра —tentry,parameterиtexit. Как решить эту проблему передачи параметров?
Для переключения контекста вам нужно реализовать функции rt_hw_context_switch_to() и rt_hw_context_switch() в rt-thread-am/bsp/abstract-machine/src/context.c:
void rt_hw_context_switch_to(rt_ubase_t to);
void rt_hw_context_switch(rt_ubase_t from, rt_ubase_t to);
Здесь тип rt_ubase_t на самом деле является unsigned long, а to и from — это указатели на переменные-указатели контекста (указатели второго уровня). rt_hw_context_switch_to() используется для переключения на контекст, на который указывает переменная-указатель контекста, на которую указывает to, а rt_hw_context_switch() дополнительно должна записать указатель текущего контекста в переменную-указатель контекста, на которую указывает from. Для переключения мы можем через yield() вызвать самозахват, а после распознавания события EVENT_YIELD в функции обратного вызова обработчика событий ev_handler() обработать to и from. Аналогично, нам нужно подумать, как передать эти два параметра, to и from, в ev_handler(). В rt-thread-am/bsp/abstract-machine/src/context.c есть ещё функция rt_hw_context_switch_interrupt(), но в текущей работе RT-Thread она не вызывается, так что пока её можно игнорировать.
Как показывает анализ, реализация обеих указанных выше функций требует решения некоторых специфических проблем передачи параметров. Для переключения контекста, на примере rt_hw_context_switch(), нам нужно вызвать yield() внутри rt_hw_context_switch(), а затем получить from и to в ev_handler(). rt_hw_context_switch() и ev_handler() — это две разные функции, но из-за наличия механизма CTE rt_hw_context_switch() не может напрямую вызвать ev_handler(). Поэтому один из прямых способов — передавать информацию через глобальные переменные.
Опасные глобальные переменные
У глобальной переменной во всей системе есть только одна копия, и если во всей системе только один поток, это обычно безопасно. Все программы, которые мы писали на курсе языка C, относятся именно к такому случаю, поэтому использование глобальных переменных не вызывает явных проблем с корректностью. Но если в системе есть несколько потоков и периоды их использования одной и той же глобальной переменной пересекаются, могут возникнуть проблемы.
Впрочем, наше текущее железо пока не реализует прерывания и не поддерживает несколько процессоров, так что с точки зрения модели программирования это похоже на курс языка C, поэтому использовать глобальные переменные для решения этой задачи пока допустимо.
Опасные глобальные переменные (2)
Если для передачи информации используются глобальные переменные, рассмотрите следующие сценарии — какие проблемы могут возникнуть?
- В многопроцессорной системе два процессора одновременно вызывают
rt_hw_context_switch() - Один поток вызвал
rt_hw_context_switch()и записал значение в глобальную переменную, но тут же наступает таймерное прерывание, заставляющее систему переключиться на другой поток, а этот поток тоже вызываетrt_hw_context_switch()
Но для создания контекста проблема ещё сложнее: поток, вызывающий rt_hw_stack_init(), и поток, выполняющий функцию-обёртку, — это не один и тот же поток.
Опасные глобальные переменные (3)
Если для передачи информации используются глобальные переменные, а код подряд дважды вызывает rt_hw_stack_init(), к каким проблемам это приведёт?
Поэтому нам нужно найти другое решение. Оглядываясь назад: причина, по которой глобальные переменные создают проблемы, в том, что они разделяются между несколькими потоками. Чтобы получить правильное решение, нужно поступить наоборот: использовать хранилище, которое не разделяется между несколькими потоками. Хе-хе, на самом деле оно уже упоминалось ранее — это стек! Нам достаточно заставить rt_hw_stack_init() разместить три параметра функции-обёртки на стеке контекста, и в будущем, когда функция-обёртка будет выполняться, она сможет извлечь эти три параметра со стека, при этом другие потоки в системе не смогут получить к ним доступ.
Наконец, нужно учесть и проблему количества параметров: kcontext() требует, чтобы функция входа принимала только один параметр типа void *. Однако мы можем сами договориться, каким типом интерпретировать этот параметр (целое число, символ, строка, указатель — что угодно подойдёт), и тогда это становится обычной задачей по программированию на C.
Реализуйте создание и переключение контекста RT-Thread через CTE
Реализуйте соответствующий код на основе изложенного выше. Для реализации rt_hw_stack_init() мы уже указали верное направление решения проблемы, но не указали все детали, связанные с реализацией, — остальное оставляем вам для анализа и решения, это также проверка того, поняли ли вы каждую деталь этого процесса.
После реализации попробуйте запустить RT-Thread в NEMU. Мы уже встроили в перенесённый RT-Thread несколько команд Shell. Если ваш код реализован верно, вы увидите, что RT-Thread после запуска последовательно выполнит эти команды и в конце выведет приглашение командной строки msh >:
heap: [0x01000000 - 0x09000000]

 \ | /
- RT -     Thread Operating System
 / | \     5.0.1 build Oct  2 2023 20:51:10
 2006 - 2022 Copyright by RT-Thread team
[I/utest] utest is initialize success.
[I/utest] total utest testcase num: (0)
Hello RISC-V!
msh />help
RT-Thread shell commands:
date       - get date and time or set (local timezone) [year month day hour min sec]

......

msh />utest_list
[I/utest] Commands list :
msh />
Поскольку NEMU пока не поддерживает взаимодействие через последовательный порт, мы не можем передать ввод с терминала в RT-Thread. После завершения выполнения всех встроенных команд RT-Thread перейдёт в состояние простоя — в этот момент можно просто выйти из NEMU.
Переключение контекста на native
Поскольку native-версия AM по умолчанию включает прерывания при создании контекста, чтобы успешно запустить поток ядра, созданный на native, вам также нужно распознавать событие таймерного прерывания в функции обратного вызова обработки событий. Мы расскажем о таймерных прерываниях в конце PA4. Пока после распознавания события таймерного прерывания ничего делать не нужно — просто верните соответствующую структуру контекста.
Опасные глобальные переменные (4)
Можно ли реализовать переключение контекста, не используя глобальные переменные?
Аналогично, нам нужно найти хранилище, которое не разделяется между несколькими потоками. Однако для потока, вызывающего rt_hw_context_switch(), его стек как раз используется, и запись данных в него может быть перезаписана, а то и вовсе может перезаписать уже существующие данные, обрушив текущий поток. Хотя стек to сейчас не используется и не разделяется с другими потоками, нужно подумать, как дать ev_handler() доступ к стеку to, а это снова возвращает нас к проблеме, которую мы хотели решить с самого начала.
Помимо стека, есть ли ещё какое-нибудь хранилище, которое не разделяется между несколькими потоками? Хе-хе, на самом деле оно тоже уже упоминалось ранее — это PCB! Поскольку каждому потоку соответствует свой PCB, а один поток не может быть запланирован одновременно несколько раз, передача информации через PCB тоже является рабочим решением. Чтобы получить PCB текущего потока, естественно, используется указатель current.
В RT-Thread можно получить PCB текущего потока, вызвав rt_thread_self(). Прочитав определение структуры PCB в RT-Thread, мы обнаруживаем в ней поле user_data, которое используется для хранения приватных данных потока. Это означает, что связанный с планированием код в RT-Thread точно не использует это поле, поэтому оно отлично подходит нам для передачи информации. Однако, чтобы избежать перезаписи уже существующих данных в user_data, мы можем сначала сохранить их во временной переменной, а затем восстановить перед следующим переключением обратно на текущий поток и возвратом из rt_hw_context_switch(). Что касается этой временной переменной — конечно же, используется локальная переменная, ведь локальные переменные выделяются на стеке, идеально!
Впрочем, функциональность, предоставляемая AM на данный момент, не так богата, как у других BSP. Некоторым более сложным функциям в RT-Thread требуется поддержка со стороны нижележащего железа — например, сеть, хранилище и т.д. Поэтому на данный момент мы можем запускать на AM лишь подмножество RT-Thread, но для наших целей тестирования и демонстрации этого вполне достаточно.
Nanos-lite
RT-Thread, безусловно, полноценная ОС, однако код её ядра составляет около 16 000 строк. Для сравнения, объём кода Nanos-lite — меньше 1000 строк, что больше подходит для изучения ключевых принципов. Поэтому дальнейшие эксперименты будут по-прежнему основаны на Nanos-lite.
Функции и структуры данных, нужные для переключения контекста в Nanos-lite, очень похожи на аналогичные в yield-os, только из-за большего размера кода Nanos-lite они разбросаны по разным файлам, и вам нужно найти их через RTFSC. Кроме того, в каркасном коде Nanos-lite уже определена структура PCB, в которой также есть другие поля, пока не используемые, — мы расскажем о них в будущем.
Реализуйте переключение контекста в Nanos-lite
Реализуйте следующую функциональность:
- Функцию
context_kload()в Nanos-lite (прототип этой функции не приведён в каркасном коде) — она дополнительно инкапсулирует процесс создания контекста ядра: вызываетkcontext()для создания контекста и записывает возвращённый указатель в полеcpPCB - Функцию
schedule()в Nanos-lite - После получения Nanos-lite события
EVENT_YIELD— вызовschedule()и возврат нового контекста
Nanos-lite предоставляет тестовую функцию hello_fun() (определена в nanos-lite/src/proc.c). Вам нужно создать в init_proc() два контекста с точкой входа hello_fun:
void init_proc() {
  context_kload(&pcb[0], hello_fun, ???);
  context_kload(&pcb[1], hello_fun, ???);
  switch_boot_pcb();
}
Вызов switch_boot_pcb() здесь нужен для инициализации указателя current. Вы можете сами договориться, каким типом интерпретировать параметр arg (целое число, символ, строка, указатель — что угодно подойдёт), затем измените код вывода в hello_fun(), чтобы он интерпретировал arg согласно вашей договорённости. Если ваша реализация верна, вы увидите, что hello_fun() будет поочерёдно выводить информацию с разными параметрами.
Переключение контекста на native
Поскольку native-версия AM по умолчанию включает прерывания при создании контекста, чтобы успешно запустить поток ядра, созданный на native, вам также нужно распознавать событие таймерного прерывания в функции обратного вызова обработки событий. Мы расскажем о таймерных прерываниях в конце PA4. Пока после распознавания события таймерного прерывания ничего делать не нужно — просто верните соответствующую структуру контекста.
Пользовательский процесс
Создание контекста пользовательского процесса
Создание контекста пользовательского процесса требует некоторых дополнительных соображений. В системе пакетной обработки из PA3 мы в naive_uload() напрямую передавали управление коду пользовательского процесса через вызов функции. Тогда всё ещё использовался стек в области ядра, и в случае переполнения стека действительно были бы повреждены данные операционной системы, но в тот момент выполнялся только один пользовательский процесс, так что мы это упустили. Однако в операционной системе с мультипрограммированием в системе выполняется уже не один процесс. Если позволить пользовательскому процессу и дальше использовать стек в области ядра, то при переполнении стека это затронуло бы работу других процессов, а этого нам бы не хотелось.
Что делать, если у потока ядра переполнился стек?
Если это удаётся обнаружить, лучший способ — вызвать kernel panic, потому что в этот момент данным ядра уже нельзя доверять. Если повреждённые данные будут записаны обратно на диск, это приведёт к невосстановимому катастрофическому повреждению.
Хорошая новость в том, что корректность потоков ядра может гарантироваться разработчиками ядра, а это как минимум гораздо проще, чем гарантировать корректность пользовательских процессов неизвестного происхождения. А плохая новость в том, что большинство багов ядра вызваны сторонними драйверами: переполнение стека встречается редко, гораздо чаще это use-after-free, double-free, а также трудноуловимые баги, связанные с параллелизмом. А в условиях огромного количества сторонних драйверов разработчикам ядра сложно поручиться за корректность каждого из них по отдельности. Если вы придумаете способ повысить качество кода драйверов — это уже будет вклад в область компьютерных систем.
Поэтому, в отличие от потока ядра, код, данные и стек пользовательского процесса должны находиться в пользовательской области, и нужно гарантировать, что пользовательский процесс может — и должен мочь — обращаться только к своему собственному коду, данным и стеку. Чтобы различать их, мы называем стек в PCB стеком ядра, а стек в пользовательской области — пользовательским стеком. Значит, нам нужен способ создания контекста пользовательского процесса, отличный от kcontext(). Для этого AM подготовила дополнительный API ucontext() (определён в abstract-machine/am/src/nemu/isa/$ISA/vme.c), его прототип:
Context* ucontext(AddrSpace *as, Area kstack, void *entry);
Здесь параметр as используется для ограничения памяти, которую может использовать пользовательский процесс — мы начнём использовать его только на следующем этапе, пока его можно игнорировать; kstack — это стек ядра, используемый для размещения структуры контекста, а entry — точка входа пользовательского процесса. Поскольку сейчас мы игнорируем параметр as, реализация ucontext() почти такая же, как у kcontext(), и даже проще, чем kcontext(): не нужно даже передавать параметр. Однако вам всё же нужно подумать: какое состояние нужно пользовательскому процессу, чтобы начать выполнение?
Хм, а как же обещанный пользовательский стек? На самом деле выделение пользовательского стека не зависит от ISA, поэтому связанную с пользовательским стеком часть мы поручим Nanos-lite, ucontext() заниматься этим не нужно. Пока что мы позволим Nanos-lite использовать heap.end как вершину стека пользовательского процесса, а затем присвоить эту вершину стека регистру указателя стека пользовательского процесса.
Ай, но ведь регистр указателя стека зависит от ISA, и в Nanos-lite обрабатывать его неудобно. Не переживайте, помните тот _start пользовательского процесса? Там как раз можно выполнить некоторые операции, зависящие от ISA. Поэтому Nanos-lite и Navy договорились: Nanos-lite устанавливает позицию вершины стека в GPRx, а уже _start внутри Navy реально устанавливает позицию вершины стека в регистр указателя стека.
Nanos-lite может инкапсулировать описанную выше работу в функцию context_uload(), и тогда мы сможем загружать пользовательские процессы. Заменим один из потоков ядра hello_fun() на Chinese Paladin:
context_uload(&pcb[1], "/bin/pal");
Затем нам также нужно вызвать yield() в начале serial_write(), events_read() и fb_write(), чтобы смоделировать ситуацию медленного доступа к устройству. После добавления этого при обращении к устройству будет происходить переключение контекста, тем самым реализуя функциональность системы мультипрограммирования.
Реализуйте систему мультипрограммирования
Основываясь на изложенном выше содержании методички, реализуйте следующую функциональность, чтобы получить систему мультипрограммирования:
- Функцию
ucontext()в VME - Функцию
context_uload()в Nanos-lite (прототип этой функции не приведён в каркасном коде) - Установку правильного указателя стека в
_startNavy
Если ваша реализация верна, вы сможете одновременно запускать Chinese Paladin и выводить сообщения hello. Обратите внимание: чтобы AM native работал корректно, вам также нужно установить правильный указатель стека в _start Navy.
Подумайте: как проверить, что Chinese Paladin действительно использует пользовательский стек, а не стек ядра?
Два тигра на одной горе не уживутся?
Попробуйте заменить hello_fun() на hello из Navy:
-context_kload(&pcb[0], (void *)hello_fun, NULL);
+context_uload(&pcb[0], "/bin/hello");
 context_uload(&pcb[1], "/bin/pal");
Какую проблему вы обнаружили? Почему так происходит? Подумайте — ответ раскроется на следующем этапе!
Параметры пользовательского процесса
Когда мы реализовывали поток ядра, мы передавали ему параметр arg. На самом деле у пользовательского процесса тоже могут быть собственные параметры — это argc и argv, которые вы изучали на курсе программирования, а ещё есть, возможно, не очень знакомый вам envp. envp — это указатель на переменные окружения, он указывает на массив строк, формат строк — xxx=yyy, что означает наличие переменной с именем xxx, значение которой равно yyy. Когда мы инициализируем проект PA через init.sh в PA0, скрипт определяет несколько переменных окружения в файле .bashrc, например AM_HOME. Когда мы компилируем FCEUX, программа make разбирает содержимое fceux-am/Makefile, и когда встречает
include $(AM_HOME)/Makefile
— она пытается через библиотечную функцию getenv() найти в массиве строк, на который указывает envp, строку вида AM_HOME=yyy. Если такая находится, возвращается yyy. Если AM_HOME указывает на правильный путь, программа make может найти файл Makefile в проекте abstract-machine и включить его.
На самом деле полный прототип функции main() должен быть таким:
int main(int argc, char *argv[], char *envp[]);
Так вот, когда мы набираем в терминале
make ARCH=x86-nemu run
— как параметры ARCH=x86-nemu и run, а также переменные окружения передаются в функцию main() программы make?
Поскольку пользовательский процесс создаётся операционной системой, естественно, что передача параметров и переменных окружения тоже должна быть заботой операционной системы. Наиболее подходящее место для хранения параметров и переменных окружения — пользовательский стек, ведь при первом переключении на пользовательский процесс содержимое пользовательского стека уже доступно пользовательскому процессу. Поэтому при загрузке пользовательского процесса операционная система также должна разместить argc/argv/envp и соответствующие строки на пользовательском стеке, и способ и место их хранения становятся частью договорённости с пользовательским процессом, чтобы пользовательский процесс мог получить к ним доступ в _start согласно этой договорённости.
Эта договорённость на самом деле относится к содержимому ABI. В руководстве ABI есть раздел Process Initialization, в котором подробно оговаривается, какую информацию операционная система должна предоставить для инициализации пользовательского процесса. Однако в нашей системе Project-N нам достаточно упрощённой версии Process Initialization: операционная система размещает argc/argv/envp и связанное с ними содержимое на пользовательском стеке, а затем устанавливает GPRx равным адресу, где находится argc.
|               |
+---------------+ <---- ustack.end
|  Unspecified  |
+---------------+
|               | <----------+
|    string     | <--------+ |
|     area      | <------+ | |
|               | <----+ | | |
|               | <--+ | | | |
+---------------+    | | | | |
|  Unspecified  |    | | | | |
+---------------+    | | | | |
|     NULL      |    | | | | |
+---------------+    | | | | |
|    ......     |    | | | | |
+---------------+    | | | | |
|    envp[1]    | ---+ | | | |
+---------------+      | | | |
|    envp[0]    | -----+ | | |
+---------------+        | | |
|     NULL      |        | | |
+---------------+        | | |
| argv[argc-1]  | -------+ | |
+---------------+          | |
|    ......     |          | |
+---------------+          | |
|    argv[1]    | ---------+ |
+---------------+            |
|    argv[0]    | -----------+
+---------------+
|      argc     |
+---------------+ <---- cp->GPRx
|               |
На приведённой выше схеме эти параметры разделены на две части: одна — область строк (string area), другая — два массива строковых указателей argv/envp, каждый элемент массива — это строковый указатель, и все эти строковые указатели указывают на определённую строку в области строк. Кроме того, Unspecified на схеме выше обозначает промежуток произвольной длины (может быть и 0), порядок строк в области строк тоже не регламентируется — достаточно, чтобы пользовательский процесс мог получить доступ к правильной строке через argv/envp. Формат размещения этих параметров очень похож на описание в руководстве ABI, вы также можете обратиться к одной из схем в 7-й главе учебника ICS.
Читайте руководство ABI, понимайте компьютерную систему
На самом деле руководство ABI — это мост между ISA, ОС, компилятором, средой выполнения, языком C и пользовательским процессом, его определённо стоит почитать всем. Многие непонятные вам договорённости из учебника ICS также взяты из руководства ABI. ABI, которого придерживается Linux, — это System V ABI, который делится на две части: одна — не зависящий от процессора generic ABI (gABI), например формат ELF, динамическое связывание, структура файловой системы и т.д.; другая — зависящий от процессора processor specific ABI (psABI), например соглашения о вызовах, интерфейс операционной системы, загрузка программ и т.д. Вам стоит как минимум просмотреть оглавление руководства ABI, полистать схемы в основном тексте — тогда у вас появится общее представление о руководстве ABI. А если вы захотите глубоко разобраться, «почему договорились именно так», это и будет настоящее «глубокое понимание компьютерных систем».
Согласно этой договорённости, вам также нужно изменить код _start в Navy, чтобы передать адрес argc в качестве параметра в call_main(). Затем измените код call_main(), чтобы он разбирал настоящие argc/argv/envp и вызывал main():
void call_main(uintptr_t *args) {
  argc = ???
  argv = ???
  envp = ???
  environ = envp;
  exit(main(argc, argv, envp));
  assert(0);
}
После этого пользовательский процесс сможет получать принадлежащие ему параметры.
Передайте параметры пользовательскому процессу
По сути, эта задача — упражнение на работу с указателями, но вам нужно следить за переносимостью кода, поскольку call_main() используется совместно разными ISA. Затем измените небольшую часть кода Chinese Paladin: если она получает параметр --skip, пропускайте воспроизведение заставочной анимации с товарным знаком, иначе не пропускайте. Реализация этой функции поможет ускорить тестирование Chinese Paladin. Воспроизведение анимации с товарным знаком по логике кода находится не так уж далеко от функции main(), так что предоставляем вам самим разобраться через RTFSC.
Однако, чтобы передать параметры пользовательскому процессу, вам также нужно изменить прототип context_uload():
void context_uload(PCB *pcb, const char *filename, char *const argv[], char *const envp[]);
Так вы сможете напрямую задавать параметры пользовательского процесса в init_proc() для тестирования: Задайте параметр --skip при создании пользовательского процесса Chinese Paladin — вы должны увидеть, что Chinese Paladin действительно пропускает анимацию с товарным знаком. Пока в наших тестовых программах переменные окружения не используются, так что передавать настоящие строки переменных окружения не обязательно. Что касается того, какие именно фактические аргументы писать — это опять же вопрос, связанный с указателями, оставляем его вам для решения.
Заставлять операционную систему вручную задавать параметры для каждого пользовательского процесса нереалистично, ведь параметры пользовательского процесса всё же должны указываться самим пользователем. Поэтому лучше всего иметь способ сообщить операционной системе параметры, указанные пользователем, чтобы операционная система разместила указанные параметры на пользовательском стеке нового процесса. Этот способ, конечно же, — системный вызов SYS_execve. Если посмотреть man, вы обнаружите, что его прототип такой:
int execve(const char *filename, char *const argv[], char *const envp[]);
Почему пропал один const?
В функции main() типы argv и envp — char * [], а в функции execve() их тип — char *const []. Судя по этому различию, строки, на которые указывают argv и envp в функции main(), доступны для записи — знаете ли вы, почему так происходит?
Чтобы реализовать SYS_execve с параметрами, мы можем напрямую вызвать context_uload() в sys_execve(). Но нам также нужно учесть несколько деталей ниже; для удобства описания предположим, что пользовательский процесс A собирается через SYS_execve выполнить новую программу B.
- Как создать пользовательский процесс B в потоке исполнения A?
- Как завершить поток исполнения A?
Чтобы ответить на первый вопрос, нам нужно вспомнить, какие операции требуются для создания пользовательского процесса B. Сначала — создание структуры контекста B в стеке ядра PCB, этот процесс безопасен, поскольку стек ядра текущего процесса пуст. Далее — размещение параметров пользовательского процесса B на пользовательском стеке. Но это влечёт за собой новый вопрос: можем ли мы по-прежнему переиспользовать тот же пользовательский стек, расположенный рядом с heap.end?
Чтобы разобраться в этом вопросе, нам нужно понять, что уже содержится в пользовательском стеке A на момент, когда Nanos-lite пытается загрузить B через SYS_execve. Мы можем перечислить содержимое пользовательского стека от дна стека (heap.end) до вершины стека (текущей позиции указателя стека sp):
- Параметры пользовательского процесса (
argc/argv/envp), ранее переданные Nanos-lite для A - Стековый кадр вызовов функций A, начиная с
_start— этот кадр будет расти до тех пор, пока не будет вызванexecve()в libos - Структура контекста, сохранённая CTE, — она возникает из-за того, что A выполнил инструкцию самозахвата системного вызова внутри
execve() - Стековый кадр вызовов функций Nanos-lite, начиная с
__am_irq_handle(), этот кадр будет расти до тех пор, пока не будет вызвана функция-обработчик системного вызоваSYS_execve
Проведя такой анализ, мы приходим к важному выводу: при загрузке B Nanos-lite использует пользовательский стек A! Это означает, что пока поток исполнения A не завершился, пользовательский стек A нельзя разрушать. Поэтому пользовательский стек около heap.end не может быть переиспользован B — нам следует запросить новый участок памяти под пользовательский стек B, чтобы Nanos-lite мог разместить параметры B в этом заново выделенном пользовательском стеке.
Чтобы этого добиться, мы можем заставить context_uload() единообразно получать память под пользовательский стек через вызов функции new_page(). Функция new_page() определена в nanos-lite/src/mm.c, она управляет областью кучи через указатель pf, используется для выделения непрерывной области памяти размером nr_page * 4KB и возвращает начальный адрес этой области. Мы заставим context_uload() выделять 32 КБ памяти через new_page() под пользовательский стек, чего вполне достаточно для пользовательских программ в PA. Кроме того, для упрощения нам не нужно реализовывать free_page() в PA.
Управление памятью в операционной системе
Мы знаем, что функция malloc() в klib тоже может управлять областью кучи, позволяя приложениям на AM удобно запрашивать динамическую память. Однако операционная система, как особое приложение AM, часто предъявляет более строгие требования к запросу динамической памяти — например, запрос области памяти, начальный адрес которой кратен 4 КБ, — malloc() обычно не может удовлетворить такое требование. Поэтому операционная система обычно управляет областью кучи самостоятельно, не вызывая malloc() из klib. Управление областью кучи в операционной системе — это работа модуля MM (Memory Manager), мы расскажем о нём подробнее в дальнейшем.
Наконец, чтобы завершить поток исполнения A, мы можем после создания контекста B изменить текущий указатель current через switch_boot_pcb(), а затем вызвать yield(), чтобы принудительно запустить планирование процессов. После этого поток исполнения A больше не будет планироваться, и при следующем планировании можно будет восстановить и выполнить B.
Реализуйте execve() с параметрами
Основываясь на изложенном выше содержании методички, реализуйте execve() с параметрами. Некоторые детали мы привели не полностью, например, что именно нужно передавать в параметр pcb при вызове context_uload() — этот вопрос оставляем вам на размышление!
После реализации запустите следующие программы:
- Тестовую программу
navy-apps/tests/exec-test, которая непрерывно запускает саму себя с возрастающим параметром. Однако, поскольку мы не реализовали освобождение памяти области кучи, после того какexec-testпоработает некоторое время,new_page()начнёт выделять память рядом с0x3000000/0x83000000, что приведёт к перезаписи сегмента кода пользовательского процесса. На данный момент мы не можем это исправить — вам достаточно увидеть, чтоexec-testможет корректно работать некоторое время. - Загрузочное меню MENU.
- Доработайте встроенный Shell NTerm так, чтобы он мог разбирать введённые параметры и передавать их запускаемой программе. Например, можно ввести в NTerm
pal --skip, чтобы запустить Chinese Paladin и пропустить анимацию с товарным знаком.
Запуск Busybox
Мы уже успешно запустили NTerm, но пока для него нет почти никаких Shell-инструментов, которые можно запускать. Busybox как раз и предназначен для решения этой проблемы — это набор урезанных Shell-инструментов, содержащий часто используемую функциональность большинства распространённых команд. О, ваш повседневный опыт использования командной строки в Linux скоро сможет проявиться и в построенной вами компьютерной системе!
Каркасный код Navy уже подготовил скрипт сборки Busybox: при первой сборке Busybox скрипт автоматически склонирует проект и использует конфигурационный файл, предоставленный каркасным кодом. Busybox содержит множество небольших утилит, которые можно посмотреть, выполнив
make menuconfig
чтобы открыть меню конфигурации (но не сохраняйте изменения конфигурации). Конфигурационный файл, предоставленный каркасным кодом, по умолчанию выбирает лишь очень немногие инструменты — это потому, что большинству инструментов для работы требуется поддержка большего числа системных вызовов, поэтому мы не можем запускать их на Nanos-lite.
Busybox линкует входящие в него Shell-инструменты в единый ELF-исполняемый файл, в отличие от Shell-инструментов в дистрибутивах вроде Ubuntu/Debian, где каждый инструмент — отдельный ELF-исполняемый файл. Функция main() в Busybox вызывает функциональность соответствующего инструмента в зависимости от переданных параметров:
if (strcmp(argv[1], "cat") == 0) return cat_main(argc, argv);
else if (strcmp(argv[1], "ls") == 0) return ls_main(argc, argv);
else if (strcmp(argv[1], "wc") == 0) return wc_main(argc, argv);
// ......
Busybox предоставляет простой скрипт установки, который создаёт серию символических ссылок, чтобы пользователь мог удобно пользоваться этими небольшими утилитами:
$ ls -lh navy-apps/fsimg/bin
total 1.6M
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 base64 -> busybox
-rwxr-xr-x 1 yzh yzh 161K Oct 21 12:11 bird
-rwxr-xr-x 1 yzh yzh 126K Dec  9 12:12 busybox
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 cat -> busybox
-rwxr-xr-x 1 yzh yzh  33K Oct 20 20:43 cpp-test
-rwxr-xr-x 1 yzh yzh  29K Dec  9 12:12 dummy
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 echo -> busybox
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 ed -> busybox
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 false -> busybox
-rwxr-xr-x 1 yzh yzh  33K Dec  9 12:12 hello
-rwxr-xr-x 1 yzh yzh  81K Dec  9 12:12 menu
-rwxr-xr-x 1 yzh yzh  91K Dec  9 12:12 nterm
-rwxr-xr-x 1 yzh yzh 586K Dec  9 12:12 onscripter
-rwxr-xr-x 1 yzh yzh 390K Dec  9 12:12 pal
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 printenv -> busybox
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 sleep -> busybox
lrwxrwxrwx 1 yzh yzh    7 Dec  9 12:12 true -> busybox
После этого, вводя команду cat, мы на самом деле выполняем /bin/busybox, заставляя его выполнить функцию cat_main(), слинкованную в Busybox.
Запустите Busybox
Попробуйте запустить через NTerm несколько простых команд из Busybox, например cat и printenv. Если вы не знаете, как пользоваться этими командами, можете свериться с ними через man. Следите за тем, чтобы вывод этих команд не тонул в информации, выводимой hello_fun(), для этого вам, возможно, придётся скорректировать частоту вывода информации в hello_fun().
Некоторые инструменты хранятся не в каталоге /bin, а в каталоге /usr/bin, например wc. Чтобы не вводить полный путь, мы также можем добавить /usr/bin в переменную окружения PATH. Разные пути разделяются символом :, точный формат можно посмотреть по результату выполнения команды echo $PATH в Linux. После этого мы сможем через библиотечную функцию execvp() пытаться перебирать все пути в PATH, пока не будет найден существующий исполняемый файл, и после его нахождения будет вызван SYS_execve. Вы можете прочитать navy-apps/libs/libc/src/posix/execvp.c, чтобы понять, как реализована эта функциональность.
Однако, перебирая пути в PATH, execvp() может попытаться выполнить несуществующую пользовательскую программу, например /bin/wc. Поэтому Nanos-lite при обработке системного вызова SYS_execve должна проверять, существует ли программа, которую предстоит выполнить. Если она не существует, нужно вернуть код ошибки. Мы можем выполнить эту проверку через fs_open(): если открываемого файла не существует, возвращается ошибочное значение, и в этом случае SYS_execve возвращает -2. С другой стороны, execve() в libos также должна проверять возвращаемое значение системного вызова: если возвращаемое значение системного вызова меньше 0, это обычно означает, что системный вызов завершился неудачей, и в этом случае нужно взять возвращаемое значение системного вызова со знаком минус, установить его как причину ошибки в глобальную внешнюю переменную errno, а затем вернуть -1.
-2 и errno
errno — это глобальная переменная в среде выполнения, определённая стандартом C, используемая для хранения кода ошибки последнего неудавшегося системного вызова или вызова библиотечной функции. Вы можете посмотреть все коды ошибок и их значения, выполнив команду errno -l (для этого нужно установить пакет moreutils через apt-get). Вы должны увидеть, что код ошибки 2 — это довольно знакомая вам ошибка. Подробнее о глобальной переменной errno можно узнать через man 3 errno.
Запустите Busybox (2)
Реализуйте описанное выше, чтобы execvp() поддерживала перебор PATH. Затем попробуйте запустить через NTerm команды вроде wc, находящиеся в каталоге /usr/bin, например wc /share/games/bird/atlas.txt. Вы можете проверить правильность результата, выполнив соответствующую команду в Linux. Кроме того, вы можете прочитать код execvp(), чтобы понять, правильно ли установлено возвращаемое значение.
Хотя пока мы можем запускать на Nanos-lite лишь очень небольшую часть инструментов Busybox, вы, по сути, воспроизвели в построенной вами компьютерной системе картину, очень похожую на ваше повседневное использование инструментов командной строки в Linux. Мы включили это в системный стек Project-N именно для того, чтобы вы поняли, что делают различные слои абстракции компьютерной системы, когда вы обычно вводите команды:
- Как терминал считывает нажатия клавиш пользователя?
- Как Shell выполняет разбор команды?
- Как библиотечная функция ищет исполняемый файл по строке, разобранной из команды?
- Как операционная система загружает и выполняет исполняемый файл?
- ......
Хотя между Project-N и реальной системой Linux всё ещё есть большие различия, самостоятельное выполнение PA уже во многом помогает вам развеять ореол таинственности вокруг вопроса «как программа работает на компьютере».
Дружеское напоминание
На этом этап 1 PA4 завершается.