
За пределами ограничений ёмкости
У того, что современные операционные системы не используют сегментацию, есть свои резоны. Исследование показывает, что 1000 серверов в дата-центрах Google за 7 минут выполнили тысячи разных программ, среди которых есть настоящие гиганты (при внутренней разработке программ в Google, чтобы избежать проблем несовместимости динамических библиотек на разных машинах, все используемые библиотеки становятся частью программы через статическое связывание — один только сегмент кода программы может занимать сотни мегабайт, а то и гигабайты; желающие могут прочитать эту статью), а есть и совсем небольшие тестовые программы.
Заставлять все эти программы с настолько разными характеристиками занимать непрерывное пространство памяти — не такая уж хорошая идея: с одной стороны, те самые гиганты за один запуск затрагивают лишь очень небольшую часть своего кода, и на самом деле нет никакой необходимости выделять столько памяти, чтобы загрузить их целиком; с другой стороны, после завершения работы маленькой программы освобождённое ею пространство памяти легко превращается в «дыру-фрагмент» — использовать её сможет только программа ещё меньшего размера. Простота и незамысловатость механизма сегментации в реальности может оборачиваться огромной ценой.
На самом деле нам нужен механизм управления виртуальной памятью с выделением по требованию. Причина, по которой механизму сегментации трудно реализовать выделение по требованию, — в том, что гранулярность сегмента слишком велика. Чтобы достичь этой цели, нужно действовать наоборот: разбить непрерывное пространство памяти на небольшие фрагменты и организовывать, выделять и управлять ими именно такими небольшими единицами. Это и есть базовая идея механизма страничной организации (paging).
Страничная организация памяти
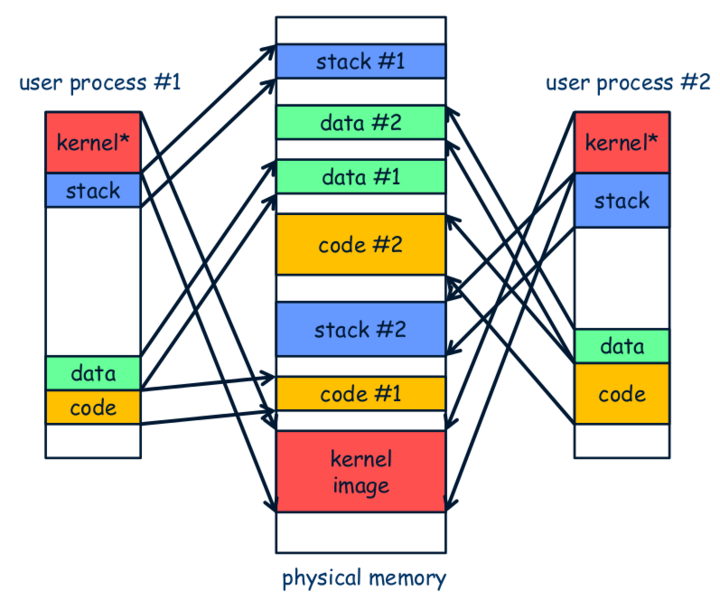
В механизме страничной организации эти небольшие фрагменты называются страницами, а в виртуальном и физическом адресном пространстве их называют соответственно виртуальными и физическими страницами. Механизм страничной организации занимается тем, что отображает каждую виртуальную страницу на соответствующую физическую. Очевидно, что эта связь отображения не так проста, как в механизме сегментации, который описывается всего одним регистром базового адреса сегмента. Механизм страничной организации вводит структуру под названием «таблица страниц»: каждая запись в таблице страниц фиксирует связь отображения одной виртуальной страницы на физическую, позволяя переорганизовать необязательно непрерывные физические страницы в непрерывное виртуальное адресное пространство.
Поэтому, чтобы механизм страничной организации мог поддерживать работу многозадачной операционной системы, ОС в первую очередь должна управлять памятью в единицах физических страниц. При загрузке каждой программы ей выделяются соответствующие физические страницы (обратите внимание, что эти физические страницы не обязаны быть непрерывными), и для программы готовится новая таблица страниц, в которую записывается отображение используемых программой виртуальных страниц на эти физические страницы. Когда программа начинает выполняться, операционная система устанавливает заранее заполненную для неё таблицу страниц в MMU, и MMU уже выполняет трансляцию адресов на основе содержимого таблицы страниц, отображая виртуальное адресное пространство программы на желаемое операционной системой физическое адресное пространство.
Преимущества PIC в управлении виртуальной памятью
Мы упоминали ранее, что одно из преимуществ PIC — возможность загружать код для выполнения в любом месте памяти. Если сочетать это с управлением виртуальной памятью, какие новые преимущества появятся у PIC? (Подсказка: динамические библиотеки уже пользуются этими преимуществами)
i386 — первый процессор в истории x86, введший механизм страничной организации: он делит физическую память на страницы по 4 КБ, а также использует структуру двухуровневой таблицы страниц. Для удобства описания i386 дал первому уровню таблицы страниц новое название — «каталог страниц» (page directory). Звучит впечатляюще, но по сути принцип тот же самый. У каждого каталога страниц и каждой таблицы страниц по 1024 записи, размер каждой записи — 4 байта; помимо базового адреса таблицы страниц (или физической страницы), запись также содержит некоторую информацию в виде флаговых битов.
Поэтому размер одного каталога страниц или таблицы страниц составляет 4 КБ — разместить их в регистре невозможно, значит, они должны находиться в памяти. Чтобы найти каталог страниц, i386 предоставляет регистр CR3 (control register 3), специально предназначенный для хранения базового адреса каталога страниц. Таким образом, постраничная трансляция адреса выполняется пошагово начиная с CR3 и в итоге преобразует виртуальный адрес в настоящий физический; этот процесс называется page table walk (обход таблицы страниц).
                                                              PAGE FRAME
              +-----------+-----------+----------+         +---------------+
              |    DIR    |   PAGE    |  OFFSET  |         |               |
              +-----+-----+-----+-----+-----+----+         |               |
                    |           |           |              |               |
      +-------------+           |           +------------->|    PHYSICAL   |
      |                         |                          |    ADDRESS    |
      |   PAGE DIRECTORY        |      PAGE TABLE          |               |
      |  +---------------+      |   +---------------+      |               |
      |  |               |      |   |               |      +---------------+
      |  |               |      |   |---------------|              ^
      |  |               |      +-->| PG TBL ENTRY  |--------------+
      |  |---------------|          |---------------|
      +->|   DIR ENTRY   |--+       |               |
         |---------------|  |       |               |
         |               |  |       |               |
         +---------------+  |       +---------------+
                 ^          |               ^
+-------+        |          +---------------+
|  CR3  |--------+
+-------+
Мы не собираемся давать подробного объяснения процесса постраничной трансляции — попробуйте, опираясь на содержание руководства по i386 и знания, полученные на занятиях, разобраться в механизме страничной организации i386 самостоятельно, это тоже своего рода упражнение по страничной организации. Руководство по i386 содержит всю информацию, которая может вам понадобиться, включая не упомянутую здесь структуру записей таблицы, способ деления адреса и так далее.
Разберитесь в деталях страничной организации
- Разве i386 не 32-битный процессор? Почему информация о базовом адресе в записи составляет всего 20 бит, а не 32?
- В руководстве упоминается, что базовые адреса в записях (включая CR3) — это физические адреса. Обязательно ли использовать физический адрес? Можно ли использовать виртуальный?
- Почему не используется одноуровневая таблица страниц? Или какие недостатки были бы у одноуровневой таблицы страниц?
Процесс постраничной трансляции не всегда завершается успешно, поскольку i386 также предоставляет механизм защиты на уровне страниц, и реализация функций защиты опирается как раз на флаговые биты в записях. Дадим краткое объяснение некоторым флаговым битам:
- Бит present показывает, доступна ли физическая страница; когда она недоступна, различают два случая:
- Физическая страница была вытеснена на диск с помощью технологии свопинга — это одна из самых знакомых вам по занятиям ситуаций Page fault (отказа страницы); в этом случае можно уведомить ядро операционной системы, чтобы оно вернуло целевую страницу обратно, после чего выполнение продолжится
- Процесс пытается обратиться к неотображённому линейному адресу, которому не соответствует никакая реальная физическая страница, — и это, соответственно, недопустимая операция
- Бит R/W показывает, доступна ли физическая страница для записи; если производится запись в страницу, доступную только для чтения, это будет расценено как недопустимая операция
- Бит U/S показывает уровень привилегий, необходимый для обращения к физической странице; если процесс с ring 3 попытается обратиться к странице ring 0, это, разумеется, тоже будет расценено как недопустимая операция
Разберитесь в механизме страничной организации
Выше был описан только механизм страничной организации i386; на самом деле механизмы страничной организации других ISA во многом схожи — разобравшись в механизме страничной организации i386, вы без труда разберётесь и в механизмах страничной организации mips32 и riscv32.
Разумеется, за конкретными деталями всё равно нужно обращаться к RTFM.
riscv64 требует реализации трёхуровневой таблицы страниц
Механизм Sv32 в riscv32 может транслировать только 32-битные виртуальные адреса, но у riscv64 виртуальный адрес может достигать 64 бит, поэтому нужен другой механизм для трансляции более длинных виртуальных адресов. В PA, если вы выбрали riscv64, вам достаточно реализовать механизм страничной организации Sv39 с трёхуровневой таблицей страниц, при этом в PA будут использоваться только маленькие страницы по 4 КБ, а не большие страницы по 2 МБ, так что реализовывать функциональность больших страниц Sv39 не нужно. За конкретными деталями обращайтесь к RTFM.
А правда ли нулевой указатель — «пустой»?
На курсе программирования преподаватель говорил вам, что когда значение переменной-указателя равно NULL, это означает «пусто», указатель никуда не указывает. Подумайте внимательно — действительно ли это так? Что именно происходит внутри компьютера, когда программа разыменовывает нулевой указатель? Появилось ли у вас новое понимание сущности нулевого указателя?
По сравнению с механизмом сегментации, механизм страничной организации более гибкий — можно даже использовать виртуальные адреса, превышающие верхнюю границу физического адреса. Сейчас мы разберёмся с этими двумя моментами с математической точки зрения. Оставив в стороне механизм защиты памяти, мы можем абстрагировать процессы сегментации и страничной организации в виде двух математических функций:
  y = seg(x) = seg.base + x
  y = page(x)
Как видно, функция seg() — это просто сложение. Если использовать только механизм сегментации, мы дополнительно требуем, чтобы результат сегментной трансляции адреса не превышал верхнюю границу физического адреса:
   y = seg(x) = seg.base + x < PMEM_MAX
=> x < PMEM_MAX - seg.base
=> x <= PMEM_MAX
Отсюда можно сделать вывод: используя только механизм сегментации, виртуальный адрес не может превышать верхнюю границу физического адреса. С механизмом страничной организации всё иначе — мы не можем дать для page() конкретную аналитическую формулу, потому что заполнение каталога страниц и таблицы страниц по сути и есть определение функции page() путём перечисления значений аргумента. Это и есть коренная причина, по которой механизм страничной организации гибче механизма сегментации.
Хотя ограничение «результат постраничной трансляции адреса не может превышать верхнюю границу физического адреса» по-прежнему действует, нам достаточно гарантировать, что каждое значение функции не превышает эту верхнюю границу; явных ограничений на значения аргумента при этом нет, и, разумеется, сам аргумент вполне может быть больше значения функции. Тем самым уже проявляются обе особенности страничной организации — «гибкость» и «возможность использовать значения, превышающие верхнюю границу физического адреса».
i386 использует сегментно-страничный механизм управления памятью. Впрочем, если подумать, это лишь сочетание сегментации и страничной организации — с точки зрения математических функций это просто сложная (композитная) функция:
paddr = page(seg(vaddr))
А такие бесконечно важные в операционных системах понятия, как «виртуальное адресное пространство» и «физическое адресное пространство», — это, по сути, всего лишь область определения и область значений этой сложной функции.
Наконец, распознаёт ли процессор, поддерживающий механизм страничной организации, что такое таблица страниц? Разберёмся в этом вопросе на примере трансляции адреса при одноуровневой таблице страниц с размером страницы 1 КБ:
pa = (pg_table[va >> 10] & ~0x3ff) | (va & 0x3ff);
Как видно, у процессора нет никакого понятия «таблица»: процесс трансляции адреса — это всего лишь несколько операций обращения к памяти и битовых операций. Это снова показывает нам суть компьютера: кучу изумительных, наполненных глубокой математической мудростью и инженерными принципами... логических вентилей! И всё же эти крошечные операции логических вентилей стали фундаментом сегодняшних многозадачных операционных систем, на которых держится работа бесчисленных программ, — и в конечном счёте всё это неотделимо от главной идеи абстракции компьютерных систем.
Механизм управления виртуальной памятью с точки зрения конечного автомата
С точки зрения конечного автомата, что же такое механизм управления виртуальной памятью?
Чтобы описать поведение механизма управления виртуальной памятью с точки зрения конечного автомата, нам нужно расширить поведение обращения к памяти конечного автомата S = <R, M>. А именно: нужно добавить функцию fvm: M -> M, которая как раз и есть обсуждавшееся выше отображение трансляции адреса, и затем заменить все обращения M[addr] к M в конечном автомате на M[fvm(addr)] — это и есть поведение механизма управления виртуальной памятью. Например, инструкция mov $1, addr при выключенном механизме виртуальной памяти ведёт себя так, как определено в TRM:
M[addr] <- 1
А при включённом механизме виртуальной памяти её поведение таково:
M[fvm(addr)] <- 1
Мы только что обсудили, что процесс трансляции адреса можно реализовать через операции обращения к памяти и битовые операции — это показывает, что поведение функции fvm() тоже можно описать с точки зрения конечного автомата.
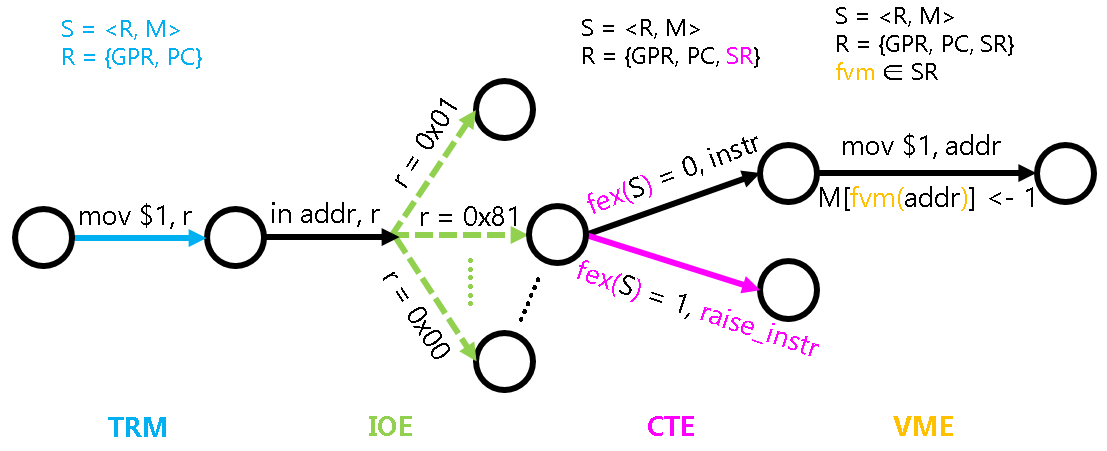
Особый случай — функция fvm(). Вспомним функцию fex(), введённую в модели конечного автомата из PA3: на самом деле она не является частью конечного автомата, поскольку способ определения того, выбрасывается ли исключение, не зависит от конкретного состояния конечного автомата. А вот функция fvm() отличается — её можно считать частью конечного автомата, поскольку функцию fvm() можно изменять программно: операционная система может решать, как выстроить отображение между виртуальными и физическими адресами. Если конкретнее, функцию fvm() можно считать частью системного регистра SR, и операционная система управляет виртуальной памятью, изменяя SR.
TLB — ускорение трансляции адреса
Внимательный читатель заметит: если не менять базовый адрес каталога страниц, сам каталог страниц и таблицу страниц, а несколько раз подряд обращаться к содержимому одной и той же виртуальной страницы, результат постраничной трансляции адреса будет одним и тем же. На самом деле такая ситуация встречается очень часто — например, при выполнении программы нужно выбирать инструкции, а выполнение инструкций обычно подчиняется принципу локальности, и в большинстве случаев выполняется в пределах одной и той же виртуальной страницы. Но выполнение page table walk требует обращения к памяти, и если найти способ избежать таких ненужных page table walk, можно повысить производительность процессора.
Естественная идея — сохранять результаты постраничной трансляции адреса, и перед выполнением следующей постраничной трансляции проверять, не была ли эта виртуальная страница уже транслирована; если да — просто взять готовый прежний результат, тем самым избежав ненужного page table walk. Разве это не в точности идея кэша? Такой особый кэш называется TLB. Организацию TLB можно понять, опираясь на знания о кэше CPU:
- Базовая единица TLB — запись (item), одна запись хранит результат одной постраничной трансляции адреса (на самом деле это просто запись таблицы страниц, включающая номер физической страницы и некоторые флаговые биты, связанные с ней); функционально она соответствует блоку кэша (cache block).
- Роль тега записи TLB играет номер виртуальной страницы, показывающий, какому номеру виртуальной страницы соответствует эта запись.
- Количество записей в TLB обычно невелико; чтобы повысить процент попаданий, TLB обычно организуют по полностью ассоциативной либо множественно-ассоциативной схеме.
- Поскольку после создания каталога страниц и таблицы страниц их записи обычно не меняются произвольно, для TLB не возникает вопроса стратегии записи и способа выделения при записи.
Практика показывает, что TLB на 64 записи может давать процент попаданий вплоть до 90%; с появлением TLB действительно удаётся сильно сэкономить на ненужных page table walk.
Звучит и правда неплохо! Однако в современных многозадачных операционных системах, если использовать TLB просто по описанной выше схеме без каких-либо доработок, это приведёт к фатальным последствиям. Мы знаем, что операционная система выделяет каждому процессу отдельные каталог страниц и таблицу страниц; хотя оба процесса могут начинать выполнение с адреса 0x8048000, механизм страничной организации отображает их на разные физические страницы, тем самым обеспечивая изоляцию пространства памяти. Разумеется, при переключении процессов операционная система также должна обновлять содержимое CR3, заставляя регистр CR3 указывать на каталог страниц нового процесса, — только так можно гарантировать, что механизм страничной организации отобразит виртуальный адрес на физическое пространство памяти нового процесса.
А теперь вот в чём проблема: предположим, есть два процесса, и для одного и того же виртуального адреса 0x8048000 операционная система уже настроила правильные каталог страниц и таблицу страниц, так что процесс №1 отображается на физический адрес 0x1234000, а процесс №2 — на физический адрес 0x5678000; при этом предположим, что изначально все записи TLB помечены как недействительные. В этот момент сначала выполняется процесс №1: он обращается к виртуальному адресу 0x8048000, проверяет TLB — промах, поэтому выполняется page table walk, на основе каталога страниц и таблицы страниц процесса №1 выполняется постраничная трансляция адреса, получается физический адрес 0x1234000, и TLB заполняется этой записью. Предположим, в этот момент происходит переключение процессов, и настаёт очередь выполняться процессу №2: ему тоже нужно обратиться к виртуальному адресу 0x8048000, он проверяет TLB — обнаруживается попадание, поэтому page table walk не выполняется, а напрямую используется номер физической страницы из TLB, получая физический адрес 0x1234000. Процесс №2, оказывается, обратился к пространству памяти процесса №1, но ни процесс №2, ни операционная система об этом даже не подозревают!
Причина этой фатальной ошибки — в том, что TLB не поддерживает согласованность между процессом и связью отображения виртуального адреса: TLB знает лишь, что существует связь отображения от виртуального адреса 0x8048000 к физическому адресу 0x1234000, но не знает, какому процессу принадлежит эта связь. Найдя причину проблемы, решить её несложно — достаточно добавить в запись TLB поле ASID (address space ID, идентификатор адресного пространства), указывающее, какому процессу принадлежит связь отображения; именно так поступает mips32. Подход x86 более «варварский» — при каждом обновлении CR3 принудительно сбрасывать (flush) содержимое TLB целиком. Поскольку переключение процессов обязательно сопровождается обновлением CR3, во время работы одного процесса в TLB не будет связей отображения других процессов. Разумеется, чтобы не сбрасывать слишком агрессивно, в записи таблицы страниц есть бит Global — связи отображения с битом Global равным 1 не сбрасываются; например, можно установить бит Global равным 1 для страницы, где находится do_syscall() в ядре, и тогда при обработке системных вызовов TLB miss происходить не будет.
TLB, управляемый программно
Для x86 и riscv32 TLB обычно управляется аппаратно: при TLB miss аппаратная логика автоматически выполняет page table walk и заполняет TLB результатом трансляции адреса, а программное обеспечение не знает и не должно знать детали этого процесса. Для PA это хорошая новость: раз это прозрачно для программного обеспечения, значит, можно упростить задачу. Поэтому если вы выбрали x86 или riscv32, реализовывать TLB в NEMU вам не нужно.
А вот mips32 отличается: чтобы снизить сложность аппаратного проектирования, mips32 определяет, что и page table walk, и заполнение TLB — забота программного обеспечения. Естественно, что в mips32 TLB miss оформлен как исключение: при TLB miss CPU выбрасывает исключение, а page table walk и заполнение TLB выполняет программное обеспечение.
Поэтому mips32 нужно предоставить состояние TLB программному обеспечению, чтобы оно могло управлять TLB. Чтобы этого добиться, mips32 требует добавить как минимум следующее:
- Регистр CP0, включающий четыре регистра: entryhi, entrylo0, entrylo1, index. Регистр entryhi хранит информацию, связанную с номером виртуальной страницы, а регистры entrylo0 и entrylo1 хранят информацию, связанную с номером физической страницы.
- Инструкции CP0
- tlbp — используется для поиска записи TLB, совпадающей с содержимым регистра entryhi; если найдена, регистр index устанавливается равным порядковому номеру этой записи TLB
- tlbwi — используется для записи содержимого трёх регистров entryhi, entrylo0 и entrylo1 в запись TLB, на которую указывает порядковый номер index
- tlbwr — используется для записи содержимого трёх регистров entryhi, entrylo0 и entrylo1 в случайную запись TLB
- заставить mtc0 и mfc0 поддерживать доступ к указанным выше четырём регистрам CP0
Проще ли управление TLB в mips32?
Есть мнение, что механизм страничной организации в mips32 проще. Согласны ли вы с этим? Попробуйте ответить на этот вопрос как сейчас, так и после завершения этого раздела.
Управление TLB — типичный пример компромисса (tradeoff) между программным и аппаратным подходом. mips32 поручает эту задачу программному обеспечению, что, безусловно, вносит дополнительные накладные расходы на производительность. В некоторых встраиваемых сценариях, где производительность не так критична, это не создаёт больших проблем; но в сценариях, ориентированных на высокую производительность, этот с виду простой механизм становится источником узкого места: например, в сценариях дата-центров программам нужно обращаться к очень большому объёму данных, локальность там довольно плохая, TLB miss — весьма частое явление, и в таких условиях накладные расходы на программное управление TLB ещё больше усиливаются.
В mips32, чтобы дополнительно снизить накладные расходы на производительность из-за page table walk, одна запись TLB на самом деле управляет связью отображения сразу двух соседних виртуальных страниц, поэтому регистров, связанных с номером физической страницы, тоже два — entrylo0 и entrylo1, каждый из которых показывает номер физической страницы, соответствующий одной из этих двух виртуальных страниц. Если конкретнее: если предположить, что и виртуальный, и физический адрес имеют длину 32 бита, а размер страницы — 4 КБ, то номер виртуальной страницы в регистре entryhi занимает 19 бит, а номера физических страниц в регистрах entrylo0 и entrylo1 — по 20 бит каждый. Преимущество такого подхода в том, что за один page table walk можно одновременно заполнить результаты трансляции адреса для двух виртуальных страниц, в надежде получить некоторую выгоду в производительности за счёт локальности программы. Впрочем, перед лицом сценариев дата-центров всё это — капля в море.
Абстрагируем управление виртуальной памятью в VME
Конкретная реализация управления виртуальной памятью, естественно, зависит от архитектуры: например, в x86 регистр CR3 используется для хранения базового адреса каталога страниц, а в riscv32 он называется иначе, и, соответственно, инструкции для доступа к этому регистру тоже разные. Кроме того, размер страницы в разных архитектурах может различаться, структура записи таблицы страниц тоже не одинакова, не говоря уже о том, что в некоторых архитектурах структура таблицы страниц может иметь больше двух уровней. Поэтому мы можем отнести функциональность управления виртуальной памятью к новой категории API в AM, называемой VME (Virtual Memory Extension).
По заведённой традиции подумаем, как абстрагировать функциональность управления виртуальной памятью в единый API. Другими словами, в чём же на самом деле заключается суть механизма виртуальной памяти? Мы уже обсуждали этот вопрос выше: механизм виртуальной памяти, попросту говоря, — это отображение (или функция). То есть по сути задача управления виртуальной памятью сводится к поддержанию этого отображения. Но такое отображение должно поддерживаться отдельно для каждого процесса, поэтому нам нужны следующие два API:
// Create a default address space
void protect(AddrSpace *as);

// Destroy a default address space
void unprotect(AddrSpace *as);
Здесь AddrSpace — структурный тип, определяющий структуру дескриптора адресного пространства (определён в abstract-machine/am/include/am.h):
typedef struct AddrSpace {
  int pgsize;
  Area area;
  void *ptr;
} AddrSpace;
Здесь pgsize указывает размер страницы, area обозначает диапазон пользовательского режима в виртуальном адресном пространстве, а ptr — это зависящий от ISA указатель дескриптора адресного пространства, используемый для указания конкретного отображения.
Раз есть адресное пространство, нам также нужны соответствующие API для его поддержания. Отсюда естественным образом появляется следующий API:
void map(AddrSpace *as, void *va, void *pa, int prot);
Он используется для того, чтобы отобразить виртуальную страницу, в которой находится виртуальный адрес va в адресном пространстве as, на физическую страницу, в которой находится pa, с правами prot. Когда бит present в prot равен 0, это означает, что отображение va становится недействительным. Поскольку мы не планируем реализовывать механизм защиты, права prot пока не используются.
Основная функциональность VME уже абстрагирована через три указанных выше API. И наконец, есть ещё два унифицированных API:
bool vme_init(void *(*pgalloc_f)(int), void (*pgfree_f)(void *))
Используется для выполнения инициализационных операций, связанных с VME. Кроме того, он принимает два указателя на функции обратного вызова для выделения страниц, предоставленные операционной системой, позволяя AM при необходимости через эти два обратных вызова запрашивать/освобождать физическую страницу.
Context* ucontext(AddrSpace *as, Area kstack, void *entry)
Используется для создания контекста пользовательского процесса. Мы уже рассматривали этот API ранее, но после добавления управления виртуальной памятью нам нужно внести некоторые изменения в его реализацию — конкретные изменения будут описаны ниже.
Далее мы расскажем, как Nanos-lite использует механизм, предоставляемый VME.
Запуск Nanos-lite поверх механизма страничной организации
Поскольку таблица страниц находится в памяти, а в момент запуска компьютера в памяти нет никаких действительных данных, мы не можем включить механизм страничной организации сразу при запуске компьютера. Чтобы включить механизм страничной организации, операционная система сначала должна подготовить некоторые таблицы страниц ядра. Каркасный код уже реализовал для нас эту функциональность (см. функцию vme_init() в abstract-machine/am/src/$ISA/nemu/vme.c). Достаточно определить макрос HAS_VME в nanos-lite/include/common.h, и при инициализации Nanos-lite сначала вызовет функцию init_mm() (определена в nanos-lite/src/mm.c) для инициализации MM. Здесь MM обозначает модуль менеджера памяти (Memory Manager), который специально отвечает за управление памятью, связанное со страничной организацией.
На данный момент инициализация MM состоит из двух задач. Первая — использовать начальный адрес области кучи, предоставленный TRM, как начальный адрес свободной физической страницы, чтобы в дальнейшем можно было выделять свободные физические страницы через функцию new_page(). Для упрощения реализации MM может выделять физические страницы последовательно, при этом после выделения освобождать их не требуется. Вторая задача — вызвать функцию vme_init() из AM. На примере riscv32: vme_init() установит функции обратного вызова для выделения и освобождения страниц, затем вызовет map(), чтобы заполнить каталог страниц и таблицу страниц виртуального адресного пространства ядра (kas), и наконец установит CSR-регистр под названием satp (Supervisor Address Translation and Protection), чтобы включить механизм страничной организации. После этого Nanos-lite будет работать поверх механизма страничной организации.
map() — ключевой API в VME, ему нужно заполнить правильным содержимым каталог страниц и таблицу страниц виртуального адресного пространства as, так чтобы при последующем обращении к виртуальной странице (параметр va) в режиме страничной организации физическая страница, полученная аппаратурой после page table walk, была именно той целевой физической страницей (параметр pa), которая была указана ранее при вызове map(). Это снова показывает, что страничная организация — это механизм, работающий только благодаря совместной работе программной и аппаратной части: если map() заполнит эти данные неправильно, аппаратура в дальнейшем не сможет получить правильную физическую страницу при выполнении page table walk.
Для x86 и riscv32 vme_init() через map() заполняет отображение для виртуального адресного пространства ядра. Эти отображения весьма особые — их va и pa совпадают, и мы называем их «тождественным отображением» (identical mapping). После включения механизма страничной организации в аппаратуре физический адрес, к которому обращается CPU, оказывается таким же, как при выключенном механизме страничной организации, что позволяет, не меняя остальной код, добиться эффекта «Nanos-lite как будто выполняется напрямую поверх физической памяти». Установление такого отображения также помогает Nanos-lite в управлении памятью: даже в режиме страничной организации Nanos-lite может напрямую использовать физические адреса памяти в качестве виртуальных адресов для обращения, и результат обращения будет как раз соответствующим физическим адресом.
Чтобы отображение, заполненное map(), вступило в силу, нам также нужно реализовать механизм страничной организации в NEMU. Конкретно нужно реализовать следующие два момента:
- Как определить, находится ли CPU в данный момент в режиме страничной организации?
- Как именно реализовать конкретный процесс постраничной трансляции адреса?
Но оба этих момента зависят от ISA, поэтому NEMU абстрагирует их в соответствующие API:
// Check whether memory access for the current system state within the range [vaddr, vaddr + len) and of type 'type' requires address translation.
int isa_mmu_check(vaddr_t vaddr, int len, int type);

// Perform address translation for memory access within the range [vaddr, vaddr + len) and of type 'type'.
paddr_t isa_mmu_translate(vaddr_t vaddr, int len, int type);
Чтобы использовать эти API, вам нужно внести некоторые изменения в функции доступа к виртуальным адресам в NEMU. Конкретно: сначала нужно через isa_mmu_check() определить на основе текущего состояния системы, как должен выполняться данный доступ к виртуальному адресу:
- Если
isa_mmu_check()возвращаетMMU_DIRECT, это означает, что этот адрес можно напрямую использовать в качестве физического; в этом случае достаточно просто вызватьpaddr_read()илиpaddr_write() - Если
isa_mmu_check()возвращаетMMU_TRANSLATE, это означает, что для данного доступа требуется трансляция адреса через MMU; в этом случае сначала нужно вызватьisa_mmu_translate()для трансляции адреса, а затем уже вызватьpaddr_read()илиpaddr_write(), используя транслированный физический адрес - Согласно определению API,
isa_mmu_check()также может вернутьMMU_FAIL, что означает неудачу доступа и необходимость выбросить исключение, однако такая ситуация в PA не встретится
Если вы выбрали x86, вам нужно добавить регистры CR3 и CR0, а также соответствующие инструкции для работы с ними. Для регистра CR0 нам достаточно реализовать только бит PG. Если обнаруживается, что бит PG регистра CR0 равен 1, это означает, что CPU находится в режиме страничной организации, и с этого момента все обращения к виртуальным адресам должны проходить через постраничную трансляцию адреса.
Механизм страничной организации Sv32 в riscv32 очень похож на x86, за исключением названий регистров и структуры записи таблицы страниц: в riscv32 и базовый адрес каталога страниц, и бит включения страничной организации находятся в регистре satp. Что касается различий в структуре записи таблицы страниц — здесь мы не будем расписывать подробно, лучше обратитесь к RTFM.
Ситуация с mips32 сильно отличается. mips32 просто определяет разбиение виртуального адресного пространства; в PA мы будем использовать только следующие три сегмента адресного пространства, mips32 также определяет свойства остальных пространств — за подробностями обращайтесь к руководству:
[0x80000000, 0xa0000000)относится к пространству ядра, трансляция адреса не выполняется[0xa0000000, 0xb0000000)относится к пространству ввода-вывода, трансляция адреса не выполняется[0x00000000, 0x80000000)относится к пользовательскому пространству, требуется трансляция адреса
Поскольку в пространстве ядра mips32 трансляция адреса не требуется, поддерживать так называемое отображение ядра тоже не нужно; кроме того, в mips32 необходимость трансляции адреса определяется самим адресным пространством, поэтому состояния «включена ли страничная организация» тоже не существует, и в mips32 нет статусного бита, подобного CR0.PG. Поэтому vme_init() в mips32-nemu очень простой — достаточно лишь зарегистрировать функции обратного вызова для управления страницами.
Вам нужно понять процесс постраничной трансляции адреса, а затем реализовать isa_mmu_check() (определена в nemu/src/isa/$ISA/include/isa-def.h) и isa_mmu_translate() (определена в nemu/src/isa/$ISA/system/mmu.c). Вы можете обратиться к документации по API NEMU, связанным с ISA, чтобы разобраться в их поведении. Кроме того, поскольку мы не планируем реализовывать механизм защиты, в реализации isa_mmu_translate() обязательно используйте assertion для проверки битов present/valid записи каталога страниц и записи таблицы страниц; если обнаружена недействительная запись, своевременно прекратите выполнение NEMU, иначе отладка будет крайне затруднена. Обычно это вызвано ошибкой в вашей реализации — проверьте её корректность.
Напоследок напомним об одном особом случае, возникающем при постраничной трансляции адреса в x86. Поскольку x86 не требует строгого выравнивания данных, может возникнуть ситуация, когда данные пересекают границу виртуальной страницы, например, первый байт длинной инструкции находится в конце одной виртуальной страницы, а остальные байты — в начале другой. Если эти две виртуальные страницы отображаются на две непоследовательные физические страницы, потребуется выполнить постраничную трансляцию адреса дважды, считать нужные байты из каждой из этих двух физических страниц по отдельности, а затем склеить их в единое возвращаемое значение. Однако согласно принципу KISS, пока можно временно не реализовывать обработку этого особого случая: после определения, что данные пересекают границу виртуальной страницы, сначала завершайте работу NEMU через assert(0), а обрабатывать эту ситуацию будете, когда она действительно возникнет. А вот mips32 и riscv32, будучи RISC-архитектурами, строго выравнивают инструкции и данные по 4 байта, поэтому такая ситуация у них не возникает — иначе CPU выбросил бы исключение; как видим, гибкость программного обеспечения и сложность аппаратуры — ещё одна пара компромиссов (tradeoff) в компьютерных системах.
Запустите Nanos-lite поверх механизма страничной организации
Реализуйте следующее:
pg_alloc()в Nanos-lite. Параметромpg_alloc()служит количество байт для выделения, но мы гарантируем, что AM через функцию обратного вызова всегда запрашивает уpg_alloc()объём, кратный размеру страницы, поэтомуpg_alloc()можно реализовать через вызовnew_page(). Кроме того,pg_alloc()должна обнулять выделенные страницы.map()в VME. Базовый адрес каталога страниц можно получить черезas->ptr. Если требуется запросить новую таблицу страниц, можно получить свободную физическую страницу у Nanos-lite через функцию обратного вызоваpgalloc_usr().- Реализуйте механизм страничной организации в NEMU.
Поскольку в данный момент Nanos-lite выполняется в виртуальном адресном пространстве ядра, а эти отображения — тождественные, результат трансляции адреса NEMU pa обязательно должен совпадать с va. Вы можете добавить это условие в код NEMU как assertion, чтобы помочь себе выявлять баги реализации.
Если ваша реализация верна, вы увидите, что Chinese Paladin тоже успешно запускается. Если у вас есть вопросы по деталям механизма страничной организации, обратитесь к RTFM.
Для x86 и riscv32 реализовывать TLB не нужно.
Для mips32 на данном этапе нельзя проверить, верна ли ваша реализация, поскольку в mips32 процесс трансляции адреса запускается только при обращении к пользовательскому пространству. Поэтому если вы выбрали mips32, вам нужно выполнить содержание ниже, чтобы протестировать свою реализацию.
Пусть DiffTest поддерживает механизм страничной организации
Чтобы механизм DiffTest работал корректно, вам нужно:
- Для x86:
- В функции
restart()нам нужно инициализировать регистр CR0 значением0x60000011, но вникать в смысл этого значения не обязательно. - Реализовать функциональность битов accessed и dirty в механизме страничной организации
- В функции
- При обработке команды
attachнужно синхронизировать регистры, связанные с механизмом страничной организации, в REF - Обновить функциональность снимков состояния
Это всё же необязательное задание, поэтому подробности реализации мы не подсказываем — столкнувшись с трудностями, подумайте над решением самостоятельно.
А вот для mips32 введённый TLB тоже относится к состоянию машины, поэтому для идеального выполнения DiffTest нужно подумать, как синхронизировать TLB с REF. Это действительно непростая задача, вы можете подумать, как её решить, хотя отказ от выполнения DiffTest тоже является допустимым решением.
Механизм страничной организации RISC-V
Если внимательно изучить RTFM, вы обнаружите, что стандартный механизм страничной организации RISC-V может быть включён только в режимах S и U, а обращения к памяти в режиме M не проходят через трансляцию адреса MMU. Однако в NEMU мы упростили это, разрешив трансляцию адреса и для обращений в режиме M — так можно избежать введения деталей, связанных с режимом S, и позволить всем сосредоточиться на самом механизме страничной организации.
Запуск пользовательских процессов поверх механизма страничной организации
После успешной реализации механизма страничной организации вы обнаружите, что Chinese Paladin тоже успешно запускается. Но если подумать внимательнее, становится ясно, что здесь что-то не так: мы создали виртуальное адресное пространство ядра в vme_init() и больше никогда не переключались на другое виртуальное адресное пространство. Это значит, что мы заставили Chinese Paladin работать поверх виртуального адресного пространства ядра! Это совершенно неразумно — ведь у пользовательского процесса всё же должно быть собственное виртуальное адресное пространство. Более того, ранее Navy-apps линковала пользовательскую программу по адресу 0x3000000/0x83000000 именно потому, что Nanos-lite тогда не управляла свободной физической памятью; теперь же с введением механизма страничной организации за выделение всех физических страниц отвечает MM. Это означает, что если в дальнейшем MM выделит физическую страницу, где находится 0x3000000/0x83000000, содержимое Chinese Paladin будет затёрто (вы уже сталкивались с этой проблемой ранее при запуске exec-test)! Поэтому хотя сейчас Chinese Paladin с виду успешно работает, на самом деле внутри затаилась опасность.
Правильный подход — заставить пользовательский процесс выполняться поверх виртуального адресного пространства, выделенного ему операционной системой. Для этого нам нужно внести некоторые изменения в проект. Во-первых, при компиляции приложения Navy нужно добавить в make параметр VME=1, что позволит изменить адрес компоновки приложения на 0x40000000 — это нужно, чтобы избежать взаимного пересечения виртуального адресного пространства пользовательского процесса и ядра, приводящего к непредвиденным ошибкам. В этот момент уже проявляется преимущество «виртуального адреса как абстракции физического адреса»: в принципе, пользовательский процесс может работать по любому виртуальному адресу, не ограничиваясь ёмкостью физической памяти. Мы заставляем код пользовательского процесса начинаться около 0x40000000 — этот адрес уже находится за пределами адресного пространства физической памяти (NEMU предоставляет 128 МБ физической памяти), но механизм страничной организации гарантирует, что процесс сможет корректно работать. Таким образом, ни компоновщику, ни самой программе не нужно заботиться о том, какой именно участок физической памяти будет использоваться во время выполнения программы, — им достаточно использовать виртуальные адреса, а отображение между виртуальными и физическими адресами целиком поручается MM операционной системы.
Кроме того, нам нужно внести довольно много изменений в процесс создания пользовательского процесса. Сначала нужно создать адресное пространство для пользовательского процесса ещё до его загрузки. Поскольку адресное пространство привязано к процессу, мы включаем структуру AddrSpace как часть PCB. После этого достаточно вызвать protect() в начале context_uload(), чтобы создать адресное пространство. Пока в этом адресном пространстве нет ничего, кроме отображения ядра — подробности можно посмотреть в abstract-machine/am/src/$ISA/nemu/vme.c.
Однако теперь loader() не может напрямую загружать пользовательский процесс в область памяти около 0x40000000, поскольку этот адрес не находится в виртуальном адресном пространстве ядра, и ядро не может обращаться к нему напрямую. Задача loader() теперь такова: после определения размера программы загружать её постранично:
- Запросить одну свободную физическую страницу
- Через
map()отобразить эту физическую страницу в виртуальное адресное пространство пользовательского процесса. Поскольку AM native реализует проверку прав, чтобы программа могла корректно работать на AM native, при вызовеmap()нужно установитьprotравным «доступно для чтения, записи и выполнения» - Прочитать из файла содержимое одной страницы в эту физическую страницу
Всё это нужно, чтобы пользовательский процесс в дальнейшем мог корректно работать: пользовательский процесс в будущем обращается к памяти по виртуальным адресам, и благодаря отображению, поддерживаемому загрузчиком для пользовательского процесса, виртуальный адрес транслируется в физический, и физическая память, к которой обращаются по этому физическому адресу, оказывается как раз теми данными, которые пользовательский процесс хочет получить.
Ещё один вопрос, который нужно учесть, — пользовательский стек: аналогично loader(), нам нужно через map() отобразить физическую страницу, полученную через new_page(), в виртуальное адресное пространство пользовательского процесса. Мы размещаем виртуальный адрес пользовательского стека в конце виртуального адресного пространства пользовательского процесса, конечную позицию можно получить через as.area.end, а затем отобразить физическую страницу пользовательского стека на участок виртуального адресного пространства [as.area.end - 32KB, as.area.end).
Наконец, чтобы это адресное пространство вступило в силу, нам также нужно закрепить его в MMU. Конкретно: мы хотим переключать адресное пространство именно тогда, когда CTE восстанавливает контекст процесса. Для этого нужно добавить указатель дескриптора адресного пространства процесса as->ptr в контекст; каркасный код уже реализовал эту функциональность (см. abstract-machine/am/include/arch/$ISA-nemu.h), в x86 это поле называется cr3, а в mips32/riscv32 — pdir. Вам также нужно:
- Изменить реализацию
ucontext(), чтобы устанавливать указатель дескриптора адресного пространства в создаваемом контексте пользовательского процесса - Вызвать
__am_get_cur_as()в начале__am_irq_handle()(определена вabstract-machine/am/src/$ISA/nemu/vme.c), чтобы сохранить текущий указатель дескриптора адресного пространства в контекст - Вызвать
__am_switch()перед возвратом из__am_irq_handle()(определена вabstract-machine/am/src/$ISA/nemu/vme.c), чтобы переключить адресное пространство, закрепив адресное пространство запланированного процесса в MMU
Реализуйте настоящий механизм страничной организации для mips32
Если вы выбрали mips32, теперь вам нужно реализовать настоящий механизм страничной организации; если нет — можете пропустить это задание.
Когда CPU пытается выполнить трансляцию адреса и происходит TLB miss, аппаратура устанавливает текущий номер виртуальной страницы в entryhi, а затем выбрасывает исключение TLB refill. Это исключение будет перехвачено CTE, которая затем вызовет функцию __am_tlb_refill():
- Считать базовый адрес каталога страниц текущего процесса (подумайте, как его получить?)
- Считать номер виртуальной страницы из entryhi
- Выполнить page table walk на основе номера виртуальной страницы
- Установить номера физических страниц, соответствующие двум последовательным виртуальным страницам, в entrylo0 и entrylo1
- Выполнить соответствующие инструкции управления TLB, чтобы обновить запись TLB
После возврата из исключения TLB refill CPU снова выполнит ту же самую инструкцию, и на этот раз трансляция адреса должна пройти успешно. Чтобы программное обеспечение могло выполнять page table walk, вам нужно реализовать __am_tlb_refill() (определена в abstract-machine/am/src/mips32/nemu/vme.c).
Согласно изложенному выше, нам также нужно поддерживать связь между записями TLB и процессами, что должно осуществляться через ASID. Однако здесь мы можем упростить задачу: по аналогии с x86, при переключении адресного пространства мы тоже решаем проблему, полностью очищая TLB. Для этого вам также нужно реализовать __am_tlb_clear() (определена в abstract-machine/am/src/mips32/nemu/vme.c).
Запустите пользовательский процесс поверх механизма страничной организации
Основываясь на изложенном выше содержании методички, внесите соответствующие изменения в процесс создания пользовательского процесса, чтобы он успешно работал поверх механизма страничной организации. Если вы выбрали mips32 или riscv32, обратите внимание на положение дескриптора адресного пространства в структуре контекста; если не уверены в этом положении, проверьте реализацию своего кода по содержанию методички из PA3.
Чтобы протестировать корректность реализации, сначала запустим отдельно dummy (не забудьте изменить код планирования) и сначала вызовем halt() в реализации exit, чтобы завершить работу системы, — это потому, что для успешного запуска других программ потребуются дополнительные изменения. Если ваша реализация верна, вы увидите, что программа dummy в конце выведет сообщение GOOD TRAP, что означает, что она действительно успешно заработала поверх механизма страничной организации.
Пусть DiffTest поддерживает механизм страничной организации (2)
Если вы выбрали riscv32, чтобы механизм DiffTest корректно поддерживал работу пользовательского процесса, вам также нужно:
- Реализовать режимы привилегий
MиU, а именно:- Реализовать функциональность бита
mstatus.MPPв NEMU - При выполнении инструкции
ecallвыбрасывать исключение с разными номерами в зависимости от текущего уровня привилегий, но обрабатывать их единообразно в CTE - При создании контекста потока ядра дополнительно установить
mstatus.MPPв режимM - При создании контекста пользовательского процесса дополнительно установить
mstatus.MPPв режимU
- Реализовать функциональность бита
- При заполнении таблицы страниц дополнительно установить биты
R,W,X,U,A,D - При создании контекста пользовательского процесса дополнительно установить биты
MXRиSUMвmstatus
Роль отображения ядра
Для x86 и riscv32, при создании адресного пространства в protect(), есть участок кода, используемый для копирования отображения ядра:
// map kernel space
memcpy(updir, kas.ptr, PGSIZE);
Попробуйте закомментировать этот участок кода, перекомпилировать и запустить программу — вы увидите, что произойдёт ошибка. Объясните, почему возникает эта ошибка.
Чтобы запустить Chinese Paladin поверх механизма страничной организации, нам также нужно рассмотреть вопрос области кучи. Раньше мы заставляли функцию mm_brk() напрямую возвращать 0, обозначая, что изменение размера области кучи пользовательского процесса всегда успешно, — это было потому, что до реализации механизма страничной организации память выше 0x3000000/0x83000000 была свободна для использования пользовательским процессом. Теперь, когда пользовательский процесс работает поверх механизма страничной организации, нам также нужно в mm_brk() отображать заново запрошенную область кучи в виртуальное адресное пространство — только так можно гарантировать, что пользовательский процесс, работающий поверх механизма страничной организации, сможет корректно обращаться к заново запрошенной области кучи.
Чтобы определить, какая часть области кучи является заново запрошенной, нам также нужно отслеживать положение области кучи. Поскольку использование области кучи у каждого процесса независимо, нам нужно поддерживать положение области кучи отдельно для каждого, поэтому мы добавляем в PCB поле max_brk, чтобы фиксировать максимальную позицию, которой когда-либо достигал program break. Введение max_brk упрощает реализацию: мы можем не реализовывать функциональность освобождения области кучи, а лишь выделять физические страницы только для той части виртуального адресного пространства текущего нового program break, которая превышает max_brk.
Запустите Chinese Paladin поверх механизма страничной организации
Основываясь на изложенном выше, реализуйте функцию mm_brk() в nanos-lite/src/mm.c. Обратите внимание на вопрос о том, нужно ли выравнивать параметр map() по странице (это зависит от вашей реализации map()).
После правильной реализации Chinese Paladin сможет корректно работать поверх механизма страничной организации.
Проблема согласованности — кошмар mips32 настиг вас
С теорией страничной организации мы почти закончили, но если вы выбрали mips32, при запуске Chinese Paladin вы, скорее всего, столкнётесь с самыми разными странными проблемами, и немало из них могут быть вызваны именно проблемой согласованности. Здесь содержимое TLB можно считать копией записей таблицы страниц в памяти...
О, раз уж вы решились выбрать mips32, дальше раскрывать особо не будем — попробуйте сами разобраться в этой проблеме и подумать над соответствующим решением. Только решив проблему согласованности, можно сказать, что вы по-настоящему поняли механизм страничной организации mips32.
Поддержка звука
Если вы ранее реализовали функциональность, связанную со звуковой картой, сейчас вы можете столкнуться с ошибкой. Попробуйте через RTFSC разобраться и устранить эту ошибку.
Реализация VME для native
Попробуйте прочитать реализацию VME для native. Как native реализует VME? Почему это возможно сделать именно так?
Можно ли создавать контекст пользовательского процесса на пользовательском стеке?
Поведение ucontext() — создание контекста пользовательского процесса на стеке ядра kstack. Можем ли мы изменить поведение ucontext() так, чтобы контекст пользовательского процесса создавался на пользовательском стеке? Почему?
Мультипрограммирование с поддержкой управления виртуальной памятью
Сделав большой крюк через введение управления виртуальной памятью, мы наконец возвращаемся к исходной задаче: теперь мы можем поддерживать параллельное выполнение нескольких пользовательских процессов. Однако сначала давайте позволим пользовательскому процессу, работающему поверх механизма страничной организации, выполняться параллельно с потоком ядра, чтобы дополнительно протестировать механизм страничной организации.
Для этого нам нужно подумать, как планирование потоков ядра повлияет на механизм страничной организации. Самое большое отличие потока ядра от пользовательского процесса в том, что у него нет адресного пространства пользовательского режима: код, данные и стек потока ядра находятся в адресном пространстве ядра. Так вот, после включения механизма страничной организации, если __am_irq_handle() нужно вернуться в контекст потока ядра, нужно ли нам предусматривать переключение на виртуальное адресное пространство потока ядра через __am_switch()?
Ответ: не нужно. Это потому, что все виртуальные адресные пространства, создаваемые AM, содержат отображение ядра, и независимо от того, в каком виртуальном адресном пространстве мы находились до переключения, поток ядра может корректно работать в этом виртуальном адресном пространстве. Поэтому достаточно в kcontext() установить указатель дескриптора адресного пространства контекста равным NULL в качестве специальной метки, и в дальнейшем, когда __am_irq_handle() будет вызывать __am_switch(), если обнаруживается, что указатель дескриптора адресного пространства равен NULL, переключение виртуального адресного пространства выполняться не будет.
Мультипрограммирование с поддержкой управления виртуальной памятью
Заставьте Nanos-lite загрузить и запустить Chinese Paladin вместе с потоком ядра hello. Результат работы на этом этапе будет таким же, как и на предыдущем, но на этот раз вся система будет работать поверх механизма страничной организации.
Однако мы обнаружим, что по сравнению с прошлым разом производительность Chinese Paladin, работающего поверх механизма страничной организации, заметно снизилась. Хотя NEMU эмулирует функциональность MMU последовательно и не может полностью отразить реальную работу аппаратного MMU, это всё же показывает, что механизм виртуальной памяти действительно вносит дополнительные накладные расходы во время выполнения. Именно поэтому инженеры 60-х годов в целом относились к механизму виртуальной памяти настороженно и не решались легко внедрять его в системы. Но преимущество «позволить нескольким программам выполняться параллельно без изменения самих программ» становилось всё более очевидным — настолько, что механизм виртуальной памяти стал стандартной составляющей современных компьютерных систем.
Параллельное выполнение нескольких пользовательских процессов
Заставьте Nanos-lite загрузить два пользовательских процесса — Chinese Paladin и hello; либо загрузите NTerm и поток ядра hello, а затем запустите Chinese Paladin из NTerm — при выполнении вы должны заметить ошибку. Попробуйте проанализировать причину этой ошибки и подытожить, каким условиям нужно удовлетворить, чтобы поддержать эту функциональность.
Это, пожалуй, самый сложный вопрос для размышления за всё первое прохождение; хотя мы дадим анализ в конце PA4, желающие принять вызов всё же могут попробовать подумать самостоятельно уже здесь: если вы сможете решить эту проблему самостоятельно, это будет означать, что ваше понимание компьютерных систем можно назвать весьма впечатляющим.
Подсказка: программа — это машина состояний.
Содержание этого этапа можно считать самым сложным во всём PA — даже сложность необязательных заданий уже не сопоставима с прежней. Это также демонстрирует вызов, связанный с построением систем: по мере того как система становится всё более законченной, взаимодействие между модулями становится всё сложнее, и код, который на первый взгляд кажется упрощённым, на самом деле выверен буквально до каждого слова — тронешь одно, и отзовётся во всём. Однако это неизбежная закономерность роста сложности проекта: как только объём кода достигает определённого уровня, даже разработка обычного приложения сталкивается с похожими трудностями. Так как же нам понимать и управлять проектным кодом, сложность которого постоянно растёт?
Ответ — абстракция. Поэтому все те разнообразные API, которые вы видите в PA, определены не как попало — они действительно отражают суть поведения соответствующих модулей, помогая нам легче понимать поведение всей системы с макроскопической точки зрения; даже при отладке эти API оказывают огромную помощь в том, чтобы разобраться в поведении кода. По мере того как вы понимаете, реализуете и отлаживаете эти API, ваше понимание всей системы становится всё глубже. Если вы действительно дошли до этого места самостоятельно, то, столкнувшись в будущем с более сложными проектами, вы, наверное, уже не будете их бояться.
Дружеское напоминание
На этом этап 2 PA4 завершается.