
Ввод и вывод
Мы успешно запустили разные тестовые случаи из cpu-tests, но эти тесты умеют только молча делать чистые вычисления. Вспомните первую программу hello с курса программирования: хотя бы одну строку она выводила. На самом деле ввод и вывод — основное средство взаимодействия компьютера с внешним миром. Если ещё помните, что полное имя программы BIOS, которая выполняется при старте компьютера, — Basic Input/Output System, поймёте, насколько ввод и вывод важны для компьютера. В настоящих компьютерах ввод и вывод делают через доступ к устройствам I/O.
Устройства и CPU
Принцип работы устройств на самом деле не таинственен. Вскоре на лабораторной по цифровым схемам вы увидите код verilog, связанный с модулем контроллера клавиатуры и модулем контроллера VGA. О, так эти устройства тоже цифровые схемы! На самом деле достаточно послать устройству осмысленные цифровые сигналы — и оно будет работать по смыслу этих сигналов. Дать сигналам указывать устройству, как работать, — разве это не как «инструкции программы указывают CPU, как работать»? Именно так! У устройства тоже свои регистры состояния (как регистры CPU) и свои функциональные блоки (как ALU CPU — арифметико-логическое устройство). Разумеется, у разных устройств разные функциональные блоки: например, у клавиатуры есть узел, который превращает аналоговый сигнал нажатия в скан-код, а у VGA — узел, который превращает информацию о цвете пикселя в аналоговый сигнал дисплея. Сигнал, который управляет работой устройства, называют «командным словом»; его можно понимать как «инструкцию устройства». Работа устройства — принимать командное слово, декодировать и выполнять... Вы уже знаете, как работает CPU, всё это вам слишком знакомо.
Раз устройства служат для ввода и вывода, доступ к устройству по сути — получить данные с устройства (ввод), например скан-код клавиши с контроллера клавиатуры, или послать данные на устройство (вывод), например записать в видеопамять цветовую информацию изображения. Но что, если пользователь не нажимал клавиши, или хочет сменить разрешение экрана? Значит, кроме чистого чтения и записи данных, устройством ещё нужно управлять: например, прочитать состояние контроллера клавиатуры и узнать, нажата ли сейчас клавиша; или нужен способ запросить или задать разрешение контроллера VGA. Итак, с точки зрения программы доступ к устройству = прочитать данные + записать данные + управлять состоянием.
Мы хотим, чтобы компьютер управлял устройствами и заставлял их делать то, что нам нужно; эта задача без сюрпризов ложится на CPU. Кроме вычислений CPU ещё должен обращаться к устройствам и вместе с ними выполнять разные задачи. Так что с точки зрения CPU что эти действия на самом деле значат? Конкретно: откуда читать данные? куда писать данные? как запросить/задать состояние устройства? Самый сущностный вопрос: каков интерфейс между CPU и устройством?
Ответ, возможно, гораздо проще, чем кажется: раз у устройства тоже есть регистры, самый простой способ — взять регистры устройства как интерфейс и дать CPU к ним обращаться. Например, CPU может читать/писать данные в регистр данных устройства — это ввод и вывод; читать состояние из регистра состояния — спросить, занято ли устройство; или записать командное слово в регистр команд — изменить состояние устройства.
Так как же CPU обращается к регистрам устройства? Сначала вспомним, как CPU обращается к своим регистрам: сначала регистрам дают номера, например eax — 0, ecx — 1... затем в инструкции ссылаются на эти номера, на схеме есть соответствующий селектор, который выбирает регистр и читает/пишет. Доступ к регистрам устройства похож: регистрам устройства, к которым CPU разрешено обращаться, тоже можно дать номера и ссылаться на них из инструкций. У устройства могут быть и частные регистры, которые оно ведёт само: у них таких номеров нет, CPU к ним напрямую не обратиться.
Это и есть способ адресации I/O, поэтому эти номера называют также адресами устройства. Обычно используют два способа адресации.
Портовый I/O
Один способ адресации I/O — port-mapped I/O (портово-отображаемый I/O): CPU обращается к устройствам специальными инструкциями I/O, а адрес устройства называют номером порта. Когда номер порта есть, его указывают в инструкции I/O — и ясно, к какому регистру устройства обращаться. Большинство компьютеров на рынке — совместимые с IBM PC, и у совместимых с IBM PC есть особые правила распределения номеров портов для обычных устройств.
x86 даёт инструкции in и out для доступа к устройствам: in переносит данные из регистра устройства в регистр CPU, out — из регистра CPU в регистр устройства. Пример: инструкцией out послать командное слово на последовательный порт:
movl $0x41, %al
movl $0x3f8, %edx
outb %al, (%dx)
Код выше передаёт данные 0x41 в регистр устройства, соответствующий порту 0x3f8. После выполнения CPU передаст 0x41 в один из регистров последовательного порта; порт, приняв, обнаружит, что нужно вывести символ A; но для CPU всё равно, как устройство обработает 0x41: оно честно передаст 0x41 на порт 0x3f8. На самом деле API устройства и его поведение ясно определены в соответствующей документации; в PA эти детали знать не нужно, достаточно знать: разработчик драйвера может через RTFM написать программу, которая обращается к устройству.
Знакомое чувство?
API, поведение, RTFM... Верно, снова пример дизайна компьютерных систем: устройство открывает CPU интерфейс своих регистров и абстрагирует сложное внутреннее поведение (даже свойства аналоговых схем), CPU достаточно этим интерфейсом обратиться к устройству — и получит ожидаемую функцию.
В компьютерных системах повсюду идея абстракции; стоит понять принципы и добавить навык RTFM — и вы освоите компьютерные системы целиком!
I/O, отображённый на память
Port-mapped I/O берёт номер порта как часть инструкции I/O: способ простой, и это же его главный минус. Набор инструкций ради совместимости с уже написанными программами можно только расширять, но не менять. Значит, размер адресного пространства I/O, доступного port-mapped I/O, решён в момент дизайна инструкции I/O. Адресное пространство I/O — по сути множество адресов всех доступных устройств. Устройств всё больше, функции всё сложнее — ограниченного пространства port-mapped I/O постепенно не хватает. Некоторым устройствам нужно, чтобы CPU обращался к довольно большому непрерывному хранилищу, например видеопамять VGA: при 24-битном цвете плюс канал Alpha и разрешении 1024x768 нужен диапазон адресации 3MB. Так родился memory-mapped I/O (MMIO, I/O, отображённый на память).
Такая адресация MMIO очень изящна: устройства адресуют разными адресами физической памяти. Этот способ «перенаправляет» доступ к части физической памяти в адресное пространство I/O: когда CPU пытается обратиться к этой части физической памяти, на самом деле обращается к соответствующему устройству I/O, а CPU об этом не знает. После этого CPU может обращаться к устройствам обычными инструкциями обращения к памяти. В этом и уникальный плюс MMIO: адресное пространство физической памяти и разрядность CPU будут расти, и MMIO никогда не нужно бояться, что пространство I/O кончится. В принципе единственный минус MMIO: CPU обычным путём уже не обратиться напрямую к той физической памяти, которая отображена в пространство I/O. Но с развитием компьютеров этот единственный минус всё незаметнее: современные компьютеры уже 64-битные, физических адресных линий 48, значит физическое адресное пространство — 256TB, вырезать из него 3MB под видеопамять — вообще ни о чём.
Именно поэтому MMIO стал основным способом адресации I/O современных компьютеров: архитектуры RISC дают только адресацию MMIO, а PCI-e, сетевые карты, APIC x86 и другие основные устройства поддерживают доступ через MMIO.
Как RISC-архитектуры, mips32 и riscv32 используют адресацию MMIO. Для x86 пример MMIO — физический адресный интервал [0xa1000000, 0xa1800000) в NEMU. Этот интервал отображён на видеопамять внутри VGA; чтение и запись этого интервала эквивалентны чтению и записи данных видеопамяти VGA. Например:
memset((void *)0xa1000000, 0, SCR_SIZE);
обнулит в видеопамяти данные размером с экран, то есть запишет чёрные пиксели на весь экран — по сути очистка экрана. Видно: модель программирования MMIO полностью совпадает с обычным программированием: программист может обращаться к устройству I/O как к памяти. Эту черту разработчики драйверов очень любят.
Понять ключевое слово volatile
Возможно, вы никогда не слышали о ключевом слове volatile в C, но оно есть с рождения языка. Назначение volatile особое: не давать компилятору оптимизировать соответствующий код. Стоит руками ощутить роль volatile: под GNU/Linux напишите следующий код:
void fun() {
  extern unsigned char _end;  // что такое _end?
  volatile unsigned char *p = &_end;
  *p = 0;
  while(*p != 0xff);
  *p = 0x33;
  *p = 0x34;
  *p = 0x86;
}
Затем скомпилируйте код с
-O2. Попробуйте убрать из кода ключевое словоvolatile, снова скомпилировать с-O2и сравнить дизассемблирование до и после удаленияvolatile.Возможно, недоумение: оптимизация кода — разве не хорошо? Зачем существует такая странность, как
volatile? Подумайте: если адрес, на который указываетp, в итоге отображён на регистр устройства, какие проблемы может принести удалениеvolatile?
Ввод/вывод с взгляда конечного автомата
В PA1 мы говорили: и компьютер, и программу можно рассматривать как конечный автомат, состояние этого автомата можно записать как S = <R, M>, где R — состояние регистров, M — состояние памяти. Когда компьютеру добавили ввод и вывод, как понимать поведение ввода и вывода?
Устройство можно разделить на две части; одна — цифровая схема. Мы кратко представили некоторые функции контроллеров устройств: например, CPU может прочитать информацию о клавише из контроллера клавиатуры. Раз это цифровая схема, последовательную логику внутри можно считать состоянием D цифровой части устройства. Но D особое: компьютер может читать и менять D только инструкциями портового I/O или инструкциями обращения к памяти MMIO.
Интересна другая часть устройства: аналоговая схема — она тоже может менять D. Например, клавиатура по изменению ёмкости в позиции клавиши судит, нажата ли клавиша; если да — записывает информацию о клавише в регистр контроллера клавиатуры. А меняется ли ёмкость в позиции клавиши, решает, нажал ли пользователь клавишу в физическом мире. Поэтому говорят: устройство — мост между компьютером и физическим миром.
  модель конечного автомата    |           вне модели конечного автомата
  S = <R, M>                   |                D
  компьютер/программа  <----инструкция I/O----> устройство <----аналоговая схема----> физический мир
                               |
                               |
Моделировать состояние и поведение устройств очень трудно: кроме того что поведение самих устройств самое разное, на состояние устройства постоянно влияет физический мир. Поэтому, расширяя поведение модели конечного автомата, мы не включаем D в S, а моделируем только поведение инструкций, связанных с вводом и выводом:
- при выполнении обычных инструкций автомат переходит по модели TRM
- при выполнении инструкций вывода на устройство (например
outв x86 или запись MMIO в архитектурах RISC) кроме обновления PC остальные состояния автомата не меняются, но состояние устройства и физический мир изменятся соответственно - при выполнении инструкций ввода с устройства (например
inв x86 или чтение MMIO в архитектурах RISC) переход автомата «разветвится»: у автомата больше нет единственного нового состояния, как у TRM; в какое новое состояние он перейдёт, зависит от состояния устройства в момент выполнения этой инструкции
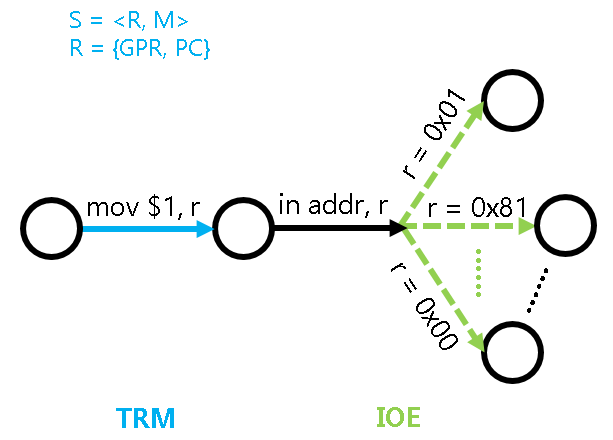
Например, на рисунке выше программа собирается выполнить инструкцию in addr, r: она прочитает данные из адреса устройства addr в регистр CPU r. Допустим, этот адрес устройства соответствует некоторому контроллеру клавиатуры; после выполнения в r может быть 0x01 — прочитана информация «нажата клавиша со скан-кодом 1»; может быть 0x81 — «отпущена клавиша со скан-кодом 1»; может быть 0x0 — информации о клавишах нет. Этот неопределённый переход состояния повлияет на дальнейшую работу программы: например, игра по прочитанной информации о клавишах решит, как ответить; но нетрудно понять: как игра отвечает, реализуют обычные вычислительные инструкции TRM, к вводу и выводу это не относится.
Эта расширенная модель конечного автомата с микроскопического взгляда говорит: ввод и вывод устройства обмениваются данными через регистры CPU. Влияние ввода и вывода на программу проявляется лишь в том, что при вводе происходит один переход состояния, который нельзя заранее определить, — по сути это и есть весь ввод и вывод глазами программы.
Ввод/вывод с обменом данными через память
Мы знаем S = <R, M>; портовый I/O и MMIO выше все обмениваются данными через регистры R. Естественно спросить: есть ли способ ввода/вывода с обменом через память M?
На самом деле есть — это DMA. Чтобы поднять производительность, у сложных устройств обычно есть функция DMA. Но устройства в NEMU довольно простые, детали DMA не разбираем.
Ввод и вывод в NEMU
Каркасный код NEMU уже дал связанный с устройствами код в каталоге nemu/src/device/.
Отображения и способы I/O
NEMU реализовал два способа адресации I/O: port-mapped I/O и memory-mapped I/O. Но и у того и у другого ядро — отображение (mapping). Естественно, управляя отображениями, оба способа можно унифицировать.
Конкретно каркас определил для отображения тип структуры IOMap (в nemu/include/device/map.h): имя, начальный и конечный адреса отображения, целевое пространство отображения и callback. Затем в nemu/src/device/io/map.c реализовано управление отображениями: выделение пространства I/O и его отображение, а также интерфейс доступа к отображению.
Среди них map_read() и map_write() отображают адрес addr в целевое пространство, указанное map, и выполняют доступ. При доступе может сработать соответствующий callback и обновить состояние устройства и целевого пространства. Поскольку NEMU — однопоточная программа, всю компьютерную систему она может симулировать только последовательно: callback устройства вызывается только при чтении/записи I/O. На этих двух API легко реализовать симуляцию port-mapped I/O и MMIO.
nemu/src/device/io/port-io.c — симуляция port-mapped I/O. Функция add_pio_map() при инициализации устройства регистрирует отображение port-mapped I/O. pio_read() и pio_write() — интерфейс чтения/записи портового I/O со стороны CPU; в итоге они вызовут map_read() и map_write() и обратятся к пространству I/O, зарегистрированному через add_pio_map().
Симуляция MMIO похожа: paddr_read() и paddr_write() решат, попадает ли адрес addr в пространство физической памяти или в пространство устройств. Если в пространство физической памяти — обратятся к настоящей физической памяти через pmem_read() и pmem_write(); иначе — к соответствующему устройству через map_read() и map_write(). С этого взгляда память и периферия для CPU ничем не отличаются: и то и другое — объекты с байтовой адресацией.
Устройства
NEMU реализовал семь устройств: последовательный порт, часы, клавиатура, VGA, звуковая карта, диск, SD-карта; диск представим в конце PA, а SD-карта в PA не участвует. Для упрощения эти устройства непрограммируемые, реализованы только функции, нужные в NEMU. Чтобы включить симуляцию устройств, в menuconfig выберите связанную опцию:
[*] Devices --->
После перекомпиляции при запуске NEMU всплывёт новое окно — для вывода VGA (см. ниже). Заметьте: приглашение (nemu) в терминале по-прежнему ждёт ввода, и окно пока ничего не показывает.
NEMU симулирует устройства библиотекой SDL; связанный с SDL код — в nemu/src/device/device.c. Функция init_device() в основном делает следующее:
- вызывает
init_map()для инициализации - инициализирует указанные выше устройства; при инициализации VGA ещё связанная с SDL работа: создание окна, задание режима отображения и т.д.
- затем инициализация, связанная с таймером (alarm). Функция таймера понадобится только в конце PA4, пока её можно игнорировать.
С другой стороны, cpu_exec() после каждой инструкции вызывает device_update(). Эта функция сначала проверяет, прошло ли достаточно времени с прошлого обновления устройств; если да — попытается обновить экран и дальше проверить, нажаты/отпущены ли клавиши и нажата ли кнопка X окна; иначе сразу вернётся, чтобы не проверять слишком часто: указанные события происходят редко.
Абстрагировать ввод и вывод в IOE
Конкретная реализация доступа к устройствам связана с архитектурой. Например, видеопамять VGA в NEMU лежит в физическом адресном интервале [0xa1000000, 0xa1080000), но для программ native это недоступный незаконный интервал, поэтому программам native похожую функцию нужно реализовать иначе. Естественно, связанный с архитектурой доступ к устройствам отнести в AM. В отличие от TRM, доступ к устройствам даёт компьютеру ввод и вывод, поэтому мы выделяем их в новый класс API под именем IOE (I/O Extension).
Как абстрагировать доступ к устройствам разных архитектур в единый API? Вспомните, чего с точки зрения программы доступ к устройству на самом деле хочет: доступ к устройству = прочитать данные + записать данные + управлять состоянием. Дальше: управление состоянием по сути тоже чтение/запись регистров устройства, значит доступ к устройству = операции чтения/записи.
Да, вот так просто! Поэтому IOE даёт три API:
bool ioe_init();
void ioe_read(int reg, void *buf);
void ioe_write(int reg, void *buf);
Первый API — связанная с IOE инициализация. Два последних — прочитать содержимое регистра с номером reg в буфер buf и записать содержимое буфера buf в регистр с номером reg. Заметьте: регистр reg здесь — не регистр устройства, о котором говорили выше, потому что нумерация регистров устройства связана с архитектурой. В IOE мы хотим архитектуронезависимый «абстрактный регистр»; этот reg на самом деле номер функции, и мы договариваемся: на разных архитектурах смысл одного номера функции одинаков — так абстрагируются регистры устройства.
В abstract-machine/am/include/amdev.h определены номера «абстрактных регистров» обычных устройств и соответствующие структуры. Эти определения не зависят от архитектуры; каждая архитектура, реализуя свой API IOE, должна следовать этим определениям (соглашению). Чтобы удобно обращаться к этим абстрактным регистрам, klib даёт макросы io_read() и io_write(), которые дальше упаковывают API ioe_read() и ioe_write().
В частности, NEMU как платформа: поведение устройств не зависит от ISA, поэтому достаточно реализовать один IOE в каталоге abstract-machine/am/src/platform/nemu/ioe/, чтобы архитектуры платформы NEMU им делились. Там abstract-machine/am/src/platform/nemu/ioe/ioe.c реализует указанные три API IOE: ioe_read() и ioe_write() по номеру абстрактного регистра индексируют функцию-обработчик и вызывают её. Конкретная функция обработчика связана с номером регистра; ниже по очереди представим функции каждого устройства в NEMU.
Последовательный порт
Последовательный порт — самое простое устройство вывода. nemu/src/device/serial.c симулирует функцию последовательного порта. Большая часть функций упрощена, оставлен только регистр данных. При инициализации регистрируются порт длиной 8 байт в 0x3F8 и пространство MMIO длиной 8 байт в 0xa00003F8; оба отображаются на регистр данных порта. Поскольку NEMU симулирует компьютерную систему последовательно, регистр состояния порта может всегда быть свободен; когда CPU пишет данные в регистр данных, порт передаёт их в стандартный поток ошибок хоста.
На самом деле в $ISA-nemu упомянутая ранее функция putch() выводит как раз через последовательный порт. Однако AM кладёт putch() в TRM, а не в IOE, — выглядит странно. Действительно, самый исходный TRM теории вычислимости способности вывода не содержит, но для реальной компьютерной системы вывод — самая базовая функция: без вывода пользователь даже не узнает, что программа делает. Поэтому в AM добавление putch() даёт TRM способность выводить символы; расширенный TRM ближе к практической машине, а не только к математической модели, которая умеет лишь считать.
putch() в abstract-machine/am/src/platform/nemu/trm.c выводит символ на последовательный порт. Если выбрана x86, чтобы программа выводила через последовательный порт, в NEMU ещё нужно реализовать port-mapped I/O.
Запустить Hello World
Если выбрана x86, нужно реализовать инструкции in и out. Конкретно нужен RTFSC, затем в реализации in и out правильно вызвать pio_read() и pio_write(). Если выбраны mips32 или riscv32, дополнительного кода не нужно: каркас NEMU уже поддерживает MMIO.
После реализации в каталоге am-kernels/kernels/hello/ введите
make ARCH=$ISA-nemu run
Если реализация верна, программа выведет в терминал некоторую информацию (следите, чтобы вывод не утонул в отладочных сообщениях).
Заметьте: этот hello и первая программа hello с курса программирования лежат на разных слоях абстракции: этот hello можно сказать работает прямо на голом железе и поверх абстракции AM может выводить прямо на устройство (последовательный порт); а hello с курса программирования лежит поверх ОС, устройствами напрямую не управляет, выводит только через службы ОС, и данные вывода проходят много слоёв абстракции, прежде чем дойти до слоя устройств. Роль ОС дальше ощутите в PA3.
Устройства и DiffTest
С взгляда конечного автомата выполнение инструкции ввода делает переход состояния неоднозначным: новое состояние зависит от состояния устройства. Поскольку поведение устройств в NEMU мы задали сами и оно не полностью совпадает со стандартными устройствами REF (например, последовательный порт в NEMU всегда готов, а в QEMU, возможно, нет), результат выполнения инструкции ввода в NEMU будет отличаться от REF. Чтобы DiffTest работал нормально, каркас при доступе к устройствам вызывает difftest_skip_ref() (см. функцию find_mapid_by_addr() в nemu/include/device/map.h) и пропускает проверку с REF.
В AM у функции main() допускается строковый аргумент; его задают через mainargs, и среда выполнения AM отвечает за передачу его в main() для программы AM. Конкретный способ передачи связан с архитектурой. Например, при запуске hello можно дать строковый аргумент:
make ARCH=$ISA-nemu run mainargs=I-love-PA
Программа hello выведет этот аргумент как есть.
Понять mainargs
Через RTFSC поймите, как этот аргумент передаётся из команды make в программу hello. $ISA-nemu и native используют разные способы передачи, оба стоит узнать.
Реализовать printf
С putch() в klib уже можно реализовать printf().
sprintf() вы уже реализовали; по функции он очень похож на printf(), значит между ними будет немало повторяющегося кода. Вред привычки Copy-Paste вы уже видели; подумайте, как реализовать их кратко.
Реализовав printf(), в программах AM уже можно пользоваться отладкой через вывод.
Запустить alu-tests
В каталог am-kernels/tests/alu-tests/ мы перенесли программу специально для теста разных операций языка C; реализовав printf(), её можно запускать. Компиляция может занять около 1 минуты.
Часы
С часами программа может давать связанный со временем опыт: частота кадров игры, скорость программы и т.д. nemu/src/device/timer.c симулирует функцию таймера i8253. Большая часть функций таймера упрощена, оставлена только функция «инициировать прерывание часов» (пока ею не пользуемся). Одновременно добавлены пользовательские часы. При инициализации таймера i8253 регистрируются порт длиной 8 байт в 0x48 и пространство MMIO длиной 8 байт в 0xa0000048; оба отображаются на два 32-битных регистра RTC. CPU может обратиться к этим двум регистрам и получить текущее время в 64-битном представлении.
Почему не сделать один 64-битный регистр RTC?
Мы хотим развязать дизайн устройства и CPU: какое бы CPU ни подключили, устройство должно работать. Но 32-битный CPU не может за раз обратиться к 64-битному регистру устройства, поэтому 64-битную функцию разбивают на два 32-битных регистра устройства — так можно поддерживать и 32-битные, и 64-битные CPU.
В abstract-machine/am/include/amdev.h для функции часов определены два абстрактных регистра:
AM_TIMER_RTC, часы реального времени AM (RTC, Real Time Clock); можно прочитать текущие год, месяц, день, час, минуту, секунду. В PA пока не используем.AM_TIMER_UPTIME, время работы системы AM; можно прочитать число микросекунд с момента старта системы.
RTC — часы реального времени
RTC в широком смысле — часы, скорость хода которых совпадает с реальным временем; по RTC пользователь может измерять отрезок времени. По этому определению оба абстрактных регистра AM выше — RTC, но акценты разные: AM_TIMER_RTC подчёркивает, что прочитанное время полностью совпадает с реальным, AM_TIMER_UPTIME — время, прошедшее с старта системы, то есть счёт с 0.
Хотя регистр устройства в NEMU тоже называется RTC, чтобы поддержать AM_TIMER_UPTIME, его не обязательно реализовывать как AM_TIMER_RTC.
Реализовать IOE
В abstract-machine/am/src/platform/nemu/ioe/timer.c реализуйте функцию AM_TIMER_UPTIME. Связанный с вводом и выводом код, которым можно пользоваться, есть в abstract-machine/am/src/platform/nemu/include/nemu.h и abstract-machine/am/src/$ISA/$ISA.h.
После реализации в $ISA-nemu запустите тест real-time clock test из am-kernel/tests/am-tests. Если реализация верна, программа каждую секунду будет выводить в терминал строку. Поскольку AM_TIMER_RTC мы не реализовали, тест всегда выводит 0 января 1900, 0:00:00 — это нормальное поведение, можно игнорировать.
Не запускайте связанные с IOE тесты, когда на native линкуетесь к klib
IOE на native реализован на библиотеке SDL; она предполагает, что поведение обычных библиотечных функций соответствует стандарту glibc, а наш klib обычно этому требованию не удовлетворяет. Поэтому __NATIVE_USE_KLIB__ только для теста реализации klib; мы не требуем, чтобы при определённом __NATIVE_USE_KLIB__ все программы работали правильно.
RTFSC — узнать как можно больше деталей
Студенты часто говорят: опыта чтения кода мало, не видели, как пишут хороший код. С другой стороны, эти же студенты в лабораторной заботятся только о том, куда вписать код, написали — и считают лабораторную сделанной, остальной код к содержанию будто не относится, читать не хотят.
С таким настроем вы сами отказываетесь от шанса тренировать способность. Если правда хотите учиться, не стоит думать «этот файл вроде можно не смотреть, какое мне дело», а стоит самим хотеть «программа выдала такой результат, прочту код и посмотрю, как он на самом деле написан». На самом деле в каркасном коде очень много сокровищ: даже тестовый код, кроме того что проясняет конкретное поведение тестов, ещё показывает, как программе пользоваться API AM, и даже стиль кодирования стоит перенять.
Поэтому как запустить тест real-time clock test — оставим вам на RTFSC.
Посмотреть, насколько быстро работает NEMU
С часами уже можно тестировать, как быстро выполняется программа, и тем самым — производительность компьютера. Попробуйте по очереди запустить в NEMU следующие benchmark (уже упорядочены по сложности программы, все в каталоге am-kernel/benchmarks/; при прогоне, пожалуйста, выключите точки наблюдения NEMU, trace и DiffTest, а в menuconfig снимите Enable debug information и перекомпилируйте NEMU, чтобы оценка была ближе к настоящей):
- dhrystone
- coremark
- microbench
После успешного запуска выведется оценка. У microbench оценка относительно процессора i9-9900K @ 3.60GHz: 100000 значит производительность как у эталонной машины, 100 — одна тысячная эталонной. Кроме сравнения с эталоном можно сравниться с товарищами. Если скомпилировать эти benchmark в native, можно ещё сравнить производительность native.
Кроме того, microbench даёт четыре набора разного масштаба: test, train, ref и huge. Можно сначала запустить масштаб test: он довольно быстро заканчивается, чтобы проверить правильность реализации NEMU, затем масштаб ref — чтобы измерить производительность. Конкретный способ запуска — в README.
Масштаб huge обычно для теста на настоящей машине; в NEMU он работает очень долго, запускать его не требуем.
Ориентир оценки
На настоящей машине RISC-V NEMU (разработанный по обычному процессу PA, без оптимизации), прогон входа ref у microbench даёт около 300~500. В виртуальной машине оценка ниже. Если в виртуальной машине оценка слишком низкая (например всего несколько баллов), в menuconfig можно сменить таймер NEMU с gettimeofday() на clock_gettime():
Miscellaneous
      Host timer (clock_gettime)
Если после перекомпиляции NEMU оценка заметно выросла, низкая производительность gettimeofday() может быть связана с источником часов (clocksource); можно попробовать подстроить по этому посту или перезапустить виртуальную машину или настоящую (некоторые студенты пишут, что перезапуск решает), затем вернуться к gettimeofday() и сравнить производительность.
Как отлаживать сложные программы
Программы становятся всё сложнее, отладка — всё труднее, баги — всё страннее. Это боль, через которую проходит почти каждый, кто делает PA: способностей, натренированных на курсе программирования, уже не хватает, чтобы писать правильные программы. Но после выпуска всё равно придётся встретить проекты на десятки и сотни тысяч строк, рядом с которыми PA — маленькая игрушка.
В PA мы даём вам встретить эту боль, в итоге надеясь, что вы поймёте настоящий метод отладки и сможете встретить более крупные проекты:
- RTFSC. Это чтобы понять, как происходят все детали; эти детали станут полезными нитями при отладке, потому что: только поняв, что такое «правильно», вы узнаете, что такое «неправильно»; чем яснее понимание «правильно», тем глубже понимание «неправильно».Поэтому когда встречаете баг и чувствуете беспомощность, совершенно не понимая, как такой баг мог появиться, почти всегда это потому, что раньше не хотели RTFSC, думали «не прочитал — и ладно», и в итоге нет нитей, которыми разобрать баг.
- Пользоваться подходящими инструментами. Баги странные и разные, но всегда есть способы решить их эффективно. В хендаутах мы представили много инструментов и методов, у каждого свои ситуации применимости и ограничения.Поэтому если есть первичная догадка о причине бага, но нет идеи, как отлаживать, почти всегда это потому, что инструменты и методы освоены нетвердо, и по ситуации не выбирается подходящий план отладки, или их вовсе проигнорировали, думая «не понял — и ладно». Например, в одном из необязательных вопросов мы уже предлагали эффективный способ разбирать ошибку сегментации; если при ошибке сегментации не знаете, что делать, и эту подсказку проигнорировали, скорее всего зря потратили много времени.
Навыки, которые тренирует PA, связаны; когда кажется, что время сэкономите «не читая внимательно код/хендауты/руководства», в будущем неизбежно заплатите больше: придут баги — и долг придётся отдать.
RTFSC — понять все детали
Про реализацию AM_TIMER_UPTIME в каркасе мы оставили несколько маленьких ям; если связанные проблемы не починить, при прогоне benchmark оценка может быть неверной. Это чтобы заставить всех всерьёз RTFSC и понять все детали хода выполнения программы: когда benchmark читает информацию часов, что происходит во всей компьютерной системе? Только так связанные с часами баги можно исправить правильно.
NEMU и интерпретаторы языков
В microbench есть тестовый проект bf — интерпретатор языка Brainf**k. Язык Brainf**k очень прост: всего 8 инструкций, даже понятия переменной нет, поэтому очень близок к машинному языку. Кому интересно — можно прочитать код bf.c: увидите, что у столь простого интерпретатора и у кажущегося сложным NEMU в принципе всё же есть сходство.
Сначала закончить, потом совершенствовать — подавить импульс оптимизировать код
Процесс дизайна компьютерной системы можно свести к двум делам:
- спроектировать функционально правильную полную систему (сначала закончить)
- на основе пункта 1 дать программе бежать быстрее (потом совершенствовать)
Увидев оценку, вас, возможно, потянет думать, как оптимизировать NEMU. Принцип выше говорит: время ещё не пришло. Одна причина: пока система не полна, очень трудно судить, в каком модуле окажется узкое место производительности. Совершенство, за которым вы сначала так гнались, в итоге для всей системы может оказаться каплей в море — и времени столько не стоило. Например, в PA1 вы могли тратить время на оптимизацию алгоритма вычисления выражений; это можно взять как упражнение в программировании, но если изначальная цель была производительность, отдача почти нулевая: выражение какой длины нужно ввести, чтобы явно ощутить преимущество нового алгоритма?
Кроме того, PA как учебный эксперимент: пока производительность не неприемлемо плоха, производительность — не первая цель, реализацию достаточно довести до рабочего состояния. Важнее через дизайн полной системы ощутить, как работают программы.
На самом деле кроме компьютеров принцип «сначала закончить, потом совершенствовать» применим во многих областях. Например, план предприятия: можно итерировать даже очень простой, но полный план; если с самого начала хотеть каждый пункт довести до совершенства, в итоге, скорее всего, не будет даже полного плана. То же с статьями: даже если есть только полные подзаголовки, уже можно проверить общий каркас на логические дыры; наоборот, какими бы красивыми ни были экспериментальные данные, при дырявой логике они себя не оправдают.
Чем крупнее проекты, тем труднее запустить полную систему правильно. Тогда следовать «сначала закончить, потом совершенствовать» ещё важнее: многие проблемы вскроются, только когда проект близок к полноте; жертвовать глобальной полнотой ради локального совершенства чаще всего — ехать не туда.
Правильно реализовав часы, на NEMU уже можно запускать демонстрационные программы: в каталог am-kernels/kernels/demo/ мы перенесли несколько маленьких демонстраций:
ant— муравей Лэнгтонаgalton— доска Гальтонаhanoi— Ханойские башниlife— «Жизнь» Конвеяaclock— часы, нуженAM_TIMER_RTC, NEMU пока не поддерживаетcmatrix— цифровой дождь из «Матрицы»donut— вращающийся 3D-пончикbf— фрактал множества Мандельброта программой на Brainf**k; у языка Brainf**k эффективность невысокая, потерпите
Чтобы их запустить, в klib ещё нужно реализовать malloc() и free(); пока можно простую версию:
- в
malloc()держать переменнуюaddr— позицию последней выделенной памяти; при каждом вызовеmalloc()возвращать пространство[addr, addr + size). Начальное значениеaddr—heap.start, то есть выделять с начала кучи. Можно также смотреть связанный код в microbench. Заметьте: уmalloc()есть требования к возвращаемому адресу, конкретно — RTFM. free()можно оставить пустым: только выделять, не освобождать. Сейчас доступной памяти в NEMU хватает на разные тестовые программы.
Исправление бага
Мы починили проблему, что hanoi не обновлял картинку. Если код am-kernels вы получили до 2023/10/11 18:40:00, поправьте код так:
--- am-kernels/kernels/demo/src/hanoi/hanoi.c
+++ am-kernels/kernels/demo/src/hanoi/hanoi.c
@@ -31,6 +31,6 @@
 static void add_disk(int i, int d) {
   t[i]->x[t[i]->n++] = d;
   text(t[i]->n, i, d, "==");
-
+  screen_refresh();
   usleep(100000);
 }
Запустить демонстрационные программы
Измените код в am-kernels/kernels/demo/include/io.h, закомментируйте макрос HAS_GUI, и демонстрации будут рисовать картинку символами в терминал. Этим программам клавиатура не нужна, поэтому даже без реализации клавиатуры на них есть на что посмотреть.
Запустить эмулятор NES
На NEMU можно также запустить символьную версию FCEUX. Измените код в fceux-am/src/config.h, закомментируйте макрос HAS_GUI, и FCEUX будет выводить картинку через putch().
Затем по способу запуска FCEUX из PA1 можно запустить Super Mario на вашем NEMU. Чтобы картинка была лучше, запускайте в терминале не меньше чем на 60 строк. Поскольку клавиатура ещё не реализована, управлять игрой нельзя, но встроенную демонстрацию Super Mario всё же можно посмотреть (на стартовом экране подождите около 10 секунд).
Трассировка доступа к устройствам — dtrace
Подобно mtrace, можно записывать и трассировку доступа к устройствам (device trace) и смотреть, обращается ли программа к устройствам ожидаемым способом.
Реализовать dtrace
Эта функция очень проста; формат вывода dtrace можете задать сами. Заметьте: имя пространства адресов устройства можно взять через map->name — так вывод будет читаемее. Так же можно реализовать условное управление dtrace и сделать его гибче.
Клавиатура
Клавиатура — самое базовое устройство ввода. Обычно она работает так: при нажатии клавиши клавиатура посылает make code этой клавиши; при отпускании — break code этой клавиши. nemu/src/device/keyboard.c симулирует функцию чипа универсального интерфейса устройств i8042. Большая часть функций тоже упрощена, оставлен только интерфейс клавиатуры. При инициализации чипа i8042 регистрируются порт длиной 4 байта в 0x60 и пространство MMIO длиной 4 байта в 0xa0000060; оба отображаются на регистр данных i8042. Когда пользователь нажимает/отпускает клавишу, соответствующий код клавиши кладётся в регистр данных; CPU может прочитать регистр данных и получить код клавиши; если клавиш нет, вернётся AM_KEY_NONE.
В abstract-machine/am/include/amdev.h для функции клавиатуры определён абстрактный регистр:
AM_INPUT_KEYBRD, контроллер клавиатуры AM; можно прочитать информацию о клавише.keydownравноtrueпри нажатии, иначе — отпускание.keycode— код клавиши (break code); если клавиш нет,keycodeравенAM_KEY_NONE.
Реализовать IOE(2)
В abstract-machine/am/src/platform/nemu/ioe/input.c реализуйте функцию AM_INPUT_KEYBRD. После реализации в $ISA-nemu запустите тест readkey test из am-tests. Если реализация верна, в всплывшем при работе программы новом окне нажмите клавишу — программа выведет соответствующую информацию: имя клавиши, код клавиши и состояние нажатия.
Как обнаружить одновременное нажатие нескольких клавиш?
В играх часто нужно знать, нажал ли игрок несколько клавиш сразу: ходьба в восьми направлениях в RPG, комбинации в файтингах и т.д. По свойствам кодов клавиш знаете ли вы, как эти функции реализуют?
Запустить эмулятор NES (2)
Правильно реализовав клавиатуру, на NEMU можно запустить символьную версию эмулятора NES и играть в Super Mario.
VGA
VGA может показывать цветные пиксели и это самое обычное устройство вывода. nemu/src/device/vga.c симулирует функцию VGA. При инициализации VGA регистрирует начиная с 0xa1000000 пространство MMIO, отображённое на video memory (видеопамять, также frame buffer, кадровый буфер). Код симулирует только графический режим 400x300x32: один пиксель занимает 32 бита, R(red), G(green), B(blue), A(alpha) по 8 бит; информацию alpha VGA не использует. Если программирование VGA интересно, здесь проект FreeVGA — там много связанных с VGA материалов.
Волшебная палитра
Современные дисплеи обычно поддерживают 24-битный цвет (R, G, B по 8 бит, всего 2^8*2^8*2^8 — около 16 миллионов цветов). Чтобы экран мог показывать разные цвета, при глубине цвета 8 бит используют понятие палитры. Палитра — массив цветовой информации, каждый элемент занимает 4 байта: значения R(red), G(green), B(blue), A(alpha). С понятием палитры пиксель хранит уже не цвет, а индекс в палитре: конкретно, чтобы получить цвет пикселя, его значение берут как индекс и в массиве палитры делают индексную операцию, доставая соответствующий цвет. Поэтому, используя разные палитры, в разные моменты можно пользоваться разными наборами из 256 цветов.
В некоторых играх 1990-х (например 仙剑奇侠传) многие эффекты появления и исчезновения сделаны через палитру. Знаете ли вы, в чём секрет?
В AM устройство, связанное с отображением, называют GPU: это устройство специально для графического рендеринга. В NEMU полный GPU мы не поддерживаем, оставляем только базовую функцию рисования пикселей.
В abstract-machine/am/include/amdev.h для GPU определены пять абстрактных регистров; в NEMU используются только два:
AM_GPU_CONFIG, информация контроллера дисплея AM; можно прочитать размер экранаwidthиheight. Кроме того, AM предполагает: во время работы системы размер экрана не меняется.AM_GPU_FBDRAW, контроллер кадрового буфера AM; можно записать информацию рисования и в координатах экрана(x, y)нарисовать прямоугольное изображениеw*h. Пиксели изображения хранятся вpixelsв порядке по строкам; каждый пиксель — 32-битное целое в формате цвета00RRGGBB. Еслиsyncравенtrue, содержимое кадрового буфера сразу синхронизируется на экран.
Реализовать IOE(3)
На самом деле у устройства VGA ещё два регистра: регистр размера экрана и регистр синхронизации. В хендаутах мы их не представляли — оставляем как упражнение. Конкретно функция железа (NEMU) регистра размера экрана уже реализована, но ПО (AM) ею ещё не пользуется; у регистра синхронизации наоборот: ПО (AM) уже реализовало синхронизацию экрана, а железо (NEMU) соответствующей поддержки ещё не добавило.
Хорошо, подсказок достаточно; какой код куда добавить — вам RTFSC. Это также хорошее упражнение, чтобы понять, как ПО и железо работают вместе. После реализации добавьте в __am_gpu_init() следующий тестовый код:
--- abstract-machine/am/src/platform/nemu/ioe/gpu.c
+++ abstract-machine/am/src/platform/nemu/ioe/gpu.c
@@ -6,2 +6,8 @@
 void __am_gpu_init() {
+  int i;
+  int w = 0;  // TODO: get the correct width
+  int h = 0;  // TODO: get the correct height
+  uint32_t *fb = (uint32_t *)(uintptr_t)FB_ADDR;
+  for (i = 0; i < w * h; i ++) fb[i] = i;
+  outl(SYNC_ADDR, 1);
 }
В коде выше у w и h ещё не заданы правильные значения; нужно прочитать тест display test в am-tests, понять, как он получает правильный размер экрана, затем поправить w и h в коде выше. Возможно, ещё понадобится изменить код в gpu.c. После правки в $ISA-nemu запустите тест display test из am-tests. Если реализация верна, в новом окне увидите полноэкранную цветовую информацию.
Реализовать IOE(4)
На самом деле только что выведенная цветовая информация — не та картина, которую ожидает display test. Потому что функция AM_GPU_FBDRAW ещё не реализована правильно. Нужно правильно реализовать AM_GPU_FBDRAW. После реализации снова запустите display test. Если реализация верна, в новом окне увидите соответствующую анимацию.
Когда реализация верна, добавленный выше тестовый код можно убрать.
Запустить демонстрационные программы (2)
Правильно реализовав VGA, снова определите HAS_GUI в am-kernels/kernels/demo/include/io.h, и на NEMU можно запускать графические версии демонстраций. После запуска ещё можно клавишей Q выйти из демонстрации.
Запустить эмулятор NES (3)
Правильно реализовав VGA, снова определите HAS_GUI в fceux-am/src/config.h — и на NEMU можно запускать графическую версию FCEUX.
Звуковая карта
Эта часть необязательная
Часть про звуковую карту необязательная и в оценку не входит, но реализовав звуковую карту, в будущем при запуске The Legend of Sword and Fairy можно будет ещё играть звук. Кому интересно — добро пожаловать попробовать.
Настоящая звуковая карта очень сложна; в NEMU мы проектируем простую звуковую карту по API библиотеки SDL. Играть звук через SDL очень просто:
- Через
SDL_OpenAudio()инициализировать аудиоподсистему, задать частоту, формат и т.д., ещё зарегистрировать callback, которым потом будут заполнять аудиоданные. Больше информации —man SDL_OpenAudio(нужно установитьlibsdl2-doc) или эта страница. - Библиотека SDL периодически вызовет зарегистрированный при инициализации callback и даст буфер, попросив callback записать в буфер аудиоданные
- Когда callback вернётся, SDL по параметрам инициализации проиграет аудиоданные из буфера
Звуковая карта не может играть звук сама: ей нужны настройки и аудиоданные от гостевой программы. Программе общаться с устройством, естественно, через I/O, поэтому нужно определить некоторые регистры и пространство MMIO, к которым программа обратится (см. nemu/src/device/audio.c).
- В регистры
freq,channelsиsamplesможно записать соответствующие параметры инициализации - Регистр
initслужит для инициализации: после записи по уже заданнымfreq,channelsиsamplesинициализируют аудиоподсистему SDL - Потоковый буфер
STREAM_BUF— пространство MMIO для аудиоданных от программы; эти данные потом запишут в библиотеку SDL - Регистр
sbuf_sizeпозволяет прочитать размер потокового буфера - Регистр
countпозволяет прочитать, сколько потокового буфера уже занято
Простая звуковая карта NEMU при инициализации регистрирует порт длиной 24 байта в 0x200 и пространство MMIO длиной 24 байта в 0xa0000200; оба отображаются на указанные регистры; кроме того регистрирует начиная с 0xa1200000 пространство MMIO длиной 64KB как потоковый буфер.
В AM в abstract-machine/am/include/amdev.h для звуковой карты определены четыре абстрактных регистра:
AM_AUDIO_CONFIG, информация контроллера звуковой карты AM; можно прочитать флаг наличияpresentи размер потокового буфераbufsize. Кроме того, AM предполагает: во время работы системы размер потокового буфера не меняется.AM_AUDIO_CTRL, регистр управления звуковой картой AM; по записаннымfreq,channelsиsamplesможно инициализировать карту.AM_AUDIO_STATUS, регистр состояния звуковой карты AM; можно прочитать, сколько потокового буфера уже занято,count.AM_AUDIO_PLAY, регистр воспроизведения звуковой карты AM; содержимое интервала[buf.start, buf.end)можно записать в потоковый буфер как аудиоданные. Если свободного места в потоковом буфере меньше, чем аудиоданных, которые сейчас пишут, эта запись будет ждать, пока свободного места не хватит, чтобы полностью записать аудиоданные, и только тогда вернётся.
Реализовать звуковую карту
Как необязательная задача, аппаратная реализация звуковой карты nemu/src/device/audio.c и соответствующая абстракция IOE abstract-machine/am/src/platform/nemu/ioe/audio.c не даны, но audio test в am-tests показывает, как пользоваться абстракцией IOE звуковой карты. Сначала нужно RTFSC и понять, как он играет звук (можно также послушать на native), затем реализовать связанный код NEMU и AM. Если реализация верна, запуск audio test даст услышать мелодию «Звездочки».
Несколько подсказок
Реализовать звуковую карту — в основном два дела:
- Инициализация. Кроме того чтобы понять, как программа через API AM обращается к регистрам железа, ещё нужно написать код инициализации аудиоподсистемы SDL. Даём фрагменты кода; в
......нужно дополнить необходимое, больше деталей — в материалах выше:SDL_AudioSpec s = {}; s.format = AUDIO_S16SYS; // предполагаем, что формат аудиоданных в системе всегда 16-битные знаковые числа s.userdata = NULL; // не используем ...... SDL_InitSubSystem(SDL_INIT_AUDIO); SDL_OpenAudio(&s, NULL); SDL_PauseAudio(0);
::::<!-- > > 2. Maintaining the stream buffer. We can think of the stream buffer as a queue,
where the program writes audio data into the stream buffer through the
AM_AUDIO_PLAYabstraction, and the callback function of the SDL library reads audio data from the stream buffer. So maintaining the stream buffer is actually a data structure assignment, but the special thing about this assignment is that the read and write sides of the queue are located in two different projects (hardware and software), and they can only interact through I/O operations. Additionally, if the amount of data required by the callback function is greater than the amount of data currently in the stream buffer, you need to zero out the remaining part of the buffer provided by SDL to avoid treating some garbage data as audio, which would produce noise.This optional task comprehensively tests skills such as computer abstraction layers, data structures, and RTFM. The reward is making your designed computer system stand out, and it is definitely worth doing. --> 2. Поддерживать потоковый буфер. Потоковый буфер можно считать очередью: программа через абстракцию
AM_AUDIO_PLAYпишет в потоковый буфер аудиоданные, а callback библиотеки SDL читает аудиоданные из потокового буфера. Так что поддерживать потоковый буфер — по сути задание по структурам данных, но особенная деталь: стороны чтения и записи очереди лежат в двух разных проектах (железо и ПО) и общаться могут только операциями I/O. Кроме того, если объём данных, который нужен callback, больше текущего объёма в потоковом буфере, оставшуюся часть буфера, который дал SDL, нужно обнулить, чтобы мусор не считать как аудио и не получить шум.Эта необязательная задача комплексно проверяет слои абстракции компьютера, структуры данных, RTFM и т.д.; награда — сделать спроектированную вами компьютерную систему особенной. Очень стоит попробовать.
Следите за громкостью, берегите уши
Если реализация неверна, программа может выдать белый шум. Обязательно тестируйте на низкой громкости, чтобы не повредить слух.
Принцип воспроизведения звука
Реализовав звуковую карту, можно ещё поиграть. Мы только что упоминали три параметра freq, channels и samples; кроме STFW их смысл можно ощутить на практике: поменяйте эти параметры в audio test и послушайте, чем отличается звук, — так будет более чувственное понимание параметров.
Играть свою музыку
Поскольку звуковая карта — низкоуровневое устройство, напрямую она играет только дискретные выборки звука, то есть формат PCM. Фрагмент «Звездочки» в каркасе как раз в формате PCM. Но PCM занимает довольно много места. Допустим, аудио длительностью 3 минуты, два канала, 44100Hz, выборка каждого канала — 16-битное целое число; тогда хранить это аудио в PCM понадобится
44100 * 2 * 16 / 8 * 3 * 60 = 31752000B = 30.28MB
места.
Поэтому аудио в формате PCM кодируют и сжимают, чтобы экономить место, так появились MP3, OGG и другие форматы. Но эти форматы звуковая карта напрямую не распознаёт. Чтобы их играть, нужно декодировать, восстановить выборки PCM и только потом отдать звуковой карте.
В Linux есть очень мощный инструмент кодирования и декодирования аудио —
ffmpeg, например MP3 можно декодировать так:ffmpeg -i MyMusic.mp3 -acodec pcm_s16le -f s16le -ac 1 -ar 44100 44k.pcmСмысл каждого параметра оставим вам на RTFM.
ffmpegумеет умно распознавать формат входного файла, ещё поддерживает кодирование и декодирование видео, включая обрезку и склейку аудио и видео — очень подходит для любительских задач.
Запустить эмулятор NES (4)
Правильно реализовав звуковую карту, на NEMU можно запускать FCEUX со звуком.
Впрочем, FCEUX нужно ещё декодировать аудио, и частота кадров FCEUX в NEMU из-за этого упадёт. Чтобы сильно не портить игровой опыт, в fceux-am/src/config.h есть несколько опций конфигурации; у звука три настройки: высокое качество (SOUND_HQ), низкое (SOUND_LQ) и без звука (SOUND_NONE). Платформа NEMU по умолчанию выбирает низкое качество, чтобы экономить время декодирования звука FCEUX. По фактическому эффекту запуска конфигурацию можно подстроить, например увеличить число пропускаемых кадров, чтобы экономить время рендеринга FCEUX, ценой меньшей плавности картинки.
Компьютерная система фон Неймана
Показать вашу компьютерную систему
Полностью реализовав IOE, можно ещё запускать крутые программы:
- слайд-шоу (в каталоге
am-kernels/kernels/slider/). Программа каждые 5 секунд переключает картинки из каталогаimages/. - игра в набор текста (в каталоге
am-kernels/kernels/typing-game/). typing - набор демонстраций (в каталоге
am-kernels/kernels/demo/). - змейка (в каталоге
am-kernels/kernels/snake/). - простой эмулятор NES LiteNES (в каталоге
am-kernels/kernels/litenes/). Впрочем, производительность LiteNES невысока: в NEMU лишь около десятка FPS, и запускается только Super Mario. - полный эмулятор NES FCEUX. Верно: эмулятор NES, который мы представляли в PA1, теперь тоже может работать в NEMU!
Эти игры внешне сильно различаются, но за ними один каркас «как программа через IOE делает игровой эффект». На самом деле игру можно абстрагировать в бесконечный цикл:
while (1) {
  ждать_новый_кадр();  // AM_TIMER_UPTIME
  обработать_клавиши();  // AM_INPUT_KEYBRD
  обновить_логику_игры();  // TRM
  нарисовать_новый_экран();  // AM_GPU_FBDRAW
}
Когда компьютеру добавили IOE, функции тела цикла полностью можно опереть на абстракцию AM, поэтому запускать эти крутые игры в NEMU вовсе не невозможно. Даже бесконечные циклы только что запущенных тестов am-tests можно считать упрощёнными играми. Сложная игра The Legend of Sword and Fairy, которую вы запустите в PA3, за кулисами тоже такой бесконечный цикл.
Как работают игры
Возьмите игру в набор текста как пример и, сочетая два взгляда на «как программа работает на компьютере», разберите, как именно эта игра работает на компьютере. Конкретно: когда вы нажимаете букву и попадаете, как вся компьютерная система (NEMU, ISA, AM, среда выполнения, программа) работает вместе, чтобы игра реализовала игровой эффект «попадание»?
У игры в набор текста меньше 200 строк простого кода — очень подходит для RTFSC. Если конкретное поведение игры понять трудно, стоит себе прозвонить тревогу: делая PA, вы, скорее всего, заботились только о том, как правильно написать обязательный код, и не думали о связи этого кода с компьютерной системой. С точки зрения ICS и PA такой подход — незачёт, и скоро это аукнется.
Наблюдать, как работает программа
RTFSC — понять работу программы со статического взгляда; на самом деле можно ещё с динамического: сначала наблюдать поведение в момент выполнения и смотреть, что программа на самом деле делает. Именно в этом роль trace! Мы просим реализовать в NEMU разные инструменты trace как раз чтобы с разных слоёв наблюдать поведение программы в момент выполнения — это тоже совпадает с конечной целью PA «понять, как программы работают на компьютере».
Попробуйте включить в NEMU все инструменты trace, затем запустите игру в набор текста: увидите, что ftrace и dtrace очень помогают ответить на обязательный вопрос выше.
Ощутили пользу AM?
Слышно, что большой проект лабораторной по цифровым схемам в этом семестре можно выбрать как дизайн однотактного CPU. Теперь AM-приложений так много, и главное — их удобно переносить на любую архитектуру: на спроектированном вами CPU запустить классику вроде Super Mario и Street Fighter — демонстрация взлетит до небес!
AM рождён для учебных лабораторных. Раз так — чего вы ждёте?
Путеводитель RTFSC
Здесь перечислим код, который к этому моменту уже стоит прочитать и понять, — для самопроверки:
- весь уже имеющийся код NEMU (включая Makefile), кроме
fixdep,kconfigи невыбранных ISA - связанный с $ISA-nemu код в
abstract-machine/am/, кроме CTE и VME - весь код в
abstract-machine/klib/ - весь код в
abstract-machine/Makefileиabstract-machine/scripts/ - весь код в
am-kernels/tests/cpu-tests/ - тестовый код из
am-kernels/tests/am-tests/, который вы запускали am-kernels/benchmarks/microbench/bench.c- весь код
hello,sliderиtyping-gameвam-kernels/kernels/
Если поведение какого-то кода понять не можете — скорее смотрите и разбирайтесь. На каждый файл который вы читаете, вы уменьшаете дни исправления багов; в PA3 это ощутите.
Как работает LiteNES?
Ещё один проект, который стоит RTFSC, — LiteNES; кроме встроенного rom код всего около 1500 строк. Главное: в этом изящном проекте уже полная компьютерная система: CPU, память, MMIO и три периферии — геймпад (psg), картридж (mmc) и графический процессор (ppu). Кроме внутренних деталей реализации ppu остальное вы уже в силах понять.
Интересно, что LiteNES можно считать сплавом NEMU и программы AM. Попробуйте прочитать код LiteNES и понять: как LiteNES как полная компьютерная система даёт этим частям взаимодействовать, и как LiteNES как программа AM через API AM реализует игровой эффект. Даём материалы по процессору 6502 (CPU NES) и NES PPU (графический процессор) для справки.
Оптимизировать LiteNES
В LiteNES по умолчанию включён режим пропуска кадров: рендерится только 1/2 кадров. Хотя на native можно выжать 60 FPS, даже с пропуском кадров в NEMU лишь около десятка FPS.
Производительность NEMU правда невысока, но LiteNES тоже не без греха: в коде ещё очень много места для оптимизации. У нас есть жестоко оптимизированный LiteNES: на x86-nemu с оценкой microbench 236 он тоже держит 60 FPS, на riscv32-nemu с оценкой 400 даже до 100 FPS!
Чтобы по возможности скрыть различие производительности настоящей машины и NEMU, вместе с FPS можно записать и оценку microbench, затем считать показатель FPS/оценка, измеряя FPS на единицу вычислительной силы — так примерно отражается производительность самого LiteNES. Например, наша жестоко оптимизированная версия на x86-nemu даёт 60/236 = 0.2542; на riscv32-nemu — 100/400 = 0.2500, результаты довольно согласованы.
Если обязательное уже сделано и делать нечего, можно попробовать оптимизировать код LiteNES и посоревноваться с товарищами в производительности после оптимизации! Впрочем, как вы собираетесь оптимизировать?
Запустить NEMU на NEMU
Звучит слегка безумно, но если подумать — почему бы и нет: NEMU сам тоже программа. В каталоге am-kernels/kernels/nemu/ уже подготовлен Makefile; в этом каталоге можно выполнить:
make ARCH=$ISA-nemu mainargs=/home/user/ics2023/am-kernels/kernels/hello/build/hello-$ISA-nemu.bin
Он сделает следующее:
- сохранит текущие опции конфигурации NEMU
- загрузит новый файл конфигурации, скомпилирует NEMU на AM и возьмёт bin-файл, указанный
mainargs, как образ этого NEMU - восстановит опции, сохранённые на шаге 1
- снова скомпилирует NEMU и запустит, взяв NEMU с шага 2 как файл образа
На шаге 2, когда NEMU компилируют на AM, система конфигурации определит макрос CONFIG_TARGET_AM; поведение NEMU тогда изменится:
- отладочные функции вроде sdb, DiffTest больше не включаются, потому что AM не даёт нужных библиотечных функций (чтение/запись файлов, динамическая линковка, регулярные выражения и т.д.)
- устройства NEMU реализуют через AM IOE
Подумайте: если на внутреннем NEMU (то есть NEMU, скомпилированном на AM) запустить игру в набор текста:
make ARCH=$ISA-nemu mainargs=путь/к/игре-в-набор-текста
какой путь тогда проходит игра, чтобы прочитать клавиши / обновить экран?
На самом деле мы уже реализовали компьютерную систему фон Неймана! На вводном курсе вы учили: компьютерная система фон Неймана состоит из пяти частей: ALU (арифметико-логическое устройство), устройство управления, память, устройство ввода и устройство вывода. Эти на слух туманные имена теперь уже «на коде»: вы все их реализовали в NEMU! Оглянемся на эту и простую, и сложную компьютерную систему: проста она потому, что всего лишь добавила IOE поверх TRM, по сути всё ещё работает как «выборка→декодирование→выполнение», и даже с некоторыми знаниями цифровых схем уже можно понять, что компьютер собрать возможно; NEMU сложна — потому что уже достаточно мощна, чтобы держать столько крутых программ, и это правда радует! Вещи, что кажутся простыми, но отражают бесконечные возможности, несут прекрасные закономерности, которыми легко опьянеть и перед которыми легко склониться. Компьютер — одна из них.
Обязательные вопросы
В лабораторном отчёте своими словами, как можно подробнее, ответьте на следующие вопросы.
- Программа — конечный автомат Понять процесс выполнения YEMU, конкретно см. здесь.
- RTFSC Систематизируйте процесс выполнения одной инструкции в NEMU, конкретно см. здесь.
- Как работает программа Понять, как работает игра в набор текста, конкретно см. здесь.
- Компиляция и линковка В
nemu/include/cpu/ifetch.hувидите функциюinst_fetch(), определённую сstatic inline. Попробуйте отдельно убратьstatic, убратьinlineили убрать оба, затем снова скомпилировать — возможно, увидите ошибку. Объясните, почему эти ошибки происходят / не происходят. Есть ли способ доказать вашу мысль? - Компиляция и линковка
- В
nemu/include/common.hдобавьте строкуvolatile static int dummy;и перекомпилируйте NEMU. Сколько экземпляров переменнойdummyсодержит перекомпилированный NEMU? Как вы получили этот результат? - Добавив код предыдущего пункта, в
nemu/include/debug.hещё добавьте строкуvolatile static int dummy;и перекомпилируйте NEMU. Сколько экземпляров переменнойdummyтеперь в NEMU? Сравните с числом экземпляровdummyв предыдущем пункте и объясните результат этого пункта. - Измените добавленный код, инициализировав оба
dummy:volatile static int dummy = 0;и перекомпилируйте NEMU. Какую проблему вы обнаружили? Почему раньше такой проблемы не было? (Ответив, добавленный код можно удалить.)
- В
- Понять Makefile Опишите: после того как в каталоге
am-kernels/kernels/hello/вы ввелиmake ARCH=$ISA-nemu, как программаmakeорганизует файлы .c и .h и в итоге порождает исполняемый файлam-kernels/kernels/hello/build/hello-$ISA-nemu.elf. (В вопросе две стороны: как работаетMakefileи процесс компиляции и линковки.) Подсказки про работуMakefile:- в
Makefileиспользуются переменные, включение файлов и т.д. Makefileприменяет и переопределяет некоторые implicit rules- поиск опции
-nвman makeможет помочь - RTFM
- в
Напоминание
На этом PA2 заканчивается. Напишите лабораторный отчёт (не забудьте ответить в нём на обязательные вопросы), затем поместите файл отчёта с именем student_id.pdf в каталог проекта и выполните make submit, чтобы сдать проект на указанный сайт.