
Открывающая глава
Первопроходец хотел создать мир компьютеров и дал ему миссию выполнять программы. Давайте поможем ему и испытаем радость творения.
Как вы знаете из курсов программирования, программа состоит из кода и данных. Например, программу, чтобы найти 1+2+... +100, вы можете написать без особых усилий. Легко понять, что данные — то, с чем программа имеет дело, а код описывает, что программа хочет делать с данными. Не говоря уже о сложных играх, как выглядел бы простейший компьютер, чтобы выполнить даже самую простую программу?
Простейший компьютер
Чтобы выполнить программу, первая проблема — куда её положить. Очевидно, мы не хотим создать компьютер, который может выполнять только маленькие программы. Поэтому нужен достаточно большой компонент, чтобы вместить самые разные программы, и этот компонент — память. Итак, первопроходцы создали память и положили программы в память, ожидая, пока CPU их выполнит.
Подождите, кто такой CPU? Вы, вероятно, слышали о нём раньше, но давайте представим его заново. CPU — величайшее творение первопроходцев, и его китайское имя "中央处理器" (Centrally Processing Unit) показывает, что ему оказана высшая честь: CPU — ядро схем, отвечающее за обработку данных, то есть выполнение программы целиком зависит от него. Но компьютер только с памятью не может считать. Естественно, CPU пришлось взять на себя задачу вычислений, и первопроходцы создали ALU (арифметико-логическое устройство) для CPU, чтобы данные можно было обрабатывать разными способами. Если ALU слишком сложен, рассмотрите сумматор как пример.
Первопроходец обнаружил, что иногда программе нужно непрерывно обрабатывать одни и те же данные. Например, чтобы вычислить 1+2+... +100, нужно складывать число и sum, и неудобно каждый раз после сложения записывать это обратно в память, а потом снова читать из памяти, чтобы продолжить сложение. В то же время бесплатного обеда не бывает: за большую ёмкость памяти нужно платить соответствующую цену, то есть медленность, и это закон свойств материалов, который первопроходец не может нарушить. Поэтому первопроходцы создали регистры для CPU, позволяя CPU временно хранить в них обрабатываемые данные.
Регистры быстрые, но маленькие, и дополняют свойства памяти, так что между ними, возможно, сплетётся новая история, но пока пойдём по течению.
Может ли компьютер быть без регистров? (Предлагается подумать на втором проходе)
Может ли компьютер работать без регистров? И если да, как это влияет на модель программирования, которую даёт железо?
Даже если вы думаете об этом на втором проходе, возможно, концепцию «модели программирования» вы слышите впервые. Но если вы внимательно читали руководство ISA на первом проходе, вы помните, что такое понятие есть. Так что если хотите знать, что такое модель программирования, RTFM.
Чтобы сделать могучий CPU верным слугой, первопроходцы также спроектировали «инструкции», которые указывали CPU, что делать с данными. Так мы можем управлять CPU через инструкции и заставлять его делать то, что хотим.
С инструкциями Первопроходец придумал эпохальную идею: можем ли мы дать программе автоматически управлять выполнением компьютера? Чтобы это осуществить, первопроходцы и CPU заключили простое соглашение: после выполнения инструкции продолжать выполнять следующую. Но как CPU знает, какая инструкция выполнена? Поэтому первопроходцы создали для CPU специальный счётчик под названием "Program Counter" (PC). В x86 у него особое имя — EIP (Extended Instruction Pointer).
С этих пор компьютеру нужно делать только одно:
while (1) {
  извлечь инструкцию из позиции памяти, указанной PC;
  Выполнить инструкцию;
  обновить PC;
}
Так у нас достаточно простой компьютер. Нужно лишь поместить последовательность инструкций в память и дать PC указать на первую инструкцию, и компьютер автоматически будет выполнять эту последовательность инструкций, никогда не останавливаясь.
Например, следующая последовательность инструкций вычисляет 1+2+... +100, где r1 и r2 — два регистра, и есть неявный счётчик программы PC с начальным значением 0. Чтобы помочь понять, мы перевели семантику инструкций в код C справа, где перед каждой строкой C стоит метка оператора
// PC: инструкция     | // метка: оператор
0: mov  r1, 0         |  pc0: r1 = 0;
1: mov  r2, 0         |  pc1: r2 = 0;
2: addi r2, r2, 1     |  pc2: r2 = r2 + 1;
3: add  r1, r1, r2    |  pc3: r1 = r1 + r2;
4: blt  r2, 100, 2    |  pc4: if (r2 < 100) goto pc2;   // переход если меньше
5: jmp 5              |  pc5: goto pc5;
Компьютер выполняет последовательность инструкций выше, и последняя инструкция при PC=5 находится в мёртвом цикле; в этот момент вычисление закончено, и результат 1+2+... Результат 1+2+... +100 хранится в регистре r1.
Попытаться понять, как компьютеры считают
До примера выше вы могли думать, что инструкции — таинственное и трудное понятие. Но когда смотрите на соответствующий код C, понимаете, что инструкции делают что-то настолько простое! Это ещё и немного глупо: вы запросто сможете написать цикл for, который выглядит продвинутее этого С кода.
Но поставьте себя на место компьютера, и вы увидите, как компьютеру возможно вычислить 1+2+... + 100. Это понимание даст вам первоначальное представление о том, как программа работает на компьютере.
Этот полностью автоматический процесс прекрасен! На самом деле Тьюринг, первопроходец, уже сформулировал похожую стержневую идею в 1936, что делает его «отцом компьютера». Стержневая идея, дошедшая до наших дней, — «хранимая программа». В честь Тьюринга мы называем простейший компьютер выше «машиной Тьюринга» (TRM). Возможно, вы уже слышали о понятии «машина Тьюринга» как модели вычислений, но здесь мы подчеркнём только условия, которым должен удовлетворять простейший реальный компьютер:
- структурно у TRM есть память, PC, регистры и сумматоры
- по способу работы TRM снова и снова повторяет следующий процесс: берёт инструкцию из позиции памяти, указанной PC, выполняет инструкцию, затем обновляет PC.
А? Память, счётчики, регистры, сумматоры — разве это не те же части, которые вы изучали на курсе цифровых схем? Вам может быть трудно поверить, но компьютер, на который вы смотрите, компьютер, который умеет всё, сделан из цифровых схем! Но программы, которые мы писали на курсе программирования, были на C. если компьютер и правда гигантская цифровая схема, которая понимает только нули и единицы, как эта холодная схема может понять код C — плод человеческой изобретательности? Первопроходец сказал, что в ранние годы компьютеров языка C не было, и все писали машинные инструкции, тёмные и трудные для людей, и это был самый ранний способ программировать компьютер, который он видел. Позже люди изобрели языки высокого уровня и компиляторы, которые берут код на языке высокого уровня и обрабатывают его разными способами, и наконец порождают функционально эквивалентные инструкции, которые CPU понимает. Когда CPU выполняет эти инструкции, он выполняет код, который мы написали. Сегодняшние компьютеры по сути всё ещё «хранимые программы», естественно тупой способ работы, и только усилиями бесчисленных учёных-информатиков мы сегодня можем легко пользоваться компьютерами.
Компьютер — конечный автомат.
Поскольку компьютер — сборка логических схем, мы можем разделить компьютер на две части: одна состоит из всех компонентов последовательной логики (память, счётчики, регистры), другая — из оставшихся компонентов комбинационной логики (например, сумматоров и т.д.). Так мы можем понять процесс компьютера с точки зрения модели конечного автомата: на каждом такте компьютер вычисляет и переходит в новое состояние следующего такта на основе текущего состояния компонентов временной логики и действия компонентов комбинационной логики.
В чём смысл этого взгляда на компьютер? Похоже, он мало что даёт, кроме осознания, что компьютерное железо не так уж таинственно. В конце концов, занятия ICS не требуют реализовывать компьютерное железо на языке описания аппаратуры, нужно лишь верить, что это можно сделать.
Но для программ эта перспектива может быть полезнее, чем вы думаете.
Переосмысление программ: программа — конечный автомат
Если мыслить, что компьютер это конечный автомат, что такое программа, которая на нём работает?
Мы знаем, что программы состоят из инструкций, так что посмотрим, что такое инструкция в модели конечного автомата. Легко понять, что компьютер меняет своё состояние, выполняя инструкции: например, выполняет инструкцию сложения, которая складывает значения двух регистров и обновляет результат в третьем; или выполняет инструкцию перехода, которая изменяет значение PC, так что компьютер начинает выполнять новую инструкцию с позиции нового PC. Так что в модели конечного автомата инструкцию можно рассматривать как входной стимул для компьютера, чтобы выполнить переход состояния.
Очень простой компьютер описан в разделе 1.1.3 учебника ICS. У этого компьютера четыре 8-битных регистра, 4-битный PC и 16 байт памяти, так что общее число бит, которые может представлять этот компьютер, — B = 4*8 + 4 + 16*8 = 164, и поэтому компьютер может иметь всего N = 2^B = 2^164 разных состояний. Предполагая, что поведение всех инструкций в этом компьютере определено, для любого из N состояний новое состояние после перехода также однозначно определено. Вообще N очень велико, и следующий рисунок показывает диаграмму переходов состояний для компьютера с N=50.
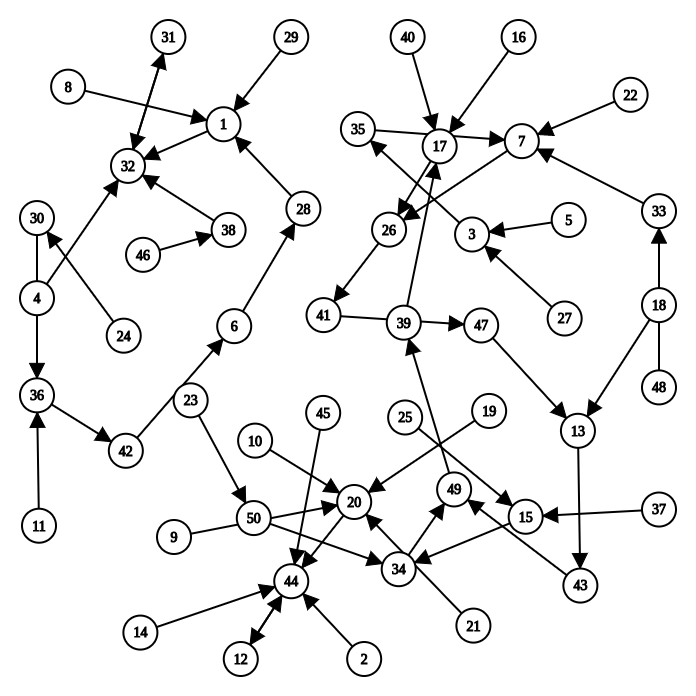
Теперь мы можем объяснить природу «работы программы на компьютере» через перспективу конечного автомата: данную программу положить в память компьютера — всё равно что задать начальное состояние на диаграмме переходов с числом состояний N, с которого программа работает, с определённым переходом состояния в конце каждой инструкции. Другими словами, программу можно рассматривать как конечный автомат! Этот конечный автомат — подмножество большого конечного автомата (N), упомянутого выше.
Например, предположим, программа работает в компьютере, показанном на рисунке выше, и её начальное состояние — состояние 8 в верхнем левом углу, тогда соответствующий конечный автомат этой программы —
8->1->32->31->32->31->...
Эта программа могла бы быть:
// PC: инструкция     | // метка: оператор
0: addi r1, r2, 2     |  pc0: r1 = r2 + 2;
1: subi r2, r1, 1     |  pc1: r2 = r1 - 1;
2: nop                |  pc2: ;  // нет операции
3: jmp 2              |  pc3: goto pc2;
Понять работу программы с точки зрения конечного автомата
Как пример, попробуйте нарисовать конечный автомат программы в предыдущем подразделе 1+2+... +100 последовательность инструкций в предыдущем подразделе как пример, попробуйте нарисовать конечный автомат этой программы.
Программа относительно простая, и единственное состояние, которое нужно обновлять, — PC и два регистра r1 и r2, так что все состояния программы можно представить тройкой (PC, r1, r2), не рисуя точное состояние памяти. Начальное состояние — (0, x, x), где x значит неинициализировано. Инструкция при PC=0 — mov r1, 0, после чего PC указывает на следующую инструкцию, так что следующее состояние — (1, 0, x). По аналогии можно набросать процесс перехода состояний для первых 3 инструкций:
(0, x, x) -> (1, 0, x) -> (2, 0, 0) -> (3, 0, 1)
Попробуйте дорисовать конечный автомат. Для цикла в программе нужно нарисовать только первые 2 и последние 2 итерации.
С примером обязательного вопроса выше у вас должно быть лучшее понимание того, как программа работает на компьютере. На одну и ту же программу можно смотреть с двух взаимодополняющих перспектив.
Статический взгляд на код (или последовательности инструкций), часто называемый «писать программу»/«смотреть код», на самом деле статический взгляд. Одно из достоинств этой перспективы — компактное описание, и сочетание ветвлений, циклов и вызовов функций позволяет достичь сложной функциональности малым количеством кода. Но это также может затруднить понимание поведения программы.
Другой — динамический взгляд на переходы состояний конечного автомата как эффект работы, который напрямую изображает природу «программы, работающей на компьютере». Однако число состояний в этой перспективе очень велико, и все циклы и вызовы функций в коде программы полностью развёрнуты на гранулярности инструкций, из-за чего трудно ухватить общую семантику программы. Не смотря на это, перспектива конечного автомата даёт ясное понимание деталей локального поведения программы, особенно поведения, которое трудно понять со статической точки зрения.
Каковы преимущества перспективы конечного автомата для программы?
Некоторые программы могут выглядеть просто, но их поведение менее интуитивно, например рекурсия. Чтобы хорошо понять, как рекурсивная программа работает на компьютере, эффективнее всего смотреть на поведение программы с точки зрения конечного автомата: это помогает понять, как каждая инструкция изменяет состояние компьютера и тем самым семантику рекурсии на макроуровне. Глава 3 теоретического курса ICS посвящена этим деталям, так что конкретное поведение рекурсии здесь разбирать не будем.
Микроскопический взгляд на «программы, работающие на компьютерах»: программа как конечный автомат
Перспектива «программа как конечный автомат» важна и для ICS, и для PA, потому что «понять, как программы работают на компьютерах» — фундаментальная цель и ICS, и PA. Макровзгляд на эту проблему будет введён в середине PA.
Текст этого подраздела должен быть вам понятен, но если в будущем вы не выработаете привычку понимать поведение программы с точки зрения конечного автомата, PA может показаться очень трудным, потому что в PA вы постоянно будете иметь дело с кодом. Если вы не можете понять поведение какого-то ключевого кода с микроперспективы, вы не сможете полностью понять, как программа работает, с макроперспективы.