Программы, среда выполнения и абстрактная машина (AM)
Среда выполнения
Чтобы NEMU поддерживал выполнение большей части программ, вы уже реализовали немало инструкций. Но не из-за одних инструкций заработают ещё программы. Раньше мы говорили: «не всякая программа может работать в NEMU» — сейчас объясним, почему.
Интуитивно: дать TRM, который умеет только «считать», поддерживать полноценную ОС всё же нереалистично. Ощущение такое, что у компьютеров тоже есть «сила функций»: чем компьютер «мощнее», тем сложнее программы он может гонять. Иначе говоря, выполнение программы предъявляет требования к функциям компьютера. Когда вы запускаете Hello World, вводите команду (или кликаете мышью) — программа успешно работает, но за этим скрыт бесконечный пот разработчиков ОС и библиотек. Факт: выполнение приложений нуждается в поддержке среды выполнения (runtime): загрузка, уничтожение программы, динамические библиотеки во время работы (библиотечные функции, которыми вы часто пользуетесь, как раз даёт среда выполнения) и т.д. Чтобы гостевые программы работали в NEMU, теперь ваша очередь дать соответствующую поддержку среды выполнения.
По правилу KISS сначала рассмотрим, какой бывает самая простая среда выполнения. Иначе говоря, что нужно дать, чтобы работала самая простая программа? Ответ уже был в PA1: достаточно положить программу в правильное место памяти, дать PC указать на первую инструкцию — и компьютер сам будет выполнять программу, никогда не останавливаясь.
Однако хотя компьютер может бесконечно выполнять инструкции, обычные программы заканчиваются, поэтому среда выполнения должна дать программе способ завершиться. Догадливый читатель уже вспомнит искусственно добавленную в PA1 инструкцию nemu_trap — как раз чтобы программа могла закончить выполнение.
Итак, если есть память, способ завершить выполнение и верно реализованные инструкции, можно поддержать работу самых простых программ. И это тоже можно считать самой простой средой выполнения.
Упаковать среду выполнения в библиотечные функции
Среда выполнения, о которой только что говорили, лежит прямо на железе компьютера, поэтому и её реализация связана с архитектурой. Архитектуру обозначаем парой «ISA-платформа», например mips32-nemu. Возьмём завершение программы: в NEMU это особая инструкция nemu_trap, и формат nemu_trap у разных ISA наверняка разный; а если сами на verilog спроектируем CPU riscv32, архитектура riscv32-mycpu может завершать программу инструкцией mycpu_trap, и она может отличаться от nemu_trap. Завершение — общая потребность программ. Чтобы n программ работали на m архитектурах, неужели поддерживать n*m копий кода? Есть ли способ лучше?
Для одной программы, если m разных частей разных версий превратить в один и тот же код, достаточно сопровождать одну версию. Козырь для этой цели — абстракция, которую вы учили на курсе программирования! Достаточно определить API завершения, например void halt(), который абстрагирует разные способы завершения на разных архитектурах: программе достаточно вызвать halt(), не заботясь, на какой архитектуре она работает. После абстракции прежние m версий программы все завершаются через halt(), и сопровождать нужно только эту одну версию, завершающуюся через halt(). Затем разные архитектуры реализуют свой halt() — и можно поддержать n программ! Так программу и архитектуру развязываем: сопровождаем n+m копий кода (n программ и m связанных с архитектурой halt()), а не прежние n*m.
Этот пример также показывает обычный способ существования среды выполнения: библиотека. Через библиотеку общие элементы, нужные для работы программы, абстрагируются в API; разным архитектурам достаточно реализовать эти API — и среда выполнения, поддерживающая программы, уже есть. Это повышает эффективность разработки программ: когда нужно, вызываете API — и пользуетесь соответствующей функцией среды выполнения.
И что с того?
Подумайте: какие ещё выгоды даёт такая абстракция? Эти выгоды вы скоро ощутите.
AM — среда выполнения на голом железе (bare-metal)
С одной стороны, как сказано выше, выполнение приложений нуждается в поддержке среды выполнения; с другой — программы с чисто вычислительными задачами могут работать уже на TRM. У более сложных приложений к среде выполнения наверняка есть и другие требования: например, Super Mario, в которую вы играли, нужно взаимодействовать с пользователем — среде выполнения как минимум нужна поддержка ввода-вывода. Чтобы запустить современную ОС, поверх этого нужны ещё более продвинутые возможности.
Если собрать эти потребности и абстрагировать их в единый API для программ, получится библиотека, которая может поддерживать разные программы на разных архитектурах! Конкретно каждая архитектура реализует этот набор API по своим свойствам; приложению достаточно вызывать этот набор API, не заботясь, на какой архитектуре оно потом будет работать. Поскольку этот единый абстрактный API выражает потребности программы к компьютеру, мы называем этот набор API абстрактным компьютером.
Так родился проект AM (Abstract machine). Как библиотека, дающая программам среду выполнения, AM по потребностям программ делит библиотеку на модули:
AM = TRM + IOE + CTE + VME + MPE
- TRM (Turing Machine) — машина Тьюринга, самая простая среда выполнения, даёт программе базовую способность считать
- IOE (I/O Extension) — расширение ввода-вывода, даёт программе способность ввода и вывода
- CTE (Context Extension) — расширение контекста, даёт программе способность управлять контекстом
- VME (Virtual Memory Extension) — расширение виртуальной памяти, даёт программе способность управлять виртуальной памятью
- MPE (Multi-Processor Extension) — расширение многопроцессорности, даёт программе способность общаться между процессорами (MPE за рамками ICS, в PA не будет)
AM показывает отношение программы и компьютера: функциями компьютерного железа реализовать AM и дать программам нужную среду выполнения. Благодаря рождению AM граница между NEMU и программами стала чётче, а процесс PA — яснее:
(в NEMU) реализовать функции железа -> (в AM) дать среду выполнения -> (на слое приложения) запустить программу
(в NEMU) реализовать более мощные функции железа -> (в AM) дать более богатую среду выполнения -> (на слое приложения) запустить более сложную программу
Этот процесс перекликается с историей сотворения в PA1: Первопроходец хотел создать мир компьютеров и дать ему миссию выполнять программы. Самому построить мост между NEMU (железо) и AM (ПО), чтобы поддержать работу программ, — лучший выбор для конечной цели «понять, как программы работают на компьютере».
Рождение AM и история Project-N
До рождения AM главные части Project-N уже существовали:
- NEMU - NJU EMUlator (лабораторная по основам систем)
- Nanos - Nanjing U OS (лабораторная по ОС)
- NOOP - NJU Out-of-Order Processor (лабораторная по организации компьютера)
- NCC - NJU C Compiler (лабораторная по компиляторам)
Но мы всё не придумывали, как собрать эти части в полную учебную экосистему.
Весной 2017 на комплексном лабораторном курсе компьютерных систем jyy первым предложил идею AM — развязать программу и архитектуру. После развязки AM стала ключом Project-N: стоит реализовать AM — и разные программы AM можно запускать на NEMU и NOOP; стоит реализовать Nanos на AM — и Nanos можно запускать на NEMU и NOOP; стоит NCC скомпилировать программу на AM — и программу, скомпилированную NCC, можно запускать на NOOP.
После нескольких месяцев попыток мы быстро поверили: путь верный. Тогда срочно решили осенью 2017 сильно переделать PA и проектировать NEMU, опираясь на идеи AM, чтобы лучше понять «как программы работают на компьютере». Поэтому осенняя версия NEMU 2017 впервые официально вошла в учебную экосистему Project-N как подпроект.
Мы уже два года подряд собирали команду на конкурс проектирования компьютерных систем «Кубок Loongson»: показывали нашу уникальную экосистему Project-N и оба раза брали второе место. Хорошие методы, найденные на конкурсе, тоже возвращаются в PA. Это от вас не так далеко: методы и принципы, которые мы передаём в PA, — золотой опыт призов того конкурса.
Если AM и Project-N интересны, пишите jyy или yzh.
Узы сквозь время и пространство
С AM можно связать лабораторные разных курсов и делать интересное, чего раньше нельзя было: например, этой весной на курсе ОС ваши старшие писали свои маленькие игры на AM. В поздней части PA в этом году у вас будет шанс бесшовно перенести игры старших на NEMU как часть финальной демонстрации системы — даже думать об этом уже волнующе.
Зачем AM? (Предлагается подумать на втором проходе)
У операционной системы тоже своя среда выполнения. Чем среда выполнения AM отличается от среды, которую даёт ОС? Почему эти отличия есть?
RTFSC(3)
Подпроект AM abstract-machine вы уже получили в конце PA0; кратко представим код проекта AM. Исходные файлы в каталоге abstract-machine/ организованы так (файлы в части каталогов не перечислены):
abstract-machine
├── am                                  # связанное с AM
│   ├── include
│   │   ├── amdev.h
│   │   ├── am.h
│   │   └── arch                        # определения заголовков, связанные с архитектурой
│   ├── Makefile
│   └── src
│       ├── mips
│       │   ├── mips32.h
│       │   └── nemu                    # реализация, связанная с mips32-nemu
│       ├── native
│       ├── platform
│       │   └── nemu                    # реализация AM с платформой NEMU
│       │       ├── include
│       │       │   └── nemu.h
│       │       ├── ioe                 # IOE
│       │       │   ├── audio.c
│       │       │   ├── disk.c
│       │       │   ├── gpu.c
│       │       │   ├── input.c
│       │       │   ├── ioe.c
│       │       │   └── timer.c
│       │       ├── mpe.c               # MPE, сейчас пусто
│       │       └── trm.c               # TRM
│       ├── riscv
│       │   ├── nemu                    # реализация, связанная с riscv32(64)
│       │   │   ├── cte.c               # CTE
│       │   │   ├── start.S             # вход в программу
│       │   │   ├── trap.S
│       │   │   └── vme.c               # VME
│       │   └── riscv.h
│       └── x86
│           ├── nemu                    # реализация, связанная с x86-nemu
│           └── x86.h
├── klib                                # библиотека часто используемых функций
├── Makefile                            # общие правила Makefile
└── scripts                             # Makefile сборки/запуска двоичных файлов/образов
    ├── isa
    │   ├── mips32.mk
    │   ├── riscv32.mk
    │   ├── riscv64.mk
    │   └── x86.mk
    ├── linker.ld                       # скрипт линковки
    ├── mips32-nemu.mk
    ├── native.mk
    ├── platform
    │   └── nemu.mk
    ├── riscv32-nemu.mk
    ├── riscv64-nemu.mk
    └── x86-nemu.mk
Весь проект AM делится на две большие части:
abstract-machine/am/— реализации AM API разных архитектур; сейчас достаточно смотреть связанное с NEMU. Кроме того,abstract-machine/am/include/am.hперечисляет все API в AM, их представим по очереди позже.abstract-machine/klib/— некоторые библиотечные функции, не зависящие от архитектуры, для удобства разработки приложений
Прочитав код в abstract-machine/am/src/platform/nemu/trm.c, увидите: чтобы программа работала на TRM, достаточно реализовать очень мало API:
- структура
Area heapуказывает начало и конец области кучи void putch(char ch)выводит один символvoid halt(int code)завершает выполнение программыvoid _trm_init()делает инициализацию, связанную с TRM
Куча — участок памяти, которым программа может свободно пользоваться, даёт динамическое выделение памяти. API TRM даёт только начало и конец кучи; выделение и управление кучей программа ведёт сама. Разумеется, программу можно и без кучи, например dummy. Сделать putch() API TRM — занятное решение, обсудим в ближайшем будущем; пока программы, которым нужен putch(), запускать не собираемся.
Наконец посмотрим на halt(). Внутри halt() вызывается макрос nemu_trap() (определён в abstract-machine/am/src/platform/nemu/include/nemu.h); после раскрытия это оператор встроенного ассемблера. Встроенный ассемблер позволяет вставлять операторы ассемблера в код C. На примере riscv32 после макроподстановки получится:
asm volatile("mv a0, %0; ebreak" : :"r"(code));
Очевидно, определение макроса связано с ISA; если посмотреть nemu/src/isa/$ISA/inst.c, увидите: эта инструкция и есть та особая nemu_trap! Макрос nemu_trap() ещё перенесёт код завершения в регистр общего назначения, так что эта сборка соответствует поведению nemu_trap в nemu/src/isa/$ISA/inst.c: значение регистра передадут как параметр в set_nemu_state(), код завершения из halt() установят в monitor NEMU, и monitor по коду сообщит причину окончания программы. Кроме того, volatile — ключевое слово C; если хотите узнать о volatile больше, сверьтесь с материалами.
Подпроект am-kernels собирает тестовые наборы и простые программы, которые можно запускать на AM:
am-kernels
├── benchmarks                  # бенчмарки для оценки производительности
│   ├── coremark
│   ├── dhrystone
│   └── microbench
├── kernels                     # приложения, которые можно показать
│   ├── hello
│   ├── litenes                 # простой эмулятор NES
│   ├── nemu                    # NEMU
│   ├── slider                  # простой просмотрщик картинок
│   ├── thread-os               # ОС с потоками ядра
│   └── typing-game             # игра на набор текста
└── tests                       # целевые тестовые наборы
    ├── am-tests                # тесты реализации AM API
    └── cpu-tests               # тесты реализации инструкций CPU
Прежде чем NEMU запустит гостевую программу, её код нужно скомпилировать в исполняемый файл. Важно: нельзя компилировать опциями gcc по умолчанию, потому что по умолчанию код соберут в исполняемый файл под GNU/Linux, под среду выполнения GNU/Linux. Но сейчас NEMU не даёт гостевой программе среду GNU/Linux, такой исполняемый файл в NEMU корректно не запустится, поэтому пользовательские программы нельзя компилировать опциями gcc по умолчанию.
Решение — кросс-компиляция. Нужно под GNU/Linux по среде выполнения AM собрать исполняемый файл, который сможет работать в новой среде $ISA-nemu. Чтобы линковщик ld не линковал способом по умолчанию, нужен ещё скрипт линковки, описывающий среду выполнения $ISA-nemu. Каркас AM уже подготовил соответствующую конфигурацию; опции компиляции и линковки выше в основном в abstract-machine/Makefile и связанных .mk в abstract-machine/scripts/. Процесс сборки программы, которая может работать в среде выполнения NEMU, примерно такой:
- gcc компилирует исходники реализации AM
$ISA-nemuв объектные файлы, затем через ar упаковывает их как библиотеку в архивabstract-machine/am/build/am-$ISA-nemu.a - gcc компилирует исходники приложения (например
am-kernels/tests/cpu-tests/tests/dummy.c) в объектные файлы - через gcc и ar зависящие библиотеки времени выполнения (например
abstract-machine/klib/) тоже компилируют и упаковывают в архив - по указаниям Makefile
abstract-machine/scripts/$ISA-nemu.mkld по скрипту линковкиabstract-machine/scripts/linker.ldсвязывает указанные объектные файлы и архивы в исполняемый файл
По этому скрипту линковки секции исполняемого файла после перемещения начинаются с 0x100000 или 0x80000000 (зависит от _pmem_start и _entry_offset); сначала секция .text, внутри неё сначала пользовательская секция entry из abstract-machine/am/src/$ISA/nemu/start.S, затем .text остальных объектных файлов. Так в начале исполняемого файла всегда код start.S, а не другой код, и гостевая программа всегда сможет корректно начаться с start.S. Скрипт также задаёт порядок линковки других секций (включая .rodata, .data, .bss) и символы с информацией о позициях: конец каждой секции, вершина стека, начало и конец кучи.
Кратко разберём поведение полученного исполняемого файла:
- Первая инструкция начинается с
abstract-machine/am/src/$ISA/nemu/start.S; задав вершину стека, переходят к функции_trm_init()вabstract-machine/am/src/platform/nemu/trm.c. - В
_trm_init()вызываютmain()— основную функцию программы; уmain()ещё есть параметр, сейчас им не пользуемся, представим позже. - После возврата из
main()вызываютhalt()и заканчивают выполнение.
С TRM — простой средой выполнения — на ней легко запускать всевозможные «простые» программы. Разумеется, можно запускать и «непростые»: реализовать сколь угодно сложный алгоритм, даже любые теоретически вычислимые задачи можно решить на TRM.
Прочитать Makefile
Makefile проекта abstract-machine спроектирован очень ловко; их нужно RTFSC как код, чтобы понять, как они работают. Тогда вы будете знать, как писать Makefile определённого качества; и если Makefile вдруг поведёт себя непредвиденно, сможете попробовать его отладить. Конечно, без RTFM не обойтись.
Запускать NEMU в пакетном режиме (batch mode)
Мы знаем: большинство студентов, скорее всего, подумают: всё равно Makefile я не читаю, преподаватель и ассистент не узнают, вроде и не страшно не смотреть.
Поэтому здесь обязательное задание: раньше, запуская NEMU, каждый раз нужно было вручную ввести c, чтобы выполнить гостевую программу. Но если не ради sdb в NEMU, ввод c можно сэкономить. В NEMU реализован пакетный режим: после старта NEMU сразу выполнять гостевую программу. Прочитайте код NEMU и подходяще измените Makefile, чтобы через Makefile AM по умолчанию запускался NEMU в пакетном режиме.
Это обязательное задание всё ещё можно пропустить, но скоро станет менее удобно.
Реализовать часто используемые библиотечные функции
На TRM мы уже запускали немало простых программ, но если писать на TRM чуть сложнее, станет неудобно. Сейчас самая простая среда TRM даёт только кучу и halt(), а привычные библиотечные функции вроде memcpy() не даны. Раз не даны — давайте реализуем.
Раз их зовут библиотечными функциями, ими могут пользоваться многие программы, так что можно, как AM, собрать их в библиотеку. Однако в отличие от AM конкретная реализация этих функций может не зависеть от архитектуры: не как halt() — на NEMU, на CPU, который вы потом напишете на verilog, даже на других архитектурах memcpy() можно реализовать одним способом. Поэтому если реализовывать эти часто используемые функции в AM, появится ненужное дублирование кода.
Хороший подход — разделить среду выполнения на две части: одна — связанная с архитектурой, то есть AM, о котором говорили; другая — не зависящая от архитектуры: часто используемые функции вроде memcpy() относятся сюда. abstract-machine/klib/ собирает эти не зависящие от архитектуры библиотечные функции. klib значит kernel library, даёт базовые функции, совместимые с libc. Каркас перечислил функции, которые могут понадобиться, в abstract-machine/klib/src/string.c и abstract-machine/klib/src/stdio.c, но реализаций не дал.
Реализовать функции обработки строк
По потребности реализуйте функции обработки строк, перечисленные в abstract-machine/klib/src/string.c, чтобы тестовый случай string в cpu-tests успешно работал. Конкретное поведение этих библиотечных функций обязательно RTFM.
Соглашения и неопределённое поведение в компьютерных системах
Повсюду руководства отражают базовый принцип работы компьютерных систем: соблюдать соглашения.
Что будет, если соглашение нарушить? Чаще всего программа не получит верный результат. Например, ваш strcpy() не скопировал завершающий \0 — нарушил соглашение руководства; по соглашению стандарта C вызов этого неверного strcpy() с большой вероятностью даст очень длинную строку назначения. Конечно, рядом с целевой строкой может случайно оказаться море '\0', и повезёт получить верный результат. Короче, что будет при нарушении соглашения, надо разбирать по месту, ясно сказать трудно.
Раз ясно не сказать — тогда и не будем, так появилось понятие неопределённого поведения (UB, Undefined Behavior): пока соглашение соблюдено, у программы гарантированы свойства после соблюдения; если нарушили, не сделали как договорились — корректность поведения не гарантируется.
Компьютерные системы так и работают: интерфейсы между слоями абстракции — тоже соглашение; например, инструкции — интерфейс ПО и железа, поэтому есть руководство ISA, нормирующие поведение каждой инструкции.
- С одной стороны, компилятор должен по соглашениям руководства ISA порождать код, который можно корректно выполнить. Если компилятор порождает код не по руководству, поведение скомпилированной программы неопределено.
- С другой стороны, разработчик железа должен по соглашениям руководства ISA проектировать процессор, корректно выполняющий инструкции. Если процессор выполняет инструкции не по руководству, поведение процессора при выполнении программы неопределено.
У введения неопределённого поведения есть ещё плюс: определённая свобода реализации соглашения. Например, стандарт C говорит: если делитель целочисленного деления — 0, результат неопределён. Инструкция деления x86, обнаружив делитель 0, бросит CPU сигнал исключения. Инструкция деления MIPS проще и грубее: сначала в руководстве набора инструкций MIPS заявлено, что при делителе 0 результат неопределён; затем при реализации схемы делителя на железе деление на 0 можно не замечать. Однако у конкретной схемы делителя, даже если делитель 0, на выходе всё равно какое-то значение — какое именно, уж как получится. Стандарт C и так говорит, что деление на 0 — UB; пусть инструкция деления вернёт что угодно — соглашение стандарта C это не нарушает.
Неопределённое поведение рядом с вами. Например, разыменование дикого указателя — что будет, совершенно непредсказуемо. И часто используемый memcpy(): если исходный и целевой интервалы пересекаются, каким будет поведение? Если вы об этом никогда не думали, стоит man и подумать, почему так. Есть ещё явление, кому радость, кому горе: оптимизации компилятора на основе UB: раз поведение исходного кода неопределено, компилятор на этом может выделывать странные оптимизации — и это тоже не нарушение соглашения. Эта статья приводит примеры причудливых оптимизаций, от которых глаза на лоб; после неё понимание поведения программ обновится.
Поэтому мы и подчёркиваем: нужно научиться RTFM. RTFM — процесс узнать поведение интерфейса и соглашения: что значит каждый вход? Каково конкретное поведение объекта? Что на выходе? Какие ограничения обязательно соблюдать? В каких случаях какие ошибки? Какие поведения — UB? Только полностью поняв и соблюдая их, можно без ошибок пользоваться объектом справки; от принципов проектирования систем до поведения одного memcpy() — везде соглашения и их соблюдение. Понять эти законы — верный путь понять компьютерные системы.
UB, оптимизации компиляции и datalab
Слышали: lab1 большого потока (datalab) однажды развалилась из-за нового gcc в debian10. Потом выяснилось: в эталонном коде datalab было UB переполнения int, gcc Debian 10 использовал это UB для оптимизации, и эталон породил неверные эталонные ответы.
Стандарт C говорит: поведение переполнения int неопределено, но большинство программистов этого соглашения не знает; даже популярные учебники C считают, что результат переполнения int — wrap around. datalab — эксперимент CMU, но и исходный автор написал код с UB, то есть понимание UB у автора тоже неполное. В старых компиляторах эти UB не срабатывали. Но UB есть UB: автор, когда писал код, недостаточно понимал стандарт C.
Эта статья разбирает классификацию и поведение переполнения целых и находит в реальных приложениях массу примеров — рекомендуем прочитать. В статье упомянута широко используемая (включая Office и Windows) библиотека SafeInt против переполнения целых, но в коде самой библиотеки авторы статьи нашли UB из-за переполнения целых: можно сказать, SafeInt is not safe.
Урок этих примеров: нужно писать не только код, проходящий тесты, но и well-defined код, соответствующий спецификации языка. Отступая шаг: люди ошибаются, но хотя бы в момент ошибки нужно знать, что является правильным.
Чтобы запустить тестовый случай hello-str, нужно ещё реализовать библиотечную функцию sprintf(). По сравнению с другими она особая: число параметров переменное. Чтобы получить переменное число параметров, можно использовать макросы библиотеки C stdarg.h; конкретное использование — man stdarg.
Реализовать sprintf
Реализуйте sprintf() в abstract-machine/klib/src/stdio.c; конкретное поведение можно смотреть в man 3 printf. Сейчас достаточно реализовать %s и %d, чтобы пройти тест hello-str; остальные возможности (включая ширину, точность и т.д.) можно реализовать самим, когда понадобятся.
Как реализован stdarg?
В stdarg.h есть макросы получения аргументов вызова функции; их можно считать абстракцией способа передачи аргументов в соглашении о вызовах. Спецификации ABI разных ISA задают разные способы передачи аргументов функций. Если бы эти макросы реализовывали вы, как бы вы их реализовали?
Снова узнать компьютер: компьютер — слой абстракций
В PA1 мы представили микроскопический взгляд на «программу, работающую на компьютере»: программа — конечный автомат. Взгляд конечного автомата с уровня инструкций точно описывает каждую деталь работы программы, но семантика программы при этом теряется. Для простых программ автомат ещё можно нарисовать, для сложных взгляд конечного автомата уже не поможет. Чтобы лучше понять сложные программы, нужен новый ракурс.
Сначала обсудим программы, работающие на TRM, классифицируем их потребности и посмотрим, как наша компьютерная система эти потребности поддерживает.
| TRM | Вычисление | Запрос памяти | Завершение | Печать |
|---|---|---|---|---|
| Среда выполнения | - | malloc()/free() | - | printf() |
| AM API | - | heap | halt() | putch() |
| Интерфейс ISA | инструкции | адресное пространство физической памяти | инструкция nemu_trap | способ I/O |
| Аппаратный модуль | процессор | физическая память | Monitor | последовательный порт |
| Реализация схемой | cpu_exec() | pmem[] | nemu_state | serial_io_handler() |
- Вычисление. Это самая базовая потребность программы, настолько, что она даже не относится к среде выполнения и AM. Весь связанный с вычислениями код (последовательные операторы, ветвления, циклы, вызовы функций и т.д.) компилятор компилирует в функционально эквивалентную последовательность инструкций, в итоге выполняемую на CPU. В NEMU функцию «CPU выполняет инструкции» мы реализуем функцией
cpu_exec(). - Запрос памяти. Некоторым программам нужно динамически запрашивать память во время работы. Подобно libc, klib даёт
malloc()иfree()для динамического управления памятью (вы реализуете их в будущем); они используют APIheapв TRM, чтобы получить начало и конец кучи. Интервалheapопределяется адресным пространством физической памяти пары ISA-платформа. Это пространство соответствует размеру физической памяти; в NEMU это размер большого массиваpmem[]. - Завершение. Обычные программы когда-нибудь заканчиваются; TRM даёт API
halt()для этого. Потребность слишком проста, более сложный интерфейс среде выполнения не нужен. Конкретная реализацияhalt()связана с ISA; мы использовали искусственно добавленную инструкциюnemu_trap. Выполнениеnemu_trapвыведет NEMU из цикла выполнения инструкций CPU обратно в Monitor; это делается установкой переменной состоянияnemu_stateв Monitor. - Печать информации. Вывод — ещё одна базовая потребность программы. Программа может вызвать
printf()в klib для вывода; тот через API TRMputch()выводит символы. У разных пар ISA-платформа разные способы вывода символов; в $ISA-nemuputch()инструкциями I/O пишет символы в последовательный порт, в итоге в NEMU черезserial_io_handler()символы печатаются в терминал. Больше деталей ввода-вывода — в последней части PA2.
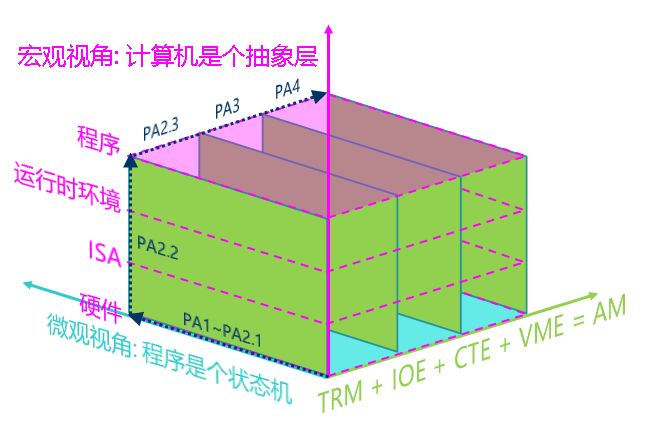
Макроскопический взгляд на «программы, работающие на компьютерах»: компьютер — слой абстракций
В предыдущих PA мы всё время подчёркивали микроскопический взгляд «программа — конечный автомат», чтобы стоять на нижнем уровне и понимать, как работает этот автомат. Теперь наконец можно взглянуть наверх и понять, как компьютер через слои абстракций нижних функций в итоге поддерживает работу программ.
У каждого слоя абстракции есть причина существовать:
- один и тот же по понятию аппаратный модуль реализуют по-разному: процессор — простой интерпретацией в NEMU, высокопроизводительной двоичной трансляцией как в QEMU, или настоящим процессором на языке описания железа вроде verilog.
- ISA — интерфейс, которым железо даёт ПО управлять железом
- API AM абстрагирует интерфейсы разных ISA (x86/mips32/riscv32), скрывая от верхних программ детали, связанные с ISA
- среда выполнения может дальше обернуть API AM и дать программам более удобные функции
Все эти абстракции затем, чтобы удобно писать и запускать самые разные программы на самых разных компьютерных системах. Xian Jian Qi Xia Zhuan, которую вы запустите в PA3, тоже через слои абстракций разлагается в самые базовые операции железа и в итоге работает как конечный автомат.
Что же PA на самом деле делает?
На этом мы представили два самых важных взгляда PA на «программы, работающие на компьютере»:
- микроскопический взгляд: программа — конечный автомат
- макроскопический взгляд: компьютер — слой абстракций
Остальное содержимое PA — по вдохновению AM в порядке истории развития компьютеров добавлять железу новые свойства, усиливать среду выполнения и в итоге запускать всё более сложные программы. PA возьмёт добавление новых свойств как кейс, чтобы снова и снова с этих двух взглядов понимать «как программы работают на компьютере». Конкретно в конце PA2 добавим IOE и реализуем компьютерную систему фон Неймана; в PA3 добавим CTE, чтобы поддержать работу пакетной системы; в последнем PA4 добавим VME и запустим простую и крутую систему разделения времени с многозадачностью.
Здесь даём глобальную концептуальную схему PA («среда выполнения» на схеме включает AM, klib, даже OS и libc); три оси координат на рисунке суммируют три самых важных вывода PA и показывают весь процесс построения компьютерной системы в PA. Делая эксперимент, тоже думайте: на каком слое абстракции сейчас лежит код, который я пишу? Каково конкретное поведение кода?