
F5 Простой процессор с поддержкой суммирования последовательности
С помощью ISA и моделей автомата состояний мы разобрались, как выполняются программы. Кроме того, мы также изучили основы цифровых логических схем. Теперь настало время реализовать CPU с помощью цифровых схем!
Прежде чем приступить, нужно уточнить детали набора команд sISA, который нам предстоит реализовать. По сравнению с предыдущим подразделом, здесь также указана разрядность некоторых регистров:
- Разрядность PC — 8 бит, начальное значение —
0 - GPR — 4 штуки, разрядность каждого — 8 бит
- Поддерживаются следующие 3 инструкции
 7  6 5  4 3   2 1   0
+----+----+-----+-----+
| 00 | rd | rs1 | rs2 | R[rd]=R[rs1]+R[rs2]      инструкция ADD, сложение регистров
+----+----+-----+-----+
| 10 | rd |    imm    | R[rd]=imm               инструкция LI (загрузка непосредственного значения с расширением нулями)
+----+----+-----+-----+
| 11 |   addr   | rs2 | if (R[0]!=R[rs2]) PC=addr инструкция BNER0 (переход, если не равно регистру 0)
+----+----------+-----+
CPU, реализующий набор команд sISA с помощью цифровых схем, мы будем называть sCPU. Чтобы реализовать sCPU, нам нужно реализовать каждое понятие sISA с помощью цифровых схем. Для простоты начнём с самой простой инструкции li, то есть сначала реализуем sCPU, поддерживающий только инструкцию li.
sCPU с единственной инструкцией
Сначала вспомним конкретный процесс выполнения инструкции li с помощью модели автомата состояний ISA. На самом деле, какая бы инструкция ни выполнялась, шаги схожи. Есть понятие «цикл инструкции», которое как раз описывает эти шаги:
- Выборка (Fetch): по текущему PC найти инструкцию в памяти.
- Декодирование (Decode): определить конкретный тип инструкции и её операнды
- Например, для инструкции
liоперанд требует проверить непосредственное значение и определить, в какой регистр-приёмник записывать
- Выполнение (Execute): обработать операнды и при необходимости обновить указанный регистр-приёмник
- Обновление PC (Update PC): установить PC так, чтобы он указывал на следующую инструкцию
Поэтому наша цель — реализовать каждый из этих шагов с помощью цифровых схем.
Выборка
Сначала нужен регистр PC. Вы уже реализовывали регистры с помощью цифровых схем, поэтому реализовать регистр PC несложно. Затем нужно найти инструкцию в памяти по значению PC, поэтому также нужно реализовать память.
И память, и регистры способны хранить информацию, но память также поддерживает адресацию. То есть содержимое памяти расположено по порядку; по заданному адресу память может считать содержимое, соответствующее этому адресу. Память можно рассматривать как матрицу, составленную из битов, где каждая строка матрицы называется словом памяти, адрес — это номер строки, а количество строк называется глубиной памяти. Обычно слово памяти содержит несколько битов данных, и его разрядность называется разрядностью памяти. Характеристики памяти обычно выражаются как глубина x разрядность. Например, память 2x3 устроена следующим образом, где обозначает бит, хранящийся в строке и столбце
| Адрес | Слово памяти |
|---|---|
| 0 | |
| 1 |
По функциональности память можно разделить на ROM (постоянную память, Read-Only Memory) и RAM (оперативную память, Random Access Memory). Первая не поддерживает операции записи, а вторая поддерживает. Для sISA, поскольку ни одна из трёх её инструкций не обращается к памяти (только выборка инструкций требует чтения инструкций из памяти), здесь можно реализовать ROM.
Структура ROM 2x3 показана на рисунке ниже. Дешифратор в левом верхнем углу называется «дешифратором адреса», а провода, подключённые к выходам дешифратора адреса, называются «линиями слова». Каждая линия слова выполняет операцию AND с ячейками памяти в соответствующем слове памяти, а затем результаты элементов AND в одном столбце проходят операцию OR. Провода, подключённые к выходам элементов OR, называются «битовыми линиями». 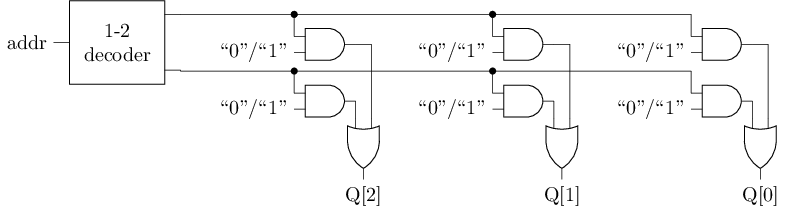
По заданному адресу addr соответствующее слово памяти можно считать из ROM следующим образом: дешифратор адреса преобразует входной адрес в унитарный код. Поскольку в унитарном коде активен только один бит, среди всех линий слова активной становится только линия слова, соответствующая addr. Это позволяет хранимой в этой строке информации пройти через элементы AND. Информация в остальных строках отфильтровывается элементами AND до 0 из-за неактивных линий слова. Затем каждый бит выбранного слова памяти передаётся через элементы OR на битовые линии, выводя данные из памяти наружу.
По функциональности дешифратор адреса, элементы AND и элементы OR на рисунке в совокупности образуют 3-битный мультиплексор «2 в 1». Следовательно, чтение из ROM можно рассматривать как выбор одного слова памяти из нескольких хранимых слов, где адрес addr служит входом выбора мультиплексора, а все слова памяти — его входами данных. Примечательно, что информация, хранящаяся в ROM, напрямую закодирована уровнями напряжения (высокий/низкий), что делает ROM функционально эквивалентным мультиплексору с постоянными входами данных.
Реализуйте функцию выборки инструкций
Реализуйте ROM с помощью мультиплексоров для хранения инструкций суммирования последовательности, а затем извлекайте инструкции с помощью регистра PC. Характеристики ROM вам нужно определить самостоятельно, исходя из вашего понимания.
Декодирование
Цель декодирования — определить функцию инструкции по её кодировке. При выполнении инструкций на автомате состояний ISA мы можем определить их функцию напрямую по представлению на ассемблере (например, li r0, 10) или определить их функцию по двоичному представлению (например, 10001010), сверяясь со спецификацией инструкций. По сути, оба подхода выполняют декодирование инструкции вручную. Теперь нам нужно реализовать этот процесс с помощью аппаратных схем. Поскольку в схеме инструкции хранятся в двоичном виде, декодирование тоже нужно выполнять на уровне двоичных разрядов.
Декодирование инструкции можно дополнительно разделить на декодирование кода операции и декодирование операндов. Декодирование кода операции определяет функцию инструкции по её коду операции, а декодирование операндов извлекает соответствующие операнды из кодировки инструкции. Для декодирования кода операции, поскольку на этом этапе нужно реализовать только инструкцию li, можно считать, что каждая выбранная инструкция — это инструкция li. Для декодирования операндов нужно лишь извлечь поля rd и imm из инструкции li. С точки зрения схемы это просто операции извлечения битовых полей, и реализовать их несложно.
Выполнение
Инструкция li загружает непосредственное значение imm в регистр rd. Следовательно, нам нужно заняться реализацией регистров общего назначения ISA.
Обычно набор GPR содержит несколько регистров, и при каждом обращении затрагиваются только конкретные регистры. Таким образом, GPR должны поддерживать адресацию. Отсюда следует, что схема GPR по сути является запоминающим устройством. Однако, поскольку GPR служат регистрами-приёмниками для записи инструкций, им требуется функциональность памяти с возможностью записи — то есть они являются RAM.
Рассмотрим RAM 2×3, структура операции чтения которой показана на рисунке ниже. Обратите внимание, что за исключением ячеек хранения, реализованных на D-триггерах, остальная структура повторяет структуру ROM. Следовательно, процесс операции чтения RAM можно понимать так же, как описано в разделе про ROM выше. 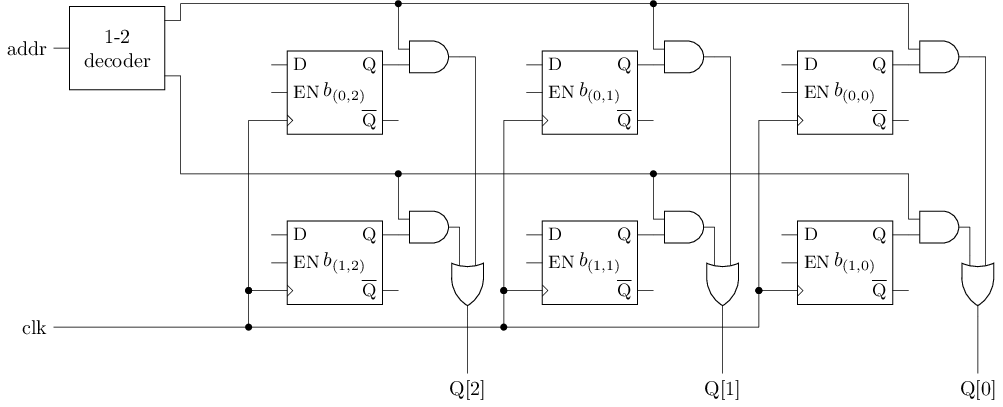
Для операций записи в RAM задействованная структура показана на рисунке ниже. Для выполнения записи требуется не только адрес, но и данные для записи D. Поскольку RAM не всегда нуждается в записи (например, при выполнении инструкции bner0 запись в GPR не нужна), необходим сигнал разрешения записи EN, указывающий, должна ли происходить запись. 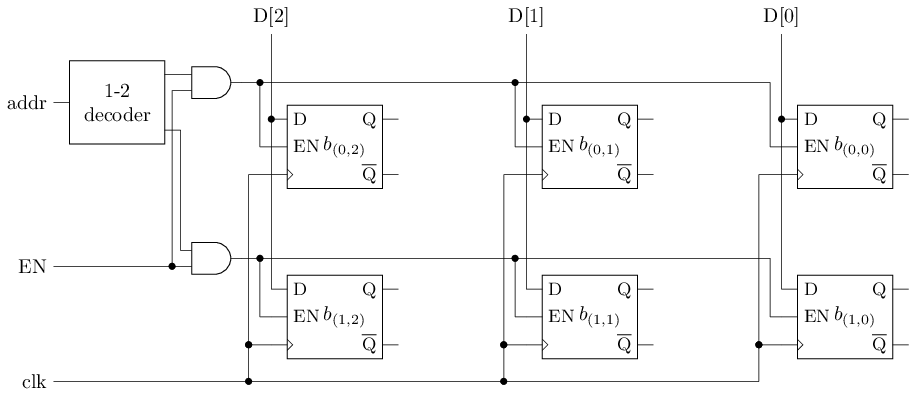
При заданном адресе addr и данных для записи D, когда разрешение записи EN активно, данные D можно записать в соответствующее слово памяти RAM. Процесс происходит так: данные для записи D подключают каждый бит ко входам D всех ячеек памяти в соответствующих битовых позициях через битовые линии. Сигнал разрешения EN фильтрует унитарный код, выдаваемый дешифратором адреса, через элемент AND и подключается к линии слова. Следовательно, когда EN активен, активной становится только линия слова для addr, остальные остаются неактивными. Линия слова каждой строки подключена ко входу разрешения (EN) её ячеек памяти, из-за чего выбранное слово памяти защёлкивает данные для записи D на следующем фронте такта, завершая операцию записи.
Структура RAM, показанная на следующем рисунке, получается объединением структур операций чтения и записи. Такой тип RAM в любой момент времени может обращаться только к одному слову памяти по одному адресу, поэтому его называют «однопортовым RAM». Соответственно, некоторые RAM могут одновременно обращаться к нескольким словам памяти по нескольким адресам — их называют «многопортовыми RAM». Очевидно, что увеличение числа «портов» в RAM требует добавления дополнительной схемной логики, чтобы схемная логика нескольких портов могла работать одновременно. 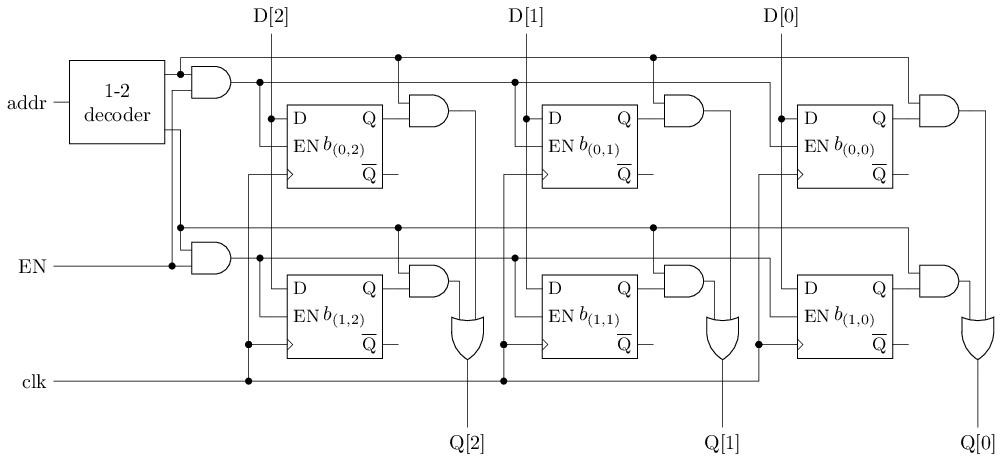
Подобно ROM, дешифратор адреса, элементы AND и элементы OR на пути операции чтения на рисунке в совокупности функционально образуют 3-битный мультиплексор «2 в 1». Поэтому функцию чтения RAM тоже можно рассматривать как мультиплексор с регистрами в качестве входов данных, а функцию записи нужно реализовать дополнительно поверх регистров.
Реализуйте GPR и функцию записи в них
Постройте RAM на основе регистров, чтобы реализовать функцию записи GPR. Характеристики RAM вам нужно определить самостоятельно, исходя из вашего понимания.
Обновление PC
Обновление PC — очень простая операция, которая требует лишь увеличить регистр PC на 1. Это можно реализовать с помощью счётчика в цифровых схемах.
Реализуйте sCPU, поддерживающий только инструкцию li
Опираясь на изложенное выше, реализуйте с помощью цифровых схем каждый компонент, задействованный в цикле инструкции li, и соедините их вместе. После реализации попробуйте заставить sCPU выполнить первые несколько инструкций li из программы суммирования последовательности и понаблюдайте, совпадает ли состояние GPR в схеме с состоянием, заданным ISA.
Реализация полного sCPU
Далее рассмотрим, как реализовать инструкцию add. Поскольку для всех инструкций два шага — выборка инструкции и обновление PC — ведут себя одинаково, мы можем напрямую повторно использовать ранее реализованную логику выборки инструкций.
Для декодирования, поскольку поведение инструкции add отличается от поведения инструкции li, нужно определить, какая инструкция выбрана в данный момент. Для этого нужно проверить поле opcode инструкции: если оно равно 00, это инструкция add; если 10 — это инструкция li. Наиболее подходящая схема для определения значения входа — дешифратор! Поскольку opcode занимает всего 2 бита, можно использовать дешифратор «2 в 4». Выдаваемый им унитарный код может указывать тип текущей инструкции, и такой дешифратор называется дешифратором инструкций. Этот набор унитарных кодов обычно служит управляющими сигналами, управляющими работой части схемы, тем самым поддерживая функции различных инструкций.
Рассмотрев код операции, нужно также учесть операнды. По сравнению с инструкцией li, инструкции add нужно не только записывать в rd, но и читать rs1 и rs2 как исходные операнды, что требует одновременного обращения к GPR через два порта чтения и один порт записи. Поэтому нам также нужно добавить к GPR два порта чтения. После добавления модуль GPR должен содержать как минимум следующие портовые сигналы:
- 1-й порт чтения:
raddr1(адрес чтения),rdata1(данные чтения) - 2-й порт чтения:
raddr2,rdata2 - Порт записи:
waddr(адрес записи),wdata(данные записи),wen(разрешение записи),clk(тактовый сигнал)
После считывания исходных операндов поведение инструкции add заключается в сложении двух чисел и последующей записи результата сложения в регистр rd. Первое можно реализовать с помощью сумматора, но когда второе записывается в GPR, порт wdata GPR уже занят результатом инструкции li. Учитывая уникальность кодировки кода операции инструкции, инструкция не может одновременно быть и инструкцией li, и инструкцией add. Поэтому данные, записываемые в GPR, можно выбирать в зависимости от типа инструкции: если текущая инструкция — add, выбирается результат сумматора; иначе выбирается непосредственное значение инструкции li. Такую функцию выбора можно реализовать с помощью мультиплексора: возьмите два источника данных, записываемых в GPR, как входы данных мультиплексора, а затем подключите соответствующий сигнал из унитарного кода, полученного при декодировании, ко входу выбора мультиплексора. Это позволяет мультиплексору выбирать нужные данные в зависимости от типа инструкции, тем самым реализуя описанную выше функцию.
Добавьте инструкцию add
Опираясь на изложенное выше, добавьте инструкцию add в sCPU. После реализации попробуйте заставить sCPU продолжить выполнение нескольких инструкций add из программы суммирования последовательности и понаблюдайте, совпадает ли состояние GPR в схеме с состоянием, заданным ISA.
Наконец, есть инструкция bner0. Чтобы определить инструкцию bner0, можно повторно использовать функциональность дешифратора инструкций. Что касается операндов, помимо rs2 и addr в инструкции, есть ещё неявный R[0]. Поскольку положение поля rs2 в инструкции bner0 совпадает с положением в инструкции add, можно повторно использовать логику чтения регистра rs2 из инструкции add. Однако bner0 также нужно считать R[0], поэтому 0 можно использовать как вход порта raddr1 GPR. Этот порт уже занят rs1 инструкции add, но этот вопрос аналогично можно решить с помощью мультиплексора.
После считывания исходных операндов инструкции bner0 нужно сравнить, равны ли два числа, что можно реализовать с помощью компаратора. Если результат сравнения — «не равно», PC нужно обновить значением поля addr. Иными словами, только когда текущая инструкция — bner0 и результат сравнения «не равно», PC обновляется значением поля addr; во всех остальных случаях PC должен обновляться значением PC плюс 1. Аналогично, для выбора входа регистра PC можно использовать мультиплексор.
Наконец, инструкция bner0 не выполняет запись в GPR, поэтому wen GPR нужно установить в неактивное значение.
Добавьте инструкцию bner0
Опираясь на изложенное выше, добавьте инструкцию bner0 в sCPU. После реализации попробуйте заставить sCPU выполнить полную программу суммирования последовательности. Если ваша реализация верна, вы должны увидеть, что PC в итоге равен 7, а результат суммирования 55 хранится в некотором GPR
Сравните со схемой суммирования последовательности
При изучении цифровых схем было обязательное задание, требовавшее вычислить результат 1+2+...+10 с помощью регистров и сумматоров. Теперь, когда вы выполнили то же вычисление с помощью sCPU, попробуйте сравнить достоинства и недостатки двух подходов.
Переосмысление CPU
Поздравляем! Это, вероятно, первый реализованный вами CPU! Хотя этот sCPU очень прост, он позволяет нам разглядеть некоторые свойства, которые помогают понять CPU.
Обсуждая ранее, как добавлять инструкции, мы сначала анализировали предполагаемое поведение каждой инструкции, а затем последовательно добавляли необходимые компоненты вдоль направления потока данных, исходя из поведения инструкции. Пути, по которым данные текут в CPU, вместе с соответствующими компонентами на этих путях, называются трактом данных CPU. В рассмотренном выше обсуждении к тракту данных относятся GPR, сумматоры, память, компараторы и т. д.
Когда между несколькими инструкциями возникают конфликты тракта данных, обычно требуется вводить дополнительные схемы, чтобы управлять потоком данных, гарантируя, что каждая инструкция может выполнять операции в соответствии со спецификацией ISA. Эти дополнительные схемы относятся к управляющей логике внутри CPU, а сигналы, определяющие поведение управляющей логики, называются управляющими сигналами. На самом деле, проектирование тракта данных и управляющих сигналов — это именно те два самых важных шага при проектировании CPU.
Мы свели воедино рассмотренную ранее управляющую логику и её предполагаемое поведение при выполнении различных инструкций следующим образом:
| Инструкция | Выбор wdata | wen | Выбор raddr1 | Выбор обновления PC |
|---|---|---|---|---|
add | Выход сумматора | 1 | rs1 инструкции | PC + 1 |
li | Непосредственное значение | 1 | X | PC + 1 |
bner0 | X | 0 | 0 | addr инструкции |
Здесь X обозначает безразличное значение, то есть подходит любой выбор. Например, инструкция bner0 не выполняет запись в GPR, поэтому неважно, что выбрано для wdata, — это не влияет на корректность sCPU. Следует отметить, что эти варианты выбора связаны с типом инструкции; то есть тип инструкции определяет поведение управляющей логики, которая, в свою очередь, определяет направление потока данных в тракте данных и в конечном итоге реализует функцию, заданную инструкцией.
Посмотрите на спроектированный вами в Logisim sCPU: если провести границу по выбранной инструкции и разделить sCPU на левую и правую части, вы обнаружите, что единственная информация, передаваемая из левой части в правую, — это сама инструкция. При этом управляющая логика схемы правой части в конечном счёте управляется унитарным кодом, выдаваемым дешифратором инструкций, а входом дешифратора инструкций служит код операции инструкции. Поэтому можно сказать, что схема правой части полностью управляется инструкцией. Это в точности подтверждает то, что было сказано в предыдущем разделе: «Выполнение программы на CPU = использование скомпилированной из программы последовательности инструкций, чтобы управлять схемой CPU для выполнения переходов состояний».
Наконец, мы углубим понимание инструкций с помощью нескольких обязательных упражнений.
Вычислите сумму нечётных чисел в пределах 10
Напишите последовательность инструкций для вычисления суммы нечётных чисел в пределах 10, то есть 1+3+5+7+9. Затем попробуйте выполнить эту последовательность инструкций на спроектированном вами sCPU и проверьте, соответствует ли результат выполнения ожиданиям.
После выполнения — как вы теперь понимаете идею «хранимой программы» компьютера?
Можно ли спроектировать инструкцию, складывающую 10 чисел?
Упомянутая выше программа суммирования последовательности требует для вычисления результата несколько десятков инструкций. Один из сокурсников предложил, чтобы повысить вычислительную эффективность sCPU, спроектировать инструкцию, складывающую 10 чисел, чтобы 1+2+...+10 можно было вычислить напрямую одной инструкцией. Разумно ли это предложение? Попробуйте привести свои доводы с точки зрения программ, ISA и проектирования схемы CPU.
zxz