引言
- 通过ISA和状态机模型, 你已经了解处理器在概念上如何工作
- 同时你也已经学习了数字逻辑电路的基础知识
现在是时候用数字电路实现一个CPU了!
只有一条指令的CPU
根据ISA规范设计CPU
先明确指令集sISA的细节:
- PC位宽为8位, 初值为
0 - GPR有4个, 位宽均为8位
- 支持如下3条指令
 7  6 5  4 3   2 1   0
+----+----+-----+-----+
| 00 | rd | rs1 | rs2 | R[rd]=R[rs1]+R[rs2]       add指令, 寄存器相加
+----+----+-----+-----+
| 10 | rd |    imm    | R[rd]=imm                 li指令, 装入立即数, 高位补0
+----+----+-----+-----+
| 11 |   addr   | rs2 | if (R[0]!=R[rs2]) PC=addr bner0指令, 若不等于R[0]则跳转
+----+----------+-----+
和之前相比, 还约定了一些寄存器的位宽
将这个用数字电路实现的sISA指令集的CPU称为sCPU
- 先实现只支持
li指令的sCPU
指令周期
回顾在ISA层次执行指令的过程: 无论是执行什么指令, 步骤都是类似的
指令周期(instruction cycle): 执行一条指令的步骤
- 取指(fetch): 根据当前PC, 在存储器中找到一条指令
- 译码(decode): 看这条指令具体是什么指令, 操作数是哪些
- 以
li为例, 操作数需要看立即数是多少, 需要写入哪个目的寄存器
- 以
- 执行(execute): 对操作数进行处理, 必要时更新指定的目的寄存器
- 更新PC: 让PC指向下一条指令
实现CPU = 用数字电路实现上述的每个步骤
取指
- 首先需要一个PC寄存器
- 对应数字电路的寄存器
- 然后需要根据PC在存储器中找到一条指令
- 需要实现存储器
存储器 = 可寻址的存储单元的集合
和寄存器相比, 存储器还支持寻址
- 存储器中的内容按顺序进行排布
- 给出一个地址, 存储器可以读出该地址对应的内容
可将存储器看成一个由比特构成的矩阵
- 每一行是一个存储字(word)
- 地址 = 行编号, 行的数量 = 存储器的深度(depth)
- 一行可存储多位数据, 数据位宽 = 存储器的宽度(width)
通常用深度x宽度表示存储器的规格
- 例: 深度为2, 宽度为3的存储器
| 地址 | 存储字 |
|---|---|
| 0 | \(b_{(0, 2)}b_{(0, 1)}b_{(0, 0)}\) |
| 1 | \(b_{(1, 2)}b_{(1, 1)}b_{(1, 0)}\) |
存储器又分只读存储器(ROM)和随机访问存储器(RAM), 后者可读可写
- sISA的3条指令执行时都不会访问存储器, 只有取指操作需要从存储器中读出指令, 因此可采用ROM
ROM的结构
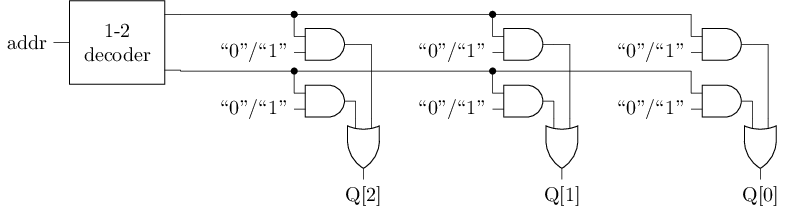
- 左上方的译码器又称
地址译码器
- 和地址译码器输出相连的导线称为
字线(word line)- 每条字线对应一个存储字
- 和或门输出相连的导线称为
位线(bit line)- 每条位线对应存储字的一位
- ROM中存储的信息通过
硬连线方式连接到逻辑0或逻辑1
ROM的工作原理
给定地址addr, 读出ROM中相应存储字的工作过程如下:
- 地址译码器将输入的地址转换成一组独热码
- 由于独热码中只有一位有效, 故只有地址
addr对应的字线有效, 使得该行中存放的信息可以通过与门- 其余行因字线无效, 存放的信息均被与门过滤为
0
- 其余行因字线无效, 存放的信息均被与门过滤为
- 被选中的存储字的每一位经过或门传输到位线, 向存储器外部输出
从另一个角度理解ROM
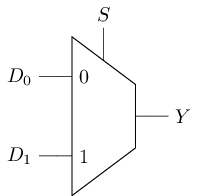
地址译码器, 与门和或门, 在功能上共同构成了一个多路选择器
ROM的读操作也可以看作是从多个存储字中选择一个
- 地址
addr相当于多路选择器的选择端 - 所有存储字相当于多路选择器的数据端
ROM从功能上也可看作是数据端为常数的多路选择器
译码
译码: 根据指令的编码识别指令的功能
- 在ISA的状态机上执行指令时, 本质上是属于人工进行译码操作
- 通过指令的汇编表示直接识别其功能, 如
li r0, 10 - 或给出指令的二进制表示, 如
10001010, 查阅指令表了解其功能
- 通过指令的汇编表示直接识别其功能, 如
- 现在需要用电路来实现这一操作
- 需要在二进制层面对指令进行译码
译码的工作进一步分为操作码译码和操作数译码
- 操作码译码: 根据指令的操作码来识别指令的功能
- 目前只需要实现一条
li指令, 无需进行
- 目前只需要实现一条
- 操作数译码: 从指令的编码中识别出相应的操作数
- 只需要解析出
li指令中的rd和imm字段- 一些电路层次上的位抽取操作
- 只需要解析出
执行
li指令的功能:
将立即数imm写入rd寄存器中
- 需要考虑如何实现ISA的GPR
GPR通常包含多个寄存器, 一次访问通常只访问其中的几个寄存器
- GPR需要支持寻址
- GPR的电路本质也是一个存储器
- 不过GPR需要作为目的寄存器被指令写入
- 是一个支持写入的存储器, 即RAM
RAM的读操作
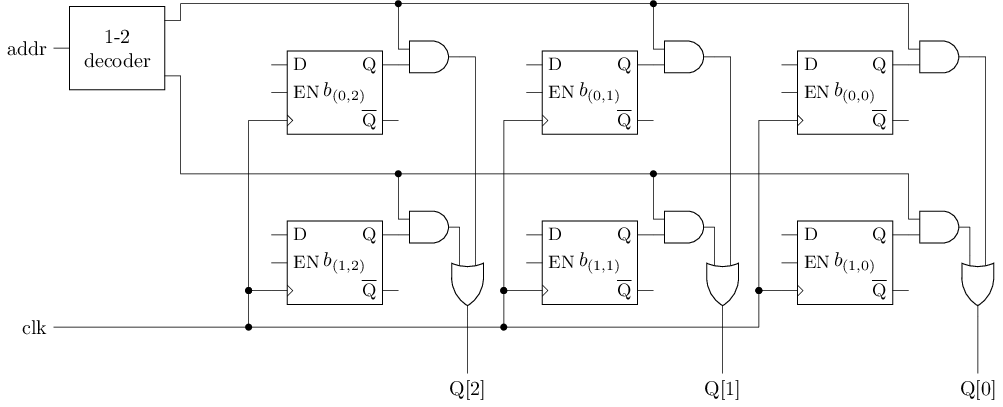
- 存储单元采用带使能端的D触发器搭建
- 给定地址
addr, 读出存储器中的相应内容- 工作原理和ROM类似
RAM的写操作相关的结构
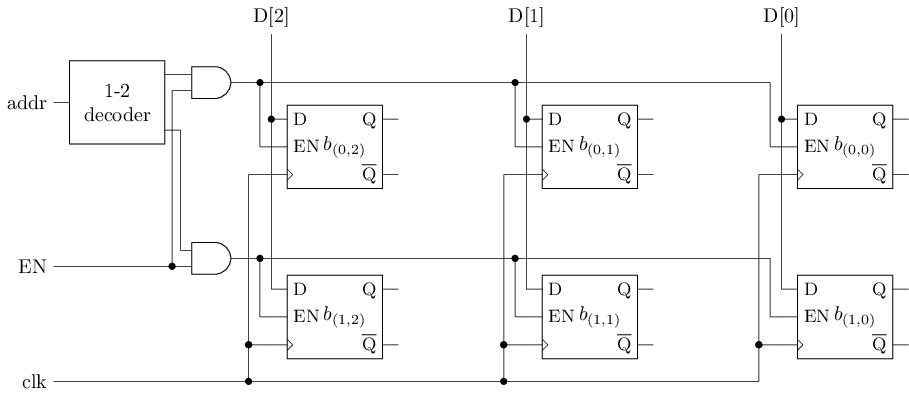
- 给定地址
addr和数据D, 将数据D写入存储器中的相应位置
- 并非所有时刻都需要进行写入操作, 还需要一个写使能信号
EN, 指示当前是否需要写入- 在执行
bner0指令时, 就不需要写入GPR
- 在执行
写入RAM的工作原理
- 数据
D通过位线将每一位分别连接到每一个存储字中相应位的D端
- 将每一行的字线分别连接到对应存储器中相应的
EN端EN有效时, 只有地址addr对应的字线有效, 其余行无效
- 被字线选中的存储字将更新为数据
D, 从而完成写入操作
RAM的完整结构
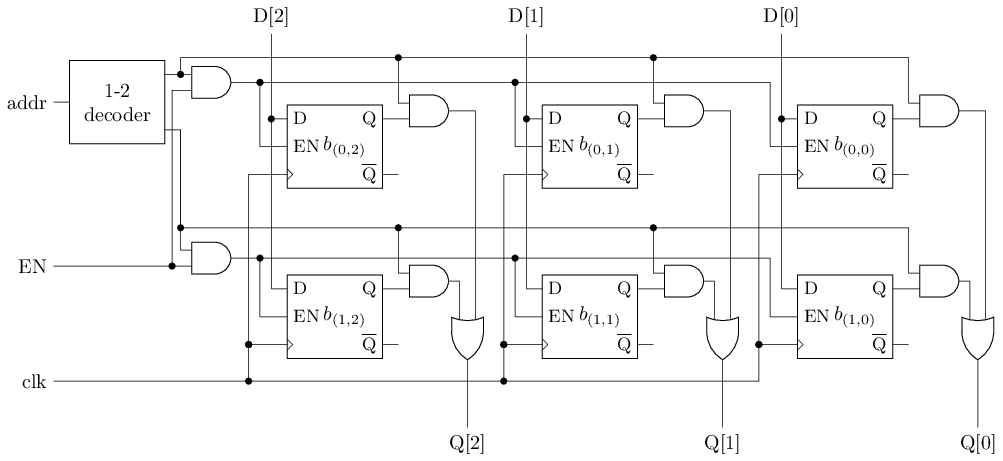
单端口RAM(single port RAM): 同一时刻只用一个地址访问一个存储字多端口RAM(multi-port RAM): 同一时刻可用多个地址访问多个存储字- 多端口RAM的多个端口可以同时工作, 需要添加额外的电路逻辑
更新PC
对PC寄存器加1即可
- 可通过数字电路中的计数器来实现
实现完整的sCPU
添加add指令
取指 - 和li一样
操作码译码
- 需要检查指令的
opcode来确定是什么指令 - 识别输入的取值 - 用n选1译码器!
opcode有2位, 用2-4译码器- 输出的独热码可以指示当前指令类型,
这种译码器称为
指令译码器 - 这组独热码通常作为控制信号, 控制CPU中的其他电路如何工作
- 输出的独热码可以指示当前指令类型,
这种译码器称为
操作数译码
add指令除了写入rd寄存器, 还需要读出rs1和rs2作为源操作数
- 需要为GPR添加两个读端口, 添加后GPR有以下信号
- 第1个读端口:
raddr1(读地址),rdata1(读数据) - 第2个读端口:
raddr2,rdata2 - 写端口:
waddr(写地址),wdata(写数据),wen(写使能),clk(时钟)
- 第1个读端口:
添加add指令(2)
执行
- 用加法器实现加法操作
- 写入GPR时,
wdata信号已经被li指令占用- 由于
opcode编码的唯一性, 一条指令不可能既是li, 又是add - 可以采用多路选择器, 根据指令的类别选择写入GPR的数据
- 当前是
add指令, 就选择加法器的结果作为写入数据 - 当前是
li指令, 就选择li指令的立即数作为写入数据
- 当前是
- 由于
更新PC - 和li一样
添加bner0指令
取指 - 和li一样
操作码译码 - 可复用指令译码器
操作数译码
- 除了指令中的
rs2和addr, 还有一个隐含的R[0]- 把
0作为GPR的raddr1的输入
- 把
- 不过这个信号已经被
add指令的rs1占用- 同样可以通过多路选择器解决问题
执行 - 用比较器实现比较两数是否相等的操作
更新PC - 若比较结果不相等, 则跳转
- 当前指令为
bner0, 且比较结果不相等, 则将PC更新为addr - 否则, 将PC更新为
PC+1
- 同样可以通过多路选择器来实现
重新审视CPU设计
添加指令的过程:
- 分析指令的预期行为
- 然后根据指令的行为, 在数据流动的方向上依次添加所需的部件
- 数据在CPU中流动的路径和路径上的相关部件, 称为CPU的数据通路(data
path)
- 包括GPR, 加法器, 存储器, 比较器等
- 数据在CPU中流动的路径和路径上的相关部件, 称为CPU的数据通路(data
path)
- 当多条指令的数据通路出现冲突时, 需要引入一些额外的电路,
来控制数据如何流动
- 使得每条指令都能完成符合ISA规范的操作
- 这些额外的电路属于CPU中的控制逻辑
- 决定控制逻辑行为的信号称为控制信号
控制信号的设计
| 指令 | wdata的选择 |
wen |
raddr1的选择 |
更新PC的选择 |
|---|---|---|---|---|
add |
加法器的输出 | 1 |
指令的rs1 |
PC + 1 |
li |
立即数 | 1 |
X |
PC + 1 |
bner0 |
X |
0 |
0 |
指令的addr |
X表示无关项(don’t care), 选择什么都可以
bner0指令不会写入GPR- 无论
wdata选择什么, 都不影响sCPU的正确性
- 无论
这些控制信号的取值与指令的类型相关
- 指令的类型决定了控制逻辑的行为
- 从而决定了数据通路中数据的流向, 最终完成指令约定的功能
从控制信号看CPU工作原理
  +-------------------------------------------------------------+
  |                 |               +---------------> +-----+   |
  V                 |               |            +--> | Cmp | --+
+----+     +-----+  |  +---------+  |   +-----+  |    +-----+
| PC | --> | ROM | --> | Decoder | -+-> | GPR | -+
+----+     +-----+  |  +---------+  |   +-----+  |    +-----+
               instruction          |     ^ ^    +--> | Add | --+
                    |               |     | |         +-----+   |
             left   |   right       +-----+ +-------------------+
一个观察: 把取出的指令作为边界, 将sCPU划分为左右两侧
- 左侧向右侧传递的信息只有指令
- 右侧电路唯一的输入就是指令, 完全受到指令的控制
- 指令译码器的输入就是指令的操作码, 输出是显影的独热码
- 这些独热码最终将控制CPU中的所有控制逻辑
结论: 在CPU上执行程序 = 用程序编译出的指令序列控制CPU电路进行状态转移
sISA v2.0
sISA的局限性
sCPU已经可以计算1+2+...+10
但由于sISA的局限性, 很难运行更复杂的程序
- PC寄存器的位宽只有8位, 因此程序最多只能包含256条指令
- GPR只有4个, 因此程序最多同时存在4个使用中的变量
li指令只能装入0~15的立即数- 如果要装入大常数,
需要利用多条
li指令和add指令进行累加 - 要装入
192, 就要通过类似以下的指令序列来完成
- 如果要装入大常数,
需要利用多条
bner0指令的跳转目标范围只有0~15
sISA的扩展
为了缓解上述问题,
可以对li和bner0的功能进行增强
 7  6 5  4 3   2 1   0
+----+----+-----+-----+
| 10 | rd |  s  | imm | R[rd]=imm << (s << 1)
+----+----+-----+-----+
| 11 |  offset  | rs2 | if (R[0]!=R[rs2]) PC=PC+sign_ext(offset)
+----+----------+-----+li指令通过s和imm的组合来表示一个更大的立即数
<<表示左移运算符
- 从另一个角度来理解 -
s表示将2位的imm放置在8位数据中的哪一段位置
 7   6 5   4 3    2 1   0
+-----+-----+-----+-----+
| 00  | 00  | 00  | imm | s=00
+-----+-----+-----+-----+
| 00  | 00  | imm | 00  | s=01
+-----+-----+-----+-----+
| 00  | imm | 00  | 00  | s=10
+-----+-----+-----+-----+
| imm | 00  | 00  | 00  | s=11
+-----+-----+-----+-----+装入192 = 0b11000000
sISA的扩展(2)
为了缓解上述问题,
可以对li和bner0的功能进行增强
 7  6 5  4 3   2 1   0
+----+----+-----+-----+
| 10 | rd |  s  | imm | R[rd]=imm << (s << 1)
+----+----+-----+-----+
| 11 |  offset  | rs2 | if (R[0]!=R[rs2]) PC=PC+sign_ext(offset)
+----+----------+-----+bner0通过offset字段来表示跳转目标相对于PC的偏移量
- 从而支持跳转到当前PC值附近的位置
- 跳转目标的可能范围比之前大了
- 同时,
offset字段可以表示负数- 可以跳转到相对于当前PC值
-8~+7范围内的位置
- 可以跳转到相对于当前PC值
实现新版li指令
取指, 操作码译码, 执行, 更新PC, 都和之前相同
- 需要考虑操作数译码的变化
- 将
s字段看成一个选择信号, 来从4种立即数当中选择一种- 每一种立即数对应了将
imm放置在某一段位置的情况
- 每一种立即数对应了将
- 使用多路选择器即可实现
实现新版bner0指令
 7  6 5  4 3   2 1   0
+----+----------+-----+
| 11 |  offset  | rs2 | if (R[0]!=R[rs2]) PC=PC+sign_ext(offset)
+----+----------+-----+- 为了得到跳转目标, 还需要将PC值与
offset字段相加- 可通过加法器实现
- 考虑到跳转时, 并不需要计算
PC+1- 因此可以考虑让跳转目标的计算复用这个加法器
- 但为了复用它, 需要考虑如何添加额外的控制信号
实现新版bner0指令(2)
 7  6 5  4 3   2 1   0
+----+----------+-----+
| 11 |  offset  | rs2 | if (R[0]!=R[rs2]) PC=PC+sign_ext(offset)
+----+----------+-----+- PC寄存器有8位, 而
offset字段只有4位- 因此在进行加法之前,
要先将
offset扩展成与PC位宽一致的数据
- 因此在进行加法之前,
要先将
扩展方式通常有两种
- 零扩展(zero-extend), 总是在高位添加0
li指令要求对立即数进行零扩展
- 符号扩展(sign-extend), 在高位添加补码的符号位
由于offset字段要支持负数, 因此需要采用补码表示
- 但对于负数, 零扩展前后, 补码的真值会发生变化
0b1111(-1)进行零扩展后, 得到0b01111(15)
- 为了保证扩展后
offset的真值不变, 需要进行符号扩展
证明: 符号扩展前后, 补码的真值保持一致
假设有\(k\)位二进制数\(A=\mathrm{0b}a_{k-1}a_{k-2}\dots a_1a_0\)
将其符号扩展至\(k+1\)位, 得到\(A^\prime=\mathrm{0b}a_{k-1}a_{k-1}a_{k-2}\dots a_1a_0\)
- 若\(a_{k-1}=0\), 扩展前后的真值显然一致
- 若\(a_{k-1}=1\), 按补码方式加权展开, 有
\[\begin{array}{ll} A^\prime&=\displaystyle -2^{k}+\sum_{i=0}^{k-1}2^ia_i=-2^k+2^{k-1}a_{k-1}+\sum_{i=0}^{k-2}2^ia_i \\ &=\displaystyle -2^k+2^{k-1}+\sum_{i=0}^{k-2}2^ia_i=-2^{k-1}+\sum_{i=0}^{k-2}2^ia_i=A \\ \end{array}\]
- 易见\(k=2\)时, 上述结论成立
- 根据数学归纳法, 可证命题成立
简易输入输出
让sCPU支持输入输出
之前要检查sCPU运行数列求和程序的结果, 就要直接观察寄存器的值
- 但在真实的处理器芯片中, 我们很难直接观察芯片内部的状态
- 事实上, 用户通常是通过输入输出方式与处理器芯片进行交互
sISA的操作码还有一个槽位
- 添加一条新指令
io, 来让sCPU支持输入输出功能
 7  6 5  4 3   2 1   0
+----+----+---+-------+
| 01 | rd |i/o|  idx  | R[rd]<=>dev[idx]
+----+----+---+-------+io指令根据方向位i/o进行输入或输出:
- 当
i/o=0时, 表示输入操作- 从编号为
idx的设备中读出8位数据, 输入到R[rd]中
- 从编号为
- 当
i/o=1时, 表示输出操作- 将
R[rd]中的8位数据, 输出到编号为idx的设备中
- 将
io指令的实现
讨论输入输出的数据通路:
- 使用
io指令输出时, 需要将指令中的rd字段作为源寄存器的编号读出
- 针对这种情况专门为GPR增加一个读端口(如添加
raddr3和rdata3)并不值得
- 观察:
io指令并不使用rs1字段和rs2字段来访问GPR
- 可以复用GPR已有的读端口
- 通过添加正确的控制信号,
来选择指令中的
rd字段作为GPR其中一个读端口的地址
- 通过添加正确的控制信号,
来选择指令中的
- 使用
io指令输入时, 需要将相应设备的值写入到rd寄存器中
- 添加正确的控制信号来选择GPR的
wdata和wen即可
设备的关联
idx有3位, 每种方向可分别关联8种设备
- 具体关联到什么设备, sISA不负责定义, 由sCPU的实现来决定
- 编号
idx相同时, 输入和输出可以关联不同的设备(也可以相同)
sCPU对设备编号作如下关联:
i/o位 |
设备编号idx |
含义 |
|---|---|---|
1 |
0b000 |
输出到LED |
1 |
0b001 |
输出到七段数码管 |
0 |
0b000 |
从拨码开关输入 |
0 |
0b001 |
从按钮输入 |
通常不会从LED输入, 也不会输出到拨码开关
- 可以让它们复用同一个设备编号
0b000
设备状态的考量
对于输出设备,
我们希望输出设备的状态在执行io指令后保持不变
- 但是,
假设直接将
io指令中指定的GPR连接到LED中- 当下次GPR中存放的值改变时, 即使没有执行
io指令, LED的亮灭状态也会随之改变
- 当下次GPR中存放的值改变时, 即使没有执行
- 需要为输出设备额外添加一个输出数据寄存器
- 一方面, 让这个输出数据寄存器的输出端与输出设备连接
- 另一方面, 让
io指令将数据写入到这个输出数据寄存器- 输出数据寄存器的值可以保持不变, 从而保持输出设备的状态
输入设备的状态是用户设置的, 不会受到处理器内部状态的影响
- 因此无需为输入设备添加寄存器来暂存其状态
程序和设备
还需要编写程序, 把设备的功能用起来

- 升级数列求和程序, 支持单步求和功能
- 程序从拨码开关中读出数列的末项
- 当前循环的项输出到LED
- 当前循环的求和结果输出到七段数码管
- 按钮来控制循环的进度
- 仅当每次按下表示最低位的按钮时, 程序才进入下一次循环
- 密码锁, 交通灯, 电子骰子, 自动售货机…
迈向现代化的处理器设计
Logisim的缺陷1 - 设计繁琐
- 拖动组件和连线确实有设计电路的感觉
- 但当设计的规模增加后, 这些操作将会变得繁琐
- sCPU只有4条指令
- 功能相对完整的处理器通常由数十条指令
- 要实现一个可以启动现代操作系统的处理器, 需要实现上百条指令
- 现代的Intel和ARM这些成熟的商业处理器, 需要支持上千条指令
- 光是ISA手册就有几千页
- 芯片的晶体管数量更是到达几百亿的量级
Logisim的缺陷2 - 仿真速度慢
- Logisim的仿真效率本身就不高
- 随着设计规模变得复杂, 仿真速度也会因为组件数量增多而越来越慢
- 对于程序的同一个功能
- 当ISA提供指令的种类较少时, 程序通常使用更多指令来实现
- 执行效率将会降低数倍甚至数十倍
Logisim的缺陷3 - 调试困难
只要在设计过程中不小心连错了一根线, 处理器运行程序的结果就可能不符合预期
- 如果程序规模不大, 还能逐条指令地检查处理器的执行状态是否与ISA的状态一致
- 当程序需要执行成千上万条指令时
- 要找到哪一条指令的执行不符合预期, 是非常困难的
- 如果要运行类似游戏这种真实应用, 执行的指令数量将会是一个天文数字!
- 而要在这么多的指令中找到错误, 简直比大海捞针还难!
现代的处理器设计方式
这些缺陷说明, 使用Logisim这种手工连线的方式设计处理器, 并不是一种扩展性良好的方案
事实上, 现代的处理器设计流程主要采用代码开发的方式
- 通过硬件描述语言(Hardware Description Language, HDL)描述硬件组件之间如何连接, 来给出处理器的逻辑结构
- 完成代码开发后, 需要通过仿真工具来检查代码所给出的逻辑结构是否符合预期
- 还需要通过EDA工具将代码转变成版图
- 就像编译器将C代码转变成指令序列
现代的处理器设计流程
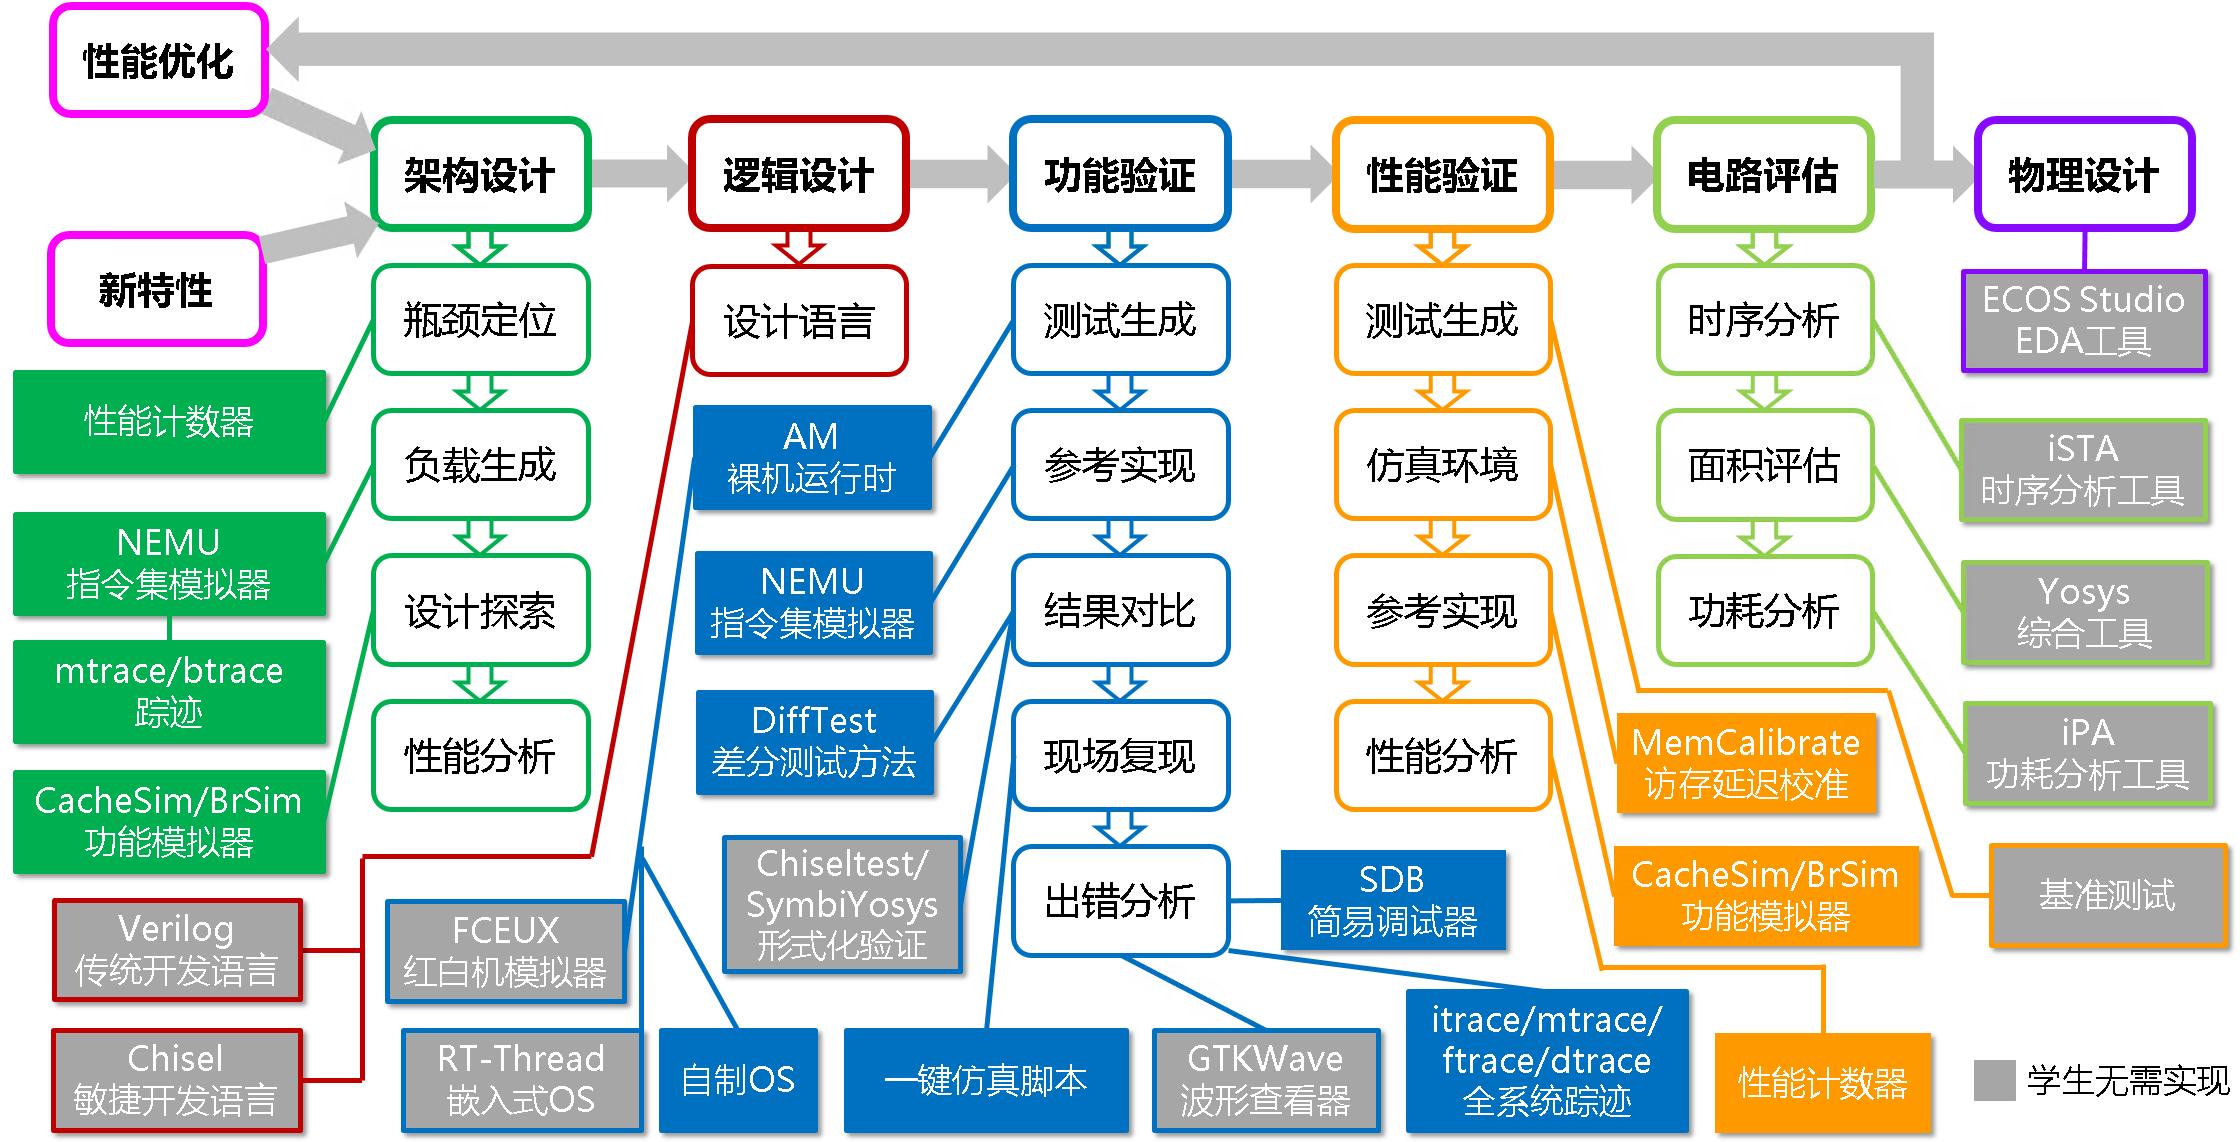
现代的处理器设计流程(2)
在现代处理器设计流程中需要解决的一部分问题:
- 架构设计: 给定一个新特性, 如何给出一个设计方案,
将其分解成合适的硬件模块来实现它?
- 可能是添加新指令等来自ISA规范的功能
- 也可能是处理器层次上的功能优化方案
- 逻辑设计: 有了设计方案, 如何通过HDL在电路层次将设计方案中的硬件模块实现出来?
- 功能验证: 如何验证HDL所描述的电路满足新特性所期望的功能?
- 性能验证: 如何保证处理器的性能符合预期?
- 电路评估: 如何评估并优化处理器的频率, 面积和功耗等指标?
- 物理设计: 如何将HDL代码转变成可流片的版图?
- 性能优化: 如何发现并定位处理器中性能瓶颈, 并设计出相应的优化方案?
处理器设计 != HDL编码
HDL编码只是逻辑设计一个环节的工作
- 整个流程有非常多环节
事实上, 处理器设计的过程中的很多环节都与软件相关, 因为:
- 处理器离开了软件就无法工作
- 处理器的工作就是不断执行指令, 这些指令就是软件
- 要评估一个处理器, 就是看软件在这个处理器上运行得对不对, 运行得好不好
需要理解程序如何在处理器上运行:
- C语言是如何生成目标ISA的指令序列的?
- 如何用C语言开发一个能使用设备进行输入输出的程序?
- 如何开发更多的程序在处理器上运行?
处理器设计 != HDL编码(2)
- 要完成处理器设计流程的各步骤, 就需要各种工具和基础设施的支撑
- 而这些工具和基础设施的本质也是软件
- 尤其是那些与处理器功能紧密相关的工具,
它们对相关步骤的开展起着重要的作用
- 如指令集模拟器, 功能模拟器, 差分测试方法等
- HDL代码虽然描述的对象是硬件, 但它本身作为代码, 也是一种软件
- 既然是代码, 就需要使用合适的软件技术对其进行管理, 维护, 测试, 评估和优化
- 尤其是随着代码规模的增大, 这些问题也会显得越来越重要
- 软件工程领域已经针对这些问题研究数十年, 有很多可以借鉴的地方
要设计出一个好的处理器, 就需要重视软件在其中发挥的作用
总结
处理器设计
- 处理器设计 = 用数字电路实现指令周期
- 取指, 译码, 执行, 更新PC
- 实现指令的过程
- 分析指令的预期行为
- 设计数据通路, 添加相关部件(GPR, 加法器, 存储器, 比较器等)
- 设计控制信号, 用于控制使能信号和多路选择器的选择信号
- 最终使得每条指令都能完成符合ISA规范的操作
CPU执行程序 = 用程序编译出的指令序列控制CPU电路进行状态转移
纸上得来终觉浅, 绝知此事要躬行